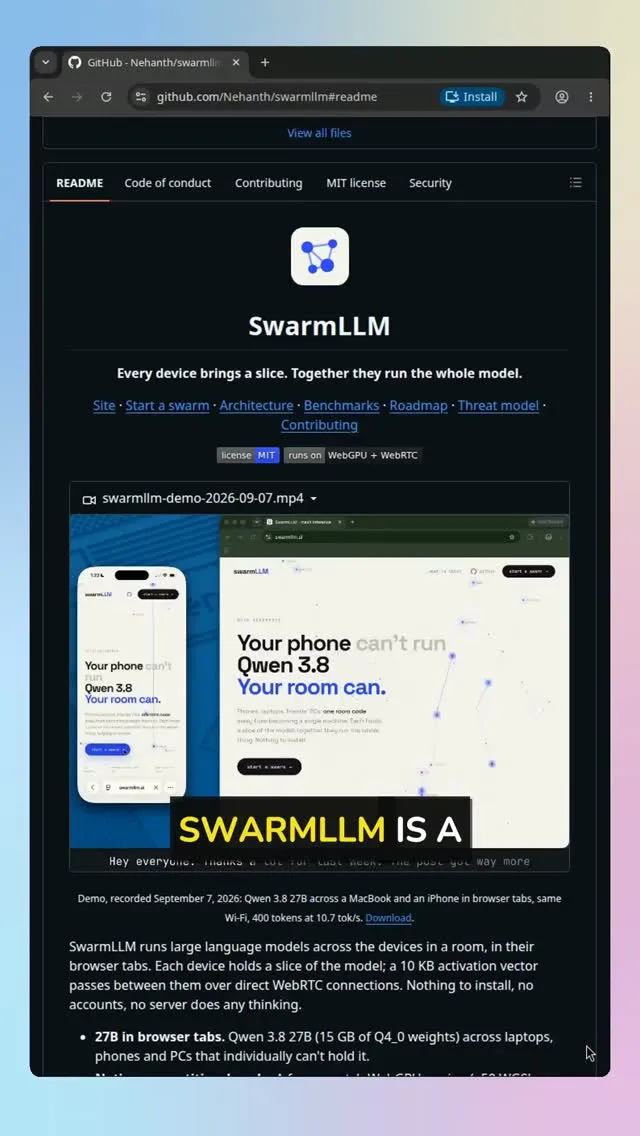
폰과 노트북을 묶어 27B를 돌린 SwarmLLM
한 줄 요약: SwarmLLM은 방 안의 기기들 브라우저 탭에 27B 모델을 층별로 나눠 담고, WebRTC로 10KB 활성 벡터만 주고받아 한 대처럼 구동하는 오픈소스 프로젝트예요. 설치도, 계정도, 서버도 없어요.
gittrend.io 계정의 릴스가 이런 장면을 보여 줘요. 맥북과 아이폰의 브라우저 탭을 나란히 놓고, 두 기기를 합쳐 27B 모델을 돌려 400토큰을 초당 10.7토큰으로 뽑아 내는 데모예요. 프로젝트 이름은 SwarmLLM, 깃허브에 공개된 오픈소스예요. 2026년 9월 1일 저장소가 만들어진 지 3주도 안 돼 스타 383개를 받았고, 라이선스는 MIT예요. 반응은 스크린샷 기준 좋아요 1,229개에 댓글 120개예요. 표지 문장이 취지를 요약해요. “기기마다 조각을 가져온다. 함께면 모델 전체를 돌린다.”
한 대로는 안 되는 이유
먼저 문제의 크기부터 봅시다. 이 데모가 돌린 모델은 Qwen 3.8 27B인데, 4bit로 압축해도 가중치(모델의 학습 결과물)가 15GB예요. 스마트폰 RAM은 보통 8~12GB, 노트북도 16GB면 빠듯하죠. 한 대에 담는 순간 실패해요. 그래서 이 프로젝트의 발상은 ’더 좋은 기기를 사라’가 아니라 방 안에 이미 있는 기기를 전부 합치자예요.
모델을 층으로 쪼개 나눠요
SwarmLLM이 실제로 나누는 것은 모델의 층(레이어)이에요. 27B 모델은 64개 층으로 되어 있는데, 이걸 방 안의 기기 수만큼 나눠 각자 담아요. 공개된 아키텍처 다이어그램은 세 대로 나눈 예시를 보여 줘요. 호스트가 마지막 토큰을 임베딩해 숫자 묶음(히든 스테이트, 5,120개 부동소수점)을 만들면, 약 10KB짜리 이 묶음이 WebRTC 직접 연결로 기기 사이를 이동해요. peer A는 0~21층, peer B는 22~42층, peer C는 43~63층을 각자의 GPU로 계산하고, 결과가 호스트로 돌아와 다음 토큰을 뽑아 내요. 각 기기는 자기 몫의 레이어만 다운로드하고 캐시해 둬요.
10KB만 오가는 이유
여기서 중요한 물리 상식 하나가 등장해요. 토큰 하나를 만드는 일은 메모리가 병목이에요. 매 토큰마다 가중치 전체를 한 번씩 읽어야 하거든요. 그래서 프로젝트의 공은 두 가지로 나뉘요. 엔진은 ’적게 읽기’에 집중해요. 4bit 블록에 f16 스케일을 얹은 형식으로 저장하고, 64개 스레드가 한 행을 함께 훑으며 레지스터에서 압축을 풀고 공유 메모리에서 합산해, 토큰 하나당 GPU 명령 제출을 한 번으로 줄이에요. 런타임은 ’왕복당 더 많이 나르기’에 집중해요. 문장 읽기(프리필)는 한 왕복에 16토큰을 묶어 보내고, 답 생성은 추측 디코딩으로 초안 토큰을 여러 개 체인처럼 달아 둬요. 틀리면 정확히 되돌리는 방식이라 결과 스트림은 평범한 디코딩과 비트까지 동일하게 유지돼요.
성능이 이 접근의 증거예요. 처음부터 직접 짠 WebGPU 엔진(약 50개 WGSL 커널)이 GB10 칩에서 평범한 디코딩으로 초당 9.0토큰, 추측 디코딩을 얹으면 16토큰까지 올라가는데, 같은 파일과 GPU에서 네이티브 llama.cpp는 8.0토큰이었어요. 브라우저가 네이티브를 이겼다는 게 이 프로젝트의 실증 포인트예요.
설치도 계정도 서버도 없어요
사용법은 이 프로젝트에서 가장 놀라운 부분이에요. swarmllm.ai/room을 열고 방을 만들고, 코드를 공유하고, 모델을 고르면 끝이에요. 방에 들어온 각 기기는 자기 몫의 레이어만 내려받아요(다음을 위해 캐시). 설치할 것도, 가입할 것도 없고, 중간에서 연산하는 서버도 없어요. 로컬에서 돌리고 싶으면 저장소를 클론해 아무 정적 서버로 열면 돼요.
방 안에만 머무는 프라이버시
프라이버시 얘기도 정직해요. 방은 하나의 공유 대화예요. 방에 있는 사람들은 질문과 답을 모두 볼 수 있고, 이건 설계대로인 거예요. 서버가 없으니 서버가 엿볼 일은 없지만, 공개 문서는 한 가지를 더 짚어요. 기기들이 주고받는 중간 활성값은 결정적인 공격자 앞에서는 비공개라고 할 수 없다고요. 무엇이 안전하고 무엇이 아닌지 스스로 문서로 밝히는 태도는 신뢰 포인트예요.
어제의 Swiftlet, 오늘의 SwarmLLM
앞서 정리한 Swiftlet과 이 프로젝트를 나란히 놓으면 그림이 완성돼요. Swiftlet은 한 기기 안에서 모델 조각을 시간축으로 스트리밍했어요. SSD에서 필요한 전문가만 불러 오는 방식이었죠. SwarmLLM은 같은 상한을 공간축으로 풀어요. 모델을 쪼개 여러 기기에 상주시키는 방식이에요. 공통 분모는 명확해요. 기기 한 대의 RAM 용량이 더 이상 돌릴 수 있는 모델의 상한이 아니에요라는 것. 통합 메모리 이야기까지 포함하면, ’큰 모델을 큰 기기에’라는 공식이 ’모델을 쪼개 존재하는 기기에 나눠 싣는다’로 바뀌고 있는 셈이에요. 다음에 방 안의 기기들을 보면, 그것들이 사실상 하나의 작은 클러스터라는 생각이 들 거예요. 댓글에 뭘 달 필요도 없어요. 방 만들기 버튼이 곧 시작이에요.
이 글의 내용은 아래 자료를 기준으로 확인했어요.