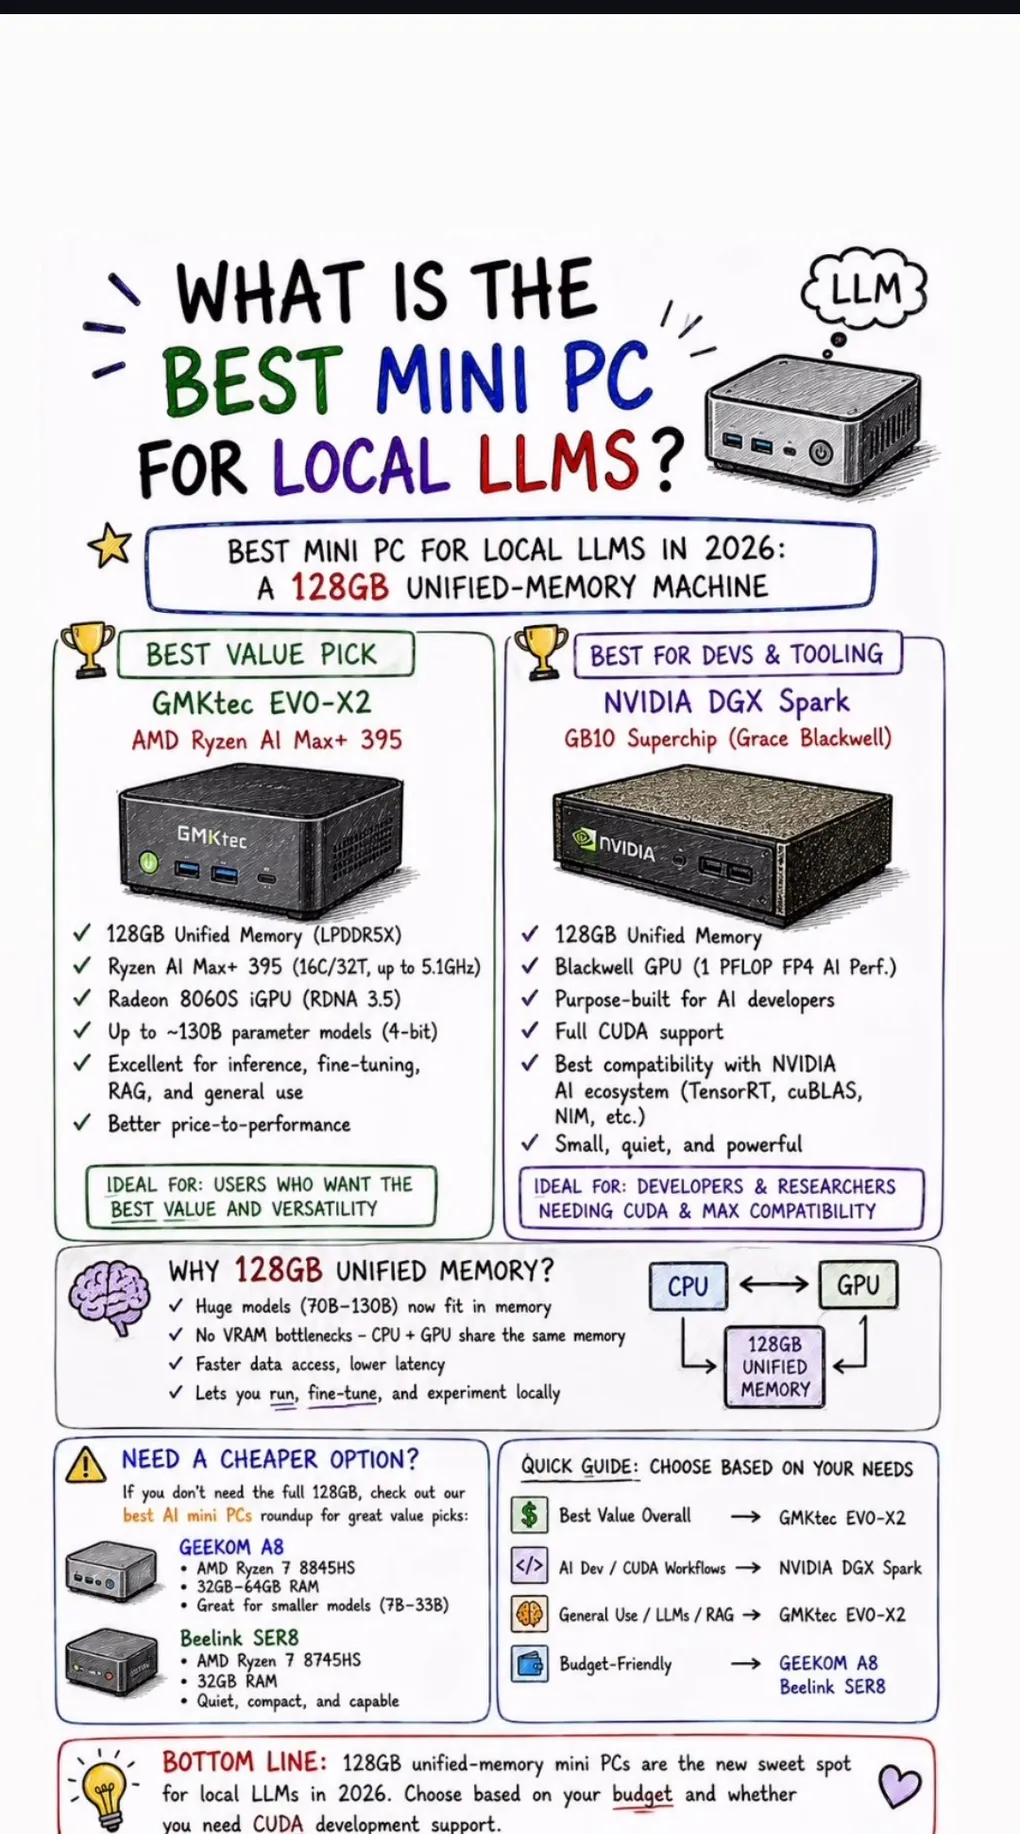
[릴스 해설] 로컬 LLM 미니 PC는 128GB 통합 메모리
한 줄 요약: 로컬 LLM용 미니 PC는 ’128GB 통합 메모리’가 기준선이고, CUDA가 필요하면 NVIDIA DGX Spark, 아니면 가성비로 GMKtec EVO-X2, 예산이 부족하면 32GB의 GEEKOM A8·Beelink SER8(7B~33B 모델용)을 고른다.
한 릴스가 로컬 LLM을 돌릴 미니 PC를 고르는 사람에게 하나의 결론을 보여줘요. 제목은 “What is the best mini PC for local LLMs?“이고, 답은 “2026년 로컬 LLM용 최고의 미니 PC: 128GB 통합 메모리 머신“이에요. 릴스는 두 대를 나란히 놓고 비교해요. GMKtec EVO-X2(AMD Ryzen AI Max+ 395)는 베스트 밸류 픽, NVIDIA DGX Spark(GB10 Grace Blackwell 슈퍼칩)는 개발자·툴링용 픽이에요. 두 대 모두 128GB 통합 메모리를 단다는 점이 공통점이고, 갈리는 기준은 CUDA 지원 여부예요.
왜 메모리 용량이 성능보다 먼저 언급되는지, 통합 메모리가 뭔지, 그리고 두 기계의 차이가 정확히 어디에서 오는지 풀어 설명하겠어요.
왜 128GB 통합 메모리인가
로컬 LLM의 첫 번째 문턱은 연산 능력이 아니라 메모리 용량이에요. 모델을 메모리에 다 올려야 추론이 시작되는데, 요즘 쓸 만한 오픈 모델은 70B(700억 매개변수)~130B 급까지 커졌어요. 릴스가 “Huge models (70B–130B) now fit in memory”라고 쓴 문장이 이 뜻이에요.
이전 글에서 4-bit 양자화 LLM의 VRAM 예산을 계산한 적이 있어요. 4-bit에서는 가중치 메모리 ≈ 매개변수 수 × 0.5GB 규칙이 성립해요. 이 규칙에 70B와 130B를 대입하면 35GB, 65GB예요. 여기에 KV 캐시(한 번 읽은 문맥을 모아 두는 단어집), 비양자화 텐서, 런타임 오버헤드가 더해지므로 실제 요구량은 가중치보다 훨씬 커져요. 즉 130B급 모델을 4-bit로 돌리려면 가중치 65GB + 여유분으로 100GB 안팎의 메모리가 필요해요. 128GB가 바로 이 지점을 겨우, 그러나 여유 있게 넘는 숫자예요. (4-bit VRAM 예산 계산 글에서 규칙의 근거를 다뤘어요.)
통합 메모리(unified memory)가 뭔가
전통적인 PC 구조에서는 CPU와 GPU가 메모리를 따로 어요. CPU는 시스템 RAM을, GPU는 자기만의 VRAM을 어요. 모델 가중치는 VRAM에, 운영체제와 애플리케이션은 RAM에 올라가고, 데이터가 두 메모리 사이를 오갈 때마다 복사(PCIe 전송)가 필요해요. VRAM이 부족하면 그 순간 “모델이 안 들어간다”는 벽에 부딪혀요.
**통합 메모리(unified memory)**는 CPU와 GPU가 하나의 찬장을 따로 두지 않고 한 식탁을 같이 쓰는 구조예요. 서로 사이를 복사해 나가던 기존 방식과 달리, 같은 테이블 위 자료를 둘이 함께 봐요. 즉 CPU와 GPU가 하나의 메모리 풀을 같이 쓰는 구조예요. 릴스의 다이어그램이 정확히 이것을 그려요. CPU와 GPU가 화살표로 연결되고, 둘 다 아래의 “128GB UNIFIED MEMORY” 박스를 가리켜요. 이 구조에서는 다음 세 가지가 동시에 일어나요.
- VRAM 병목이 사라진다 — 메모리가 한 풀이므로 복사 단계가 없다.
- 접근이 빠르다 — 릴스 표현으로 “Faster data access, lower latency”.
- 용량이 곧 상한선이다 — 메모리가 128GB면 128GB까지의 모델을 다룰 수 있다.
이 발상을 먼저 대중화한 것은 애플의 M 시리즈 실리콘이에요. 이제 x86 진영(Ryzen AI Max+)과 NVIDIA(GB10) 미니 PC에도 같은 발상이 들어온 것이에요. 두 제품 모두 이 통합 메모리를 LPDDR5X(저전력·고대역폭 DDR 메모리)로 구성해요. 다만 LPDDR5X의 대역폭은 외장 그래픽카드의 GDDR 대비 낮은 편(수백 GB/s 수준)이라, 메모리에 들어가는 모델 크기는 커지지만 토큰 생성 속도 자체는 동급 VRAM GPU보다 느릴 수 있어요. “들어가냐”와 “빠르냐”는 별개의 문제인 셈이에요.
GMKtec EVO-X2 — 베스트 밸류 픽
릴스가 트로피를 붙인 첫 번째 후보예요. GMKtec EVO-X2는 AMD Ryzen AI Max+ 395를 탑재한 미니 PC예요. 릴스가 적어 둔 스펙은 이래요.
- 128GB 통합 메모리(LPDDR5X)
- Ryzen AI Max+ 395: 16코어/32스레드, 최대 5.1GHz
- Radeon 8060S iGPU(RDNA 3.5)
- 4-bit 기준 최대 약 130B 매개변수 모델 구동
- 추론(inference)·파인튜닝·RAG·일반 용도에 적합, 가성비 우수
Ryzen AI Max+ 395는 AMD의 “Strix Halo” 계열 APU로, CPU와 강력한 iGPU가 하나의 패키지에 들어 있고 둘이 LPDDR5X 통합 메모리를 공유해요. Radeon 8060S는 RDNA 3.5 아키텍처 기반 iGPU로, 외장 그래픽카드 없이도 LLM 추론을 감당할 성능을 내요. “4-bit로 ~130B”는 위의 0.5GB 규칙과 정확히 맞아떨어지는 숫자예요. 130B × 0.5GB = 65GB 가중치 + KV 캐시와 오버헤드 = 128GB 통합 메모리면 여유가 생겨요.
릴스는 이 제품을 “최고의 가치와 다용도성(versatility)을 원하는 사용자”에게 이상적이라고 정리해요. 추론과 RAG 서버, 일반 컴퓨팅까지 골고루 쓰겠다면 이쪽이라는 뜻이에요.
NVIDIA DGX Spark — 개발자·툴링용 픽
두 번째 후보는 NVIDIA DGX Spark예요. 릴스의 요약은 “GB10 Superchip (Grace Blackwell)“이에요. GB10은 NVIDIA의 Grace Blackwell 슈퍼칩으로, Arm 기반 CPU와 Blackwell 아키텍처 GPU를 하나의 칩으로 묶은 것이에요. 릴스가 적은 스펙은 이래요.
- 128GB 통합 메모리
- Blackwell GPU: FP4 기준 1 PFLOP AI 성능
- AI 개발자 전용 설계(purpose-built for AI developers)
- CUDA 풀 지원
- NVIDIA AI 생태계와 최고 호환성(TensorRT, cuBLAS, NIM 등)
- 작고 조용하며 강력함
용어를 짚겠어요. CUDA는 NVIDIA 기기 전용 공구 상자 같은 플랫폼이에요. AI 프레임워크 대부분이 이 공구에 맞춰 조립돼 이 위에 서 있어요. TensorRT는 NVIDIA의 추론 최적화 엔진, cuBLAS는 GPU 선형대수(행렬곱) 라이브러리, **NIM(NVIDIA Inference Microservices)**은 NVIDIA가 제공하는 추론 마이크로서비스 묶음이에요. 즉 DGX Spark의 강점은 성능 자체보다 “NVIDIA 소프트웨어 스택이 그대로 돌아간다”는 것이에요. 릴스는 이 제품을 “CUDA와 최대 호환성이 필요한 개발자·연구자”에게 이상적이라고 정리해요.
CUDA가 두 제품을 가르는 이유
릴스가 두 제품의 소개를 끝내고 강조하는 것이 바로 이 기준이에요. 결론에서 “예산과 CUDA 개발 지원 필요 여부로 선택하라”고 쓴 것도 같은 맥락이에요.
- CUDA가 필요하면 DGX Spark. NVIDIA 생태계의 도구(TensorRT·cuBLAS·NIM)와 프레임워크 코드는 CUDA를 전제로 만들어져 있어요. 개발한 코드를 데이터센터 GPU로 옮길 계획이 있거나, NVIDIA 전용 최적화를 그대로 써야 한다면 CUDA를 지원하는 쪽이 마찰이 없어요.
- CUDA가 필요 없으면 EVO-X2. 모델을 돌리고(RAG·추론), 가끔 파인튜닝하고, 평소에는 일반 PC로 쓰는 용도라면 CUDA 제약이 없어요. 이 경우 릴스 기준으로 EVO-X2가 가성비에서 앞서요.
즉 이 릴스의 결론은 “128GB 통합 메모리 미니 PC가 2026년 로컬 LLM의 스위트 스팟”이라는 전제 위에서, CUDA를 쓰느냐 마느냐라는 하나의 질문으로 선택이 갈린다는 것이에요.
예산이 부족하다면: GEEKOM A8 · Beelink SER8
릴스는 128GB가 필요 없는 사람을 위한 저옵션도 제시해요.
- GEEKOM A8 — AMD Ryzen 7 8845HS, 32~64GB RAM. 7B~33B 모델에 적합
- Beelink SER8 — AMD Ryzen 7 8745HS, 32GB RAM. 조용하고 작지만 충분히 쓸 만함
메모리와 모델 크기의 관계는 0.5GB 규칙으로 확인돼요. 32GB면 4-bit 기준 가중치 16GB 이하, 즉 7B~33B(3.5~16.5GB) 모델이 들어가요. 128GB와 32GB의 차이는 “돌릴 수 있는 모델 크기의 차이”이자 “할 수 있는 작업의 차이”예요. 32GB에서 RAG와 챗봇 정도가 끝이라면, 128GB에서는 70B급 모델 구동과 파인튜닝 실험이라는 층위가 하나 더 열려요.
릴스의 선택 가이드 정리
| 필요 | 선택 |
|---|---|
| 최고 가성비(종합) | GMKtec EVO-X2 |
| AI 개발 · CUDA 워크플로 | NVIDIA DGX Spark |
| 일반 용도 · LLM · RAG | GMKtec EVO-X2 |
| 예산 중시 | GEEKOM A8 · Beelink SER8 |
어떻게 연결되는가
한 줄로 요약하면: 로컬 LLM의 문턱은 메모리이고, 2026년에는 128GB 통합 메모리 미니 PC가 그 문턱을 실속형 가격에 넘게 해 준다. CPU와 GPU가 한 메모리를 나눠 쓰는 통합 메모리 덕에 VRAM 병목이 사라졌다는 이야기예요.
이전 글들과 연결하면 그림이 완성돼요. GGUF 양자화 글에서 “양자화가 메모리 문턱을 낮춘다”는 흐름이었다면, 이번 릴스는 “하드웨어 쪽에서 문턱을 올려 준다”는 흐름이에요. 4-bit로 130B 모델의 가중치는 65GB인데, 통합 메모리 128GB면 KV 캐시와 오버헤드까지 넣고도 여유가 남아요. 남는 여유는 문맥 길이와 파인튜닝에 쓰면 돼요. CUDA가 필요한 개발자는 DGX Spark, 가치와 다용성을 원하는 사용자는 EVO-X2 — 릴스의 이 선택 기준은 메모리 용량이 아니라 소프트웨어 생태계에 두고 있다는 점이 인상적이에요.
출처