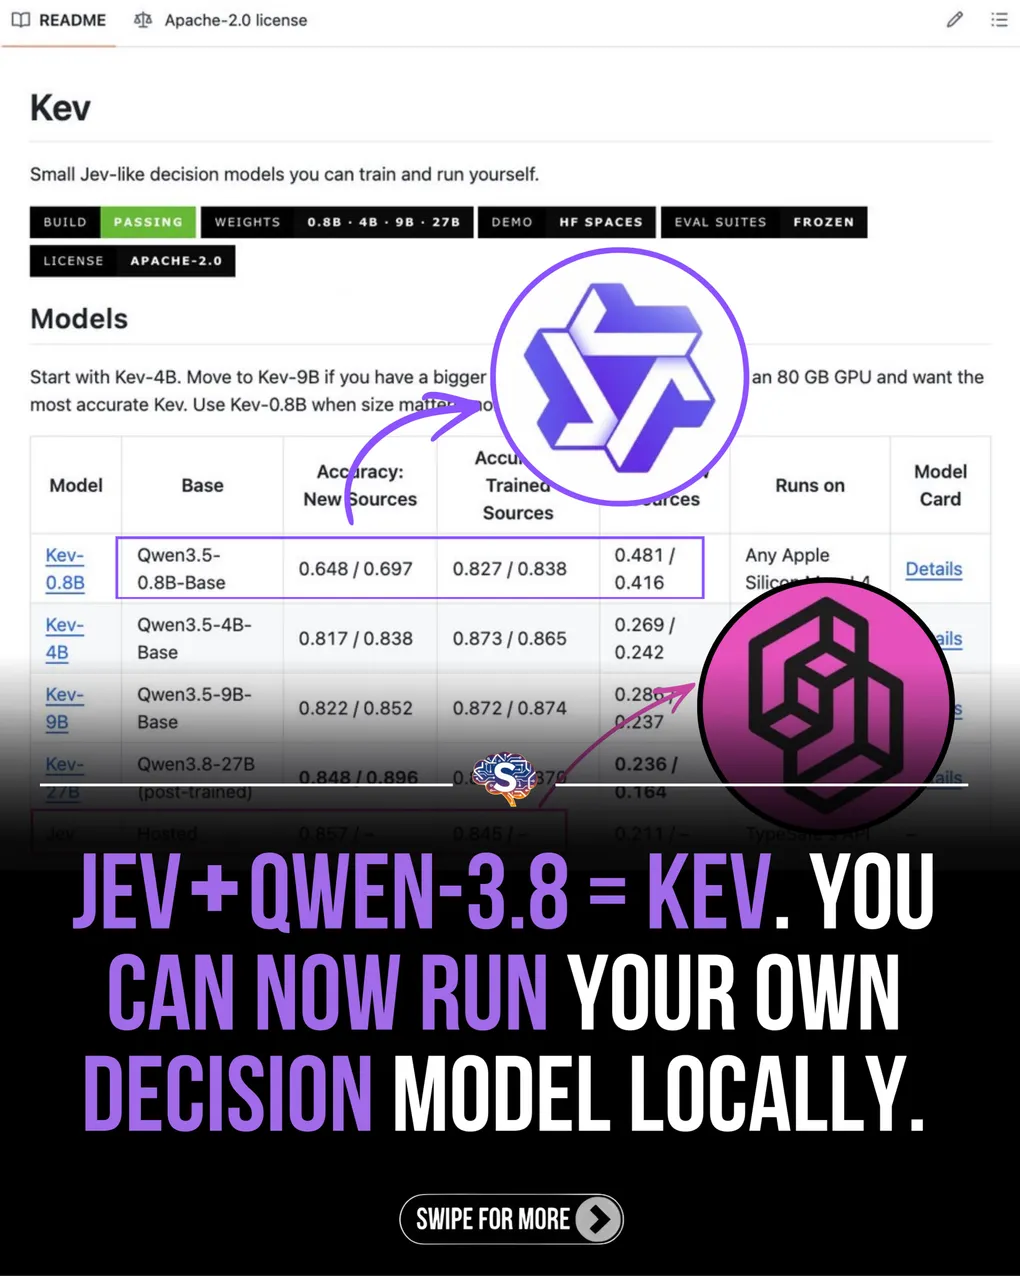
내 컴퓨터에서 돌리는 판정 모델 Kev
한 줄 요약: Kev는 Jev의 판정 모델 구조를 공개 해설 문서를 바탕으로 큐웬(Qwen3.5·3.8) 위에 재현한 오픈소스 모델 가족(0.8B~27B)으로, TypeSafe SDK에 주소만 바꿔 끼우면 로컬에서 같은 API가 돌고, 최대판은 호스팅 Jev와 정확도 1점 이내예요.
“JEV + QWEN-3.8 = KEV. YOU CAN NOW RUN YOUR OWN DECISION MODEL LOCALLY”이라는 문구의 3장 카드뉴스가 눈에 띄었어요. AI 소식 계정 Simplifying AI의 게시물이고(좋아요 945개, 댓글 155개), 마지막 장은 댓글을 다는 대신 DM으로 자료를 주는 계정 홍보예요. 대상인 Kev는 개발자 Jared Palmer가 공개한 리포로, 현재 스타 7,000개 이상, Apache-2.0 라이선스예요. 이 블로그는 발행 검수 도구를 TypeSafe의 System One API(Jev)로 돌리는데, Kev는 정확히 그 API 계약을 로컬 서버로 구현해 놓은 프로젝트예요. 그래서 이 글에서는 원문 리포 전체와 대조하면서 풀겠어요. Jev가 어떤 모델인지는 이전 글 Jev, 왜 환각이 없나와 폰에서 Laya, Jev와 붙였다에서 다뤘어요.
Jev와 Kev의 차이는 소유권이다
먼저 배경을 짚을게요. TypeSafe의 Jev는 글을 쓰지 않는 AI예요. 대화식 텍스트 생성 대신, 판정 문서 한 건과 유형을 갖춘 질문 여러 개(예·아니오형, 선택형, 등급형)를 같이 보내면 정답과 전체 확률 배분을 한 번에 돌려주는 형태예요. 이런 구조 덕분에 환각이 구조적으로 생길 자리가 없고, 확신도도 함께 나오니 코드가 바로 걸어 쓸 수 있어요. 다만 Jev는 회사 서버에서 돌아가는 API 기반이라 가중치는 공개되어 있지 않아요.
Kev의 공식 소개는 이렇게 돼요. “Jev와 같은 작은 판정 모델 가족(정확히는 Qwen3.5와 Qwen3.8 위에 놓은 것)을 스스로 훈련하고 실행할 수 있게 만든 것.” 그 기반이 되는 건 Jev의 아키텍처를 해설한 공개 글(Jev’s Architecture Unmasked)이예요. 즉 릴스의 표현대로 “reverse-engineered”라기보다, 공개된 해설 문서를 바탕으로 같은 설계를 재현한 정공법에 가까워요. 그리고 리포가 특히 분명하게 말하는 점이 있어요. 훈련에는 Jev의 출력이 전혀 쓰이지 않았다는 거예요. 데이터는 공개 데이터셋 10개에서 뽑은 1만 예시, 생성한 정책 예시 896건, 생성한 규칙 구조에서 만든 1,680건이에요. 이는 “Jev 결과를 복사한 모형”이 아니라, 같은 설계를 스스로 훈련한 모형이라는 뜻이에요.
큐웬 위에 얹은 포인터 헤드
Kev 각 체크포인트의 본체는 Qwen 베이스 모델 위에 얹은 랭크 16 LoRA 어댑터와 작은 포인터 헤드예요(0.8B판은 학습 파라미터 1,130만 개 수준). 의인화로 그리면 베이스 모델은 문서를 읽는 사람이고, 포인터 헤드는 문장 끝의 채점 자리(판정용 decide 토큰)를 찍어 주는 채점펜이에요. 동작은 이래요. 상태(state) 텍스트와 질문을 구분 토큰으로 나눠 넣고, 각 선택지 위치의 숨은 상태를 판정용 decide 토큰 위치와 비교해 점수를 매긴 뒤 소프트맥스로 확률을 바꿔 줘요. 질문이 여러 개면 각 질문이 상태만 공유하고 서로를 읽지 못하도록 분리돼 있어요(마스크 기반 격리 또는 질문별 행 분리). 그래서 “예·아니오형(noul), 선택형(choice), 등급형(score)을 한 번의 요청에 함께 보내면 한 번에 답이 나온다”라는 릴스의 문장은 그대로 맞아요.
여기에 각 체크포인트는 자체 온도(temperature) 보정값을 내장해요. 모델이 자신을 과하게 신뢰하는 성향을 온도 계수 한 개로 눌러 실제 데이터에 맞는 확률로 정밀조정하는 것인데, 모델마다 1.38~2.41 사이의 온도 계수가 체크포인트에 내장돼요. 이를 통해 “0.9 확신을 준 판정이 틀렸던” 비율을 8.7%에서 4.0%로 줄였고, 이는 Jev의 3.7%와 거의 같아요. 확률이 실제 오류율과 얼추 맞는다는 점은 이 모델 가족의 큰 장점이에요.
크기 고르기: 0.8B부터 27B까지
모델은 크기에 따라 네 가지예요.
- Kev-0.8B — 노트북에서 돌아가요(맥 Apple Silicon, L4급 GPU). 크기 우선일 때.
- Kev-4B, Kev-9B — 32GB 맥 또는 L40S·H100급에서 돌아가요. 가이드는 4B로 시작해 더 큰 GPU가 있으면 9B로 올리라고 조언해요.
- Kev-27B — B200·H200·H100 80GB 전용이고 맥 경로는 없어요(가중치가 55GB). 가장 정확한 Kev가 필요할 때.
릴스의 슬로건은 “JEV + QWEN-3.8”인데, 정확히는 0.8B·4B·9B는 Qwen3.5 Base를 베이스로 쓰고 27B만 Qwen3.8의 포스트트레인 릴리스를 베이스로 써요(그 훈련 데이터는 미공개). 슬로건에는 이 베이스 차이가 축약되어 있어요.
점수표 읽기: 정확도와 Brier
릴스 두 번째 장의 모델 표는 원문 리포와 일치해요. 표의 값은 (개발용/시험용) 쌍이에요. New Source는 훈련에서 본 적 없는 데이터셋과 정책 규칙(QNLI, SciQ, PAWS, MMLU, 감정 분류 등)이고, Trained Source는 훈련에 썼던 데이터셋 중 남겨 둔 예시예요. Brier 점수는 정답만 보는 정확도와 달리 전체 확률 분배의 오차를 점수화하는 지표로, 답이 맞았는지만 볼 게 아니라 확신도가 부풀었는지까지 벌점으로 세기에 낮을수록 좋아요.
핵심 숫자는 이래요. 새로운 출처에서 Kev-27B는 정확도 0.848, Jev가 0.857로 1점 이내 차이예요. 4B·9B는 4점 이내 거리에요 — 이 정도면 개인 GPU에서 도는 모형과 호스팅 판정 API의 격차가 의미 있는 수준으로 좁혀졌다는 뜻이에요. 단, 리포가 스스로 밝히는 단서 하나를 남길게요. Jev의 훈련 데이터는 공개되어 있지 않아서, 이 비교는 “같은 데이터로 훈련해 다른 구조를 비교하는” 통제된 실험은 아니라는 거예요.
그리고 리포는 다른 사람의 시험셋에서의 결과에 대해서 낙관적이지 않아요. SemIf(0.965 vs 0.917), WANLI(0.758 vs 0.703), TypeSafe 자체 공개 평가(0.891 vs 0.856·0.809)처럼 세 개 외부 시험셋에서는 전부 Jev가 위에요. “새로운 출처에서는 거의 비슷하지만, 아는 영역의 시험셋에서는 아직 뒤짐”이 리포의 실체 정리에 가장 가까워요.
실전 경로: SDK·파인튜닝·배포
릴스가 세 줄로 요약한 실전 경로를 하나씩 보겠어요.
- SDK에 그대로 끼우기 — TypeSafe Python SDK는 서버 주소(base_url)만 로컬의 Kev 서버로 바꾸면 나머지 코드는 그대로 굴러가요. 토큰 구독을 쓰는 서비스를 로컬로 옮기는 가장 짧은 경로예요. 서버 명령 한 줄로 Kev-4B를 띄우고(CUDA·ROCm·MLX 자동),
/v1/systemone계약으로 질문을 보내면 돼요. - 브라우저 데모 — 설치 없이 Hugging Face Space에서 Kev-4B·0.8B를 시험할 수 있어요. 체스 보드 데모도 있어요. 체스에서는 보드가 입력(상태), 합법수가 선택지(choice), 국면 평가가 등급(score)으로 들어가는, 이 모델 패밀리의 입출력 형식이 게임에 그대로 적용된 예시예요.
- 내 데이터로 파인튜닝 — 질문 유형이 나만의 카테고리나 언어라면, 내 라벨 몇 천 건으로 짧은 파인튜닝이 효과적이에요. 실제 예시로 소비 금융 불만 5,219건을 한 에폭 돌리자 이전에 본 적 없는 불만 정확도가 0.804에서 0.904로 올라갔고, 지원 업무 유사 시나리오에서는 5% 오류 예산 안에서 자동화할 수 있는 사안 비율이 34%에서 48%로 늘었어요. Kev-4B 한 번 훈련이 H100 기준 약 1달러라고 리포가 밝혀요. 더 나아가 코딩 에이전트 스킬(kev-finetune)이 인터뷰부터 데이터 변환·훈련·온도 보정·점수 비교까지 전 과정을 대신 돌려줘요. 또한 기존 Kev 가중치에서 시작하는
--init_from옵션을 쓰면 이미 배운 것을 유지한 채 내 도메인만 얹을 수 있어요(이 옵션 없이 베이스부터 훈련하면 Kev 시험셋 점수가 0.84에서 0.33로 무너지는 실제 사례도 기록돼 있어요). - 엔드포인트 배포 — Modal 계정만 있으면 명령 한 줄로 HTTPS 엔드포인트가 생기고, 유휴 시 스케일투제로라 쉬는 데는 비용이 들지 않아요. 다만 아이들 상태 뒤 첫 요청은 컨테이너 시작으로 약 35초 걸려요.
솔직한 한계
리포의 한계 목록도 그대로 짚을게요. 첫째, 자동화 격차는 벌점이에요. 5% 오류 예산 기준으로 Kev가 자동으로 돌릴 수 있는 판정은 45~57%인데 Jev는 70%예요. 신뢰구간이 좁지 않으니 임계값은 내 데이터로 먼저 검증하라고 권해요. 둘째, 지식 문제는 베이스 모델의 몫이에요(MMLU 0.74 vs Jev 0.90, MMLU-Pro 0.52 vs 0.84). 셋째, 선택지 순서가 답을 흔들 수 있어요(질문 격리와 별개). 넷째, 날짜 계산은 약점이지만 두 날짜 사이 일수를 문장으로 붙여주는 옵션(KEV_DATE_FACTS)을 켜면 데드라인 정책 판정이 0.80에서 0.90으로 오르는 기법도 기록돼 있어요. 다섯째, 긴 문서는 384토큰 수준으로 훈련된 상태라 정확도가 내려가는 데, 27B만 긴 문서에서 뚜렷하게 버틴다(1k~6k 토큰 속 문제 판정 0.833 vs 9B의 0.556).
또한 이 프로젝트가 코딩 에이전트 Devin으로 빌드됐다고 리포가 명시한 것도 흥미로운 디테일이에요. 이 블로그가 다룬 바이브 코딩 단계 설명 중 “에이전트가 리서치까지 맡아 구현하는” 형태의 예시로, 이 리포는 꽤 상위 단계의 실사례예요.
어떻게 연결되는가
한 줄로 정리하면: Kev는 판정 모델(Jev)이 “서비스를 구매하는 것”에서 “가중치를 갖고 돌리는 것”으로 바뀌는 전환을 보여주는 사례이고, TypeSafe SDK 계약을 그대로 받아내서 그 전환이 실제로 체감되게 만드는 오픈소스 모델 가족이에요.
이 블로그의 검수 도구가 지금 호스팅 API를 그대로 쓰고 있는데, Kev 같은 오픈 대안이 등장한 것은 이런 도구들의 운영 비용 구조가 바뀔 수 있음을 의미해요. 개인이나 팀이 로컬 GPU(특히 Apple Silicon 맥의 4B/9B)에서 질문을 낮은 비용으로 판정받을 수 있게 되는 것이에요. 물론 자동화율과 지식 문제, 순서 민감성 같은 실질 한계는 아직 남아 있고, 내 데이터로 파인튜닝하면 그 격차를 좁힐 수 있다는 점도 이번 점수표가 보여준 대로예요.
출처
- Kev GitHub 리포(README 전문) — 모델 표(개발/시험), 훈련 데이터 구성과 “Jev 출력 미사용” 명시, 온도 보정 수치, 파인튜닝·배포 절차와 비용, 한계 목록, 외부 시험셋 결과 (원문 링크 보유)
- Kev Hugging Face Space — 브라우저 데모(Kev-4B·0.8B) (원문 링크 보유)
- Kev-0.8B 모델 카드(Hugging Face) — LoRA 랭크·학습 파라미터 수·베이스 리비전 명세 (원문 링크 보유)
- Jev’s Architecture Unmasked(Archer Hume) — Kev가 기반으로 쓴 아키텍처 해설 (원문 링크 보유)
- TypeSafe System One API 문서 — noul·choice·score 계약 정의 (원문 링크 보유)
- 게시물 원문 — Simplifying AI — 3장 카드뉴스 기준 (원문 링크 보유)