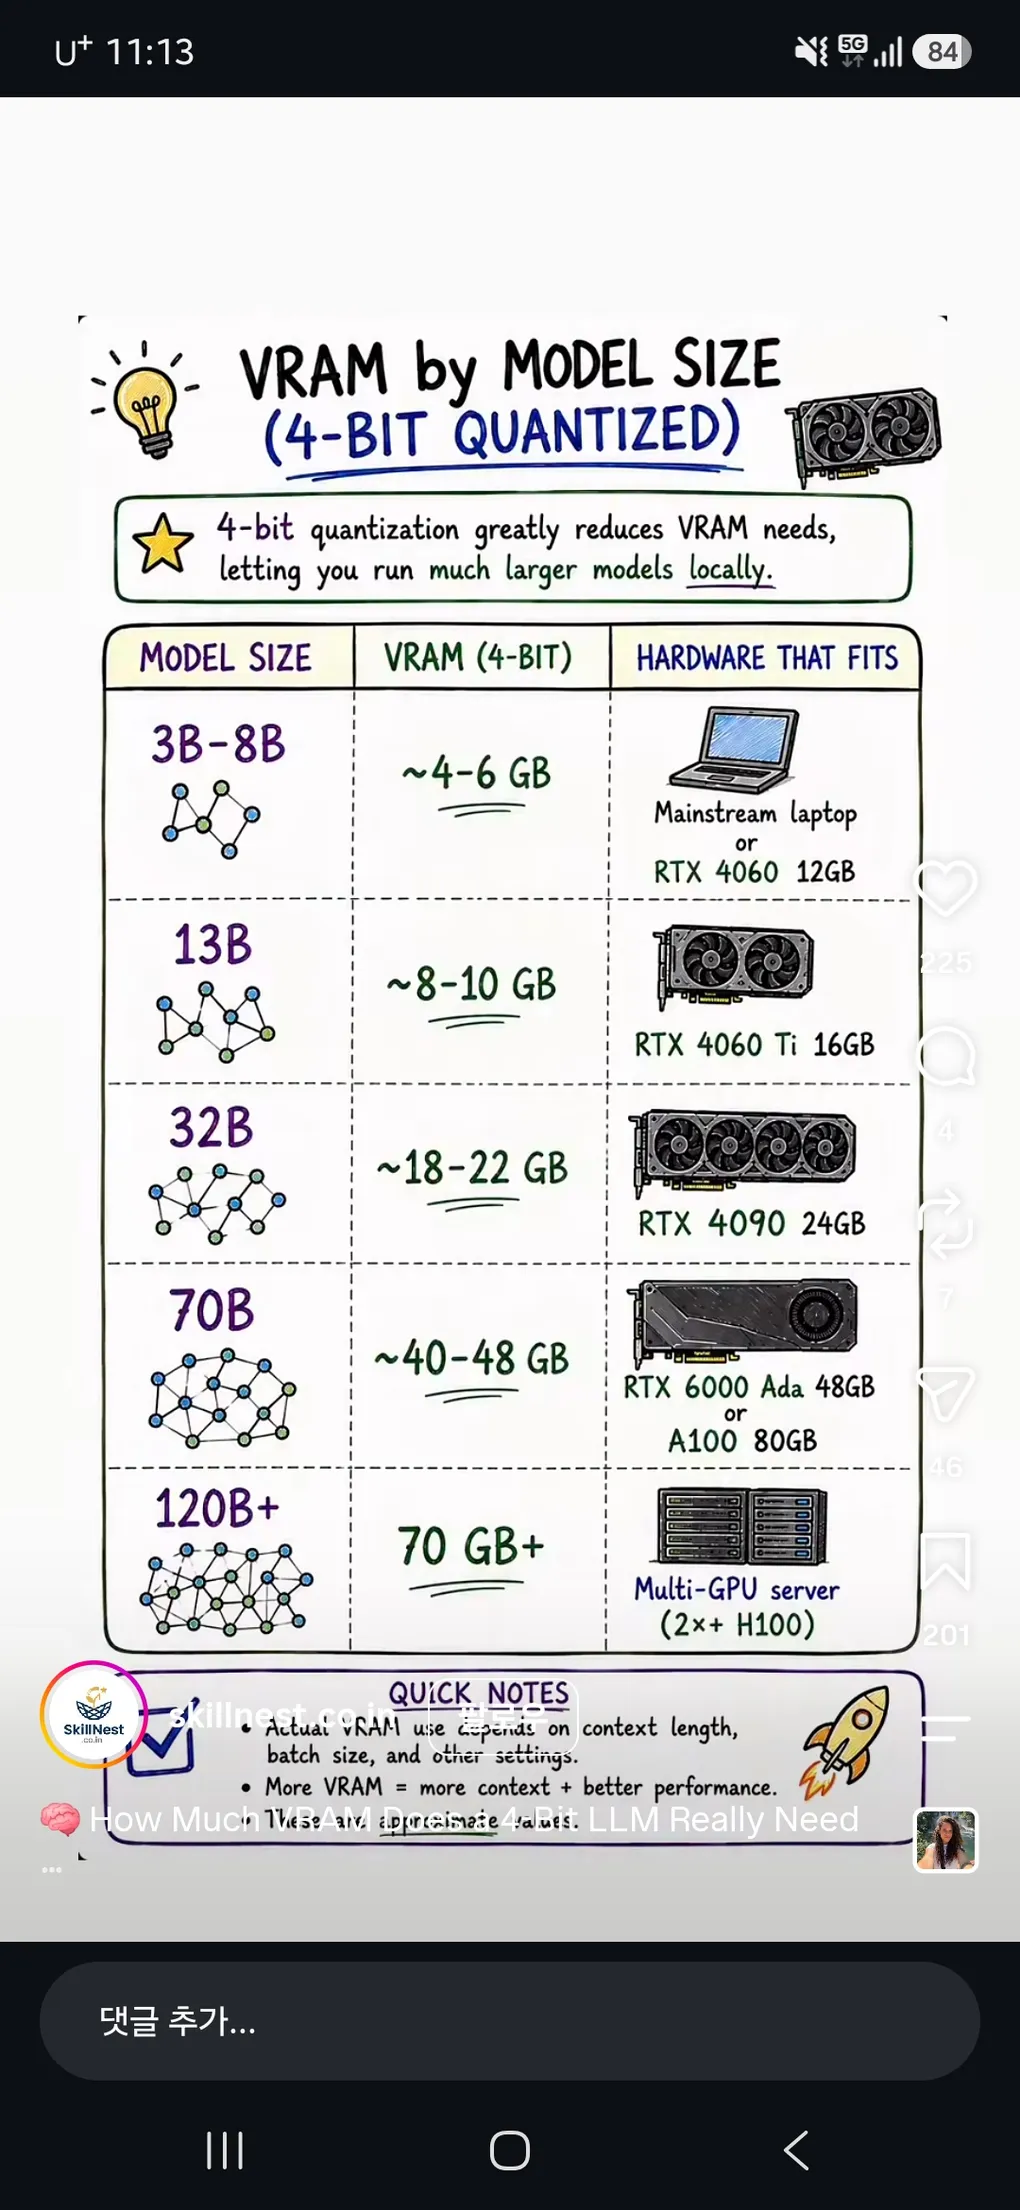
[릴스 해설] 4-bit 양자화 LLM의 VRAM 예산 계산법
한 줄 요약: 4-bit 양자화의 ‘가중치 ≈ 매개변수 × 0.5GB’ 규칙은 출발점일 뿐, 실제 VRAM은 양자화 메타데이터·비양자화 텐서·KV 캐시·문맥 길이가 더해져 더 커지므로 ’70B Q4 = 40~48GB 모델’이라는 말은 오해다.
한 릴스가 로컬 AI를 시작하는 사람에게 유용한 “VRAM 예산표”를 보여줘요. 제목은 “4-bit 양자화 LLM은 실제로 VRAM을 얼마나 필요로 하는가?“이에요. 핵심 규칙은 한 줄이에요. 4-bit에서 가중치 메모리 ≈ 매개변수 수 × 0.5GB. 이 공식에 8B, 13B, 32B, 70B, 120B를 대입하면 4GB, 6.5GB, 16GB, 35GB, 60GB라는 깔끔한 표가 나와요. 그런데 릴스는 곧바로 한 발 물러서서 말해요. 이건 “출발점”일 뿐이고, 실제 사용량은 더 높다고요.
왜 0.5GB라는 숫자가 나오는지, 왜 실제로는 더 많이 쓰이는지, 그리고 릴스가 직접 짚은 “70B Q4가 곧 40~48GB 모델이라는 말은 틀렸다”는 정정이 왜 중요한지 풀어 설명하겠어요. 릴스 마지막에 등장한 자체 호스팅 빌드(vLLM + Qwen 2.5 14B + Nginx + Docker + Qdrant, RTX 5080)도 함께 살펴봐요.
0.5GB 규칙: 왜 4-bit면 “매개변수 수 × 0.5GB”인가
공식 자체는 단순한 단위 변환이에요. 4-bit 양자화는 매개변수 하나를 4비트로 저장해요. 4비트는 0.5바이트(4 ÷ 8 = 0.5)예요. 따라서 10억(1B) 개 매개변수를 4-bit로 저장하면 10억 × 0.5바이트 = 5억 바이트 = 0.5GB가 돼요(십진법 기준, 1GB = 10억 바이트).
- 8B → 8 × 0.5 = 4GB
- 13B → 13 × 0.5 = 6.5GB
- 32B → 32 × 0.5 = 16GB
- 70B → 70 × 0.5 = 35GB
- 120B → 120 × 0.5 = 60GB
릴스의 표와 정확히 일치해요. 이 규칙이 유용한 이유는, 가중치가 4-bit 양자화 모델의 메모리 대부분을 차지하므로 “모델이 VRAM에 들어갈까?“라는 첫 질문에는 이 한 줄로 대략적인 답이 나오기 때문이에요. 다만 이건 가중치만 계산한 숫자라는 점을 늘 염두에 두어야 해요.
“들어가는 양”과 “실제 쓰는 양”은 다르다
릴스가 “실제 사용량은 더 높다”고 경고하는 이유는, 가중치 외에 VRAM을 차지하는 항목이 여럿 있기 때문이에요. 릴스는 다섯 가지를 꼽아요. 양자화 메타데이터, 비양자화 텐서, KV 캐시, 문맥 길이, 런타임 오버헤드. 하나씩 보겠어요.
양자화 메타데이터. 4-bit 양자화는 매개변수를 32~128개 묶음(그룹)으로 나누어, 각 그룹마다 스케일(scale)과 영점(zero-point) 같은 보정 값을 추가로 저장해요. 이 메타데이터가 가중치 본체 위에 수% 정도 더 붙어요. “0.5GB 규칙”은 이 메타데이터를 빼고 가중치 본체만 잰 숫자이므로, 실제 파일 크기는 공식 결과보다 조금 더 어요.
비양자화 텐서. 모든 층을 4-bit로 줄이지는 않아요. 정확도 손실이 큰 부분, 특히 임베딩 층과 최종 출력 투영(lm_head, 어휘 전체에 대한 로짓을 내는 층)은 FP16/BF16(2바이트) 그대로 두는 경우가 많아요. 예를 들어 70B 모델에서 어휘가 15만 개, 은닉 차원이 8192라면 lm_head만 약 2.5GB를 차지해요. 즉 “가중치는 35GB”라 해도 그 안에 4-bit가 아닌 수 GB가 섞여 있고, 이 부분은 절반으로 줄지 않아요.
KV 캐시. 모델의 자주 쓰는 단어집이에요 — 지금까지 읽은 문맥을 다시 계산하지 않고 바로 꺼내 쓰게 해 주는 메모리죠. 대화가 길어질수록 단어집이 두꺼워지고, 동시 요청이 많아지면 사람 수만큼 두꺼워져요. 이 항목이 긴 문맥에서는 가중치 다음으로 큰 메모리 소비원이 돼요. 아래에서 따로 다뤄요.
문맥 길이. 릴스가 “문맥 길이”를 따로 언급한 것은, KV 캐시 크기를 결정하는 가장 큰 변수이기 때문이에요. 같은 모델이라도 8K 문맥과 128K 문맥은 메모리 요구량이 16배 차이 나요.
런타임 오버헤드. CUDA 컨텍스트, 활성화 버퍼, 어텐션 중간 텐서, 추론 엔진의 예약 공간 등은 모델과 직접 관계없지만 수백 MB ~ 수 GB를 차지해요. vLLM 같은 서빙 엔진은 보통 VRAM의 일정 비율(기본 약 90%)만 사용하도록 설정하고, 남은 10%를 이런 오버헤드의 안전 여유로 둬요.
KV 캐시: 문맥이 길어질수록 메모리가 부풀는 진짜 원인
KV 캐시는 “들어가는 양”과 “실제 쓰는 양”이 갈라지는 가장 큰 이유예요. 토큰 하나당 KV 캐시 크기는 다음 공식으로 구해요.
토큰당 KV 캐시 = 2(K와 V) × 레이어 수 × KV 헤드 수 × 헤드 차원 × dtype 바이트 수구체적인 예로, PagedAttention 논문이 인용하는 13B 매개변수 OPT 모델을 FP16으로 돌리면 토큰당 800KB가 필요해요(2 × 5120 × 40 레이어 × 2바이트). 최대 2048 토큰까지 생성한다고 하면, 요청 하나당 KV 캐시만 1.6GB에 달해요.
최근 70B급 모델은 레이어가 80개나 되고, GQA(그룹 질의 어텐션) 덕에 KV 헤드 수는 8개로 줄었지만 토큰당 캐시는 수백 KB에 이르러요. 같은 모델이라도 8K 문맥이면 KV 캐시가 수 GB, 32K 문맥이면 10GB 안팎, 128K 문맥이면 가중치와 맞먹을 정도로 커져요. 그래서 “70B Q4 가중치가 35GB”라는 숫자에 문맥 캐시까지 더하면 실제 VRAM 필요량은 훌쩍 뛰어올라요. KV 캐시를 FP8으로 양자화하면 크기를 절반으로 줄일 수 있지만, 이는 정확도에 영향을 줄 수 있어 작업별로 검증이 필요해요.
VRAM 용량별, 무엇이 들어가나
릴스가 정리한 용량별 추천을 옮기면 이래요.
- 12~16GB VRAM → 7B~13B 모델에 아주 적합
- 24GB → 30B급 Q4 모델의 강력한 최적점. RTX 4090이 24GB
- 48GB → 70B급 Q4 모델이 훨씬 현실적으로. RTX 6000 Ada가 48GB ECC VRAM
- 80GB 이상 / 다중 GPU → 훨씬 큰 모델과 더 긴 문맥·동시성까지 열림
이 추천의 기준은 “가중치 + 어느 정도의 문맥 캐시 + 런타임 여유”를 합친 실제 동작 가능선이에요. 가중치만 계산한 0.5GB 규칙이 아니라, 여기에 여유를 더한 값이라고 보면 돼요. 예를 들어 24GB 카드에 32B Q4 모델(가중치 약 16GB)을 올리면 남는 약 8GB로 꽤 넉넉한 문맥을 확보할 수 있어 “최적점”이라는 표현이 성립해요.
“70B Q4 = 40~48GB 모델”은 왜 틀린 말인가
릴스가 특히 강조하는 정정이 있어요. “70B Q4 모델이 곧 40~48GB 모델인 것은 아니다.” 이론적 가중치 크기는 약 35GB지만, 실제 추론에는 추가 메모리가 필요하다는 설명이에요.
틀린 이유는 두 가지 방향이에요. 한쪽으로는 35GB는 가중치만의 크기이므로, 실제로 돌리려면 앞서 본 비양자화 텐서(수 GB)와 KV 캐시(문맥에 따라 수 GB ~ 수십 GB)와 런타임 여유가 더 필요해요. 그래서 “35GB 가중치 = 35GB 카드에서 돌아간다”는 기대는 쉽게 빗나가요.
반대쪽으로는, “그러니까 40~48GB는 있어야 한다”는 식의 고정된 숫자도 성급해요. KV 캐시 양자화(FP8)로 캐시를 절반으로 줄이거나, 일부 층을 더 공격적으로 양자화하거나, 문맥을 짧게 잡으면 실제 필요량은 바뀌어요. 즉 **“70B Q4는 가중치 기준 35GB에서 시작해, 설정에 따라 위아래로 달라지는 동적 예산”**이라고 이해하는 게 정확해요. 릴스의 정정은 이 고정관념을 꺾어주는 역할을 해요.
VRAM 용량 ≠ 속도: 대역폭과 연산량이 토큰 속도를 결정한다
릴스가 마지막으로 남기는 규칙이 이 글의 가장 중요한 교훈이에요. “VRAM 용량은 무엇이 들어가는지를 결정한다. 메모리 대역폭과 연산량이 얼마나 빨리 돌아가는지를 결정한다.”
LLM이 토큰을 하나 생성할 때(디코딩 단계)는 전체 가중치를 한 번씩 읽어야 해요. 즉 단일 요청 기준으로 초당 토큰 수 ≈ 메모리 대역폭 ÷ 가중치 크기에 가깝게 동작해요. 그래서 용량이 같아도 대역폭이 다르면 속도가 다르고, 대역폭이 같아도 올라간 모델 크기가 다르면 속도가 달라요.
릴스에 등장한 카드들의 스펙을 비교하면 이 점이 명확해져요.
| GPU | VRAM | 메모리 종류 | 대역폭 |
|---|---|---|---|
| RTX 5080 | 16GB | GDDR7 | 960GB/s |
| RTX 4090 | 24GB | GDDR6X | 약 1010GB/s |
| RTX 6000 Ada | 48GB | GDDR6 ECC | 960GB/s |
흥미로운 점은 RTX 5080(16GB)과 RTX 6000 Ada(48GB)의 대역폭이 둘 다 960GB/s로 같다는 것이에요. 즉 16GB에 들어가는 14B Q4 모델을 돌린다면, 두 카드에서 토큰 생성 속도는 거의 같아요. 두 카드의 차이는 “얼마나 큰 모델·문맥이 들어가는가”지 “얼마나 빨리 돌아가는가”가 아니에요. 반면 RTX 4090은 24GB에 대역폭도 1010GB/s로 살짝 더 높아, 24GB에 들어가는 모델이라면 두 카드보다 토큰 속도가 약간 더 빨라요.
그래서 릴스가 던지는 질문 “아주 빠른 24GB VRAM과, 훨씬 큰 모델을 위한 48GB VRAM 중 어느 쪽이 좋은가?“는 정답이 정해진 문제가 아니에요. 돌리려는 모델 크기와 문맥 길이, 그리고 원하는 응답 속도(토큰/초)를 먼저 정해야 카드를 고를 수 있어요. 용량은 “들어가냐”를, 대역폭·연산량은 “빠르냐”를 따로 계산해야 한다는 것이 핵심이에요.
릴스에 등장한 빌드: vLLM + Qwen 2.5 14B + Nginx + Docker + Qdrant
릴스 마지막에 자체 호스팅 LLM API 빌드의 사양이 등장해요. CPU는 AMD Ryzen 7 9700X, GPU는 NVIDIA RTX 5080(16GB GDDR7), RAM 64GB DDR5, 저장장치 2TB NVMe, 운영체제 Ubuntu 22.04/24.04 LTS이고, 소프트웨어는 vLLM·Qwen 2.5 14B-Instruct·Nginx·Docker·Qdrant예요. 각 조각이 어떤 역할인지 보겠어요.
Qwen 2.5 14B-Instruct — 실제로 서비스되는 모델이에요. 14B 매개변수이므로 0.5GB 규칙을 적용하면 4-bit 가중치가 약 7GB이에요. RTX 5080의 16GB에 올리면 가중치(7GB) 외에 약 9GB가 남아, 꽤 넉넉한 문맥과 동시성을 확보할 수 있어요. 용량별 추천 표에서 “12~16GB → 7B~13B에 적합”이라던 구간에 14B가 살짝 넘지만, 4-bit 양자화 덕에 16GB에서도 무리 없이 돌아가는 지점이에요.
vLLM — LLM 추론·서빙 엔진이에요. 두 가지 핵심 기술로 처리량을 높이에요. PagedAttention은 그 자주 쓰는 단어집을 한 장짜리 종이 단위로 찢어 서랍 칸에 낋낋이 수납하는 방식이에요. 단어집을 운영체제의 가상 메모리처럼 고정 크기 블록(기본 16토큰)으로 쪼개어 비연속적으로 관리해요. 요청마다 최대 길이만큼 미리 연속 메모리를 잡아두던 예전 방식에서는 60~80%의 메모리가 단편화로 낭비됐지만, 페이징을 쓰면 낭비가 약 4%까지 줄어들어요. **연속 배치(continuous batching)**는 한 번 배치를 묶으면 가장 긴 요청이 끝날 때까지 기다리던 정적 배치와 달리, 매 디코딩 단계마다 끝난 요청을 빼고 손이 빠진 자리에 새 요청을 넣어 GPU를 쉬지 않게 만들어요. 팀 프로젝트에서 누군가 일을 끝내자마자 곧바로 다음 업무를 배분하는 교대 방식과 같아요. 두 기술을 합쳐 기존 대비 2~4배 처리량 개선을 보고해요. vLLM은 OpenAI 호환 API(/v1/chat/completions)를 제공하므로 기존 클라이언트를 그대로 쓸 수 있는 것도 널리 택해지는 이유예요.
Nginx — vLLM 앞에 두는 창구 앞 안내 데스크예요. TLS 종료(HTTPS 처리), 요청 부하 분산, 속도 제한 등을 담당해요. vLLM 서버를 직접 외부에 노출하는 대신 Nginx로 한 겹 감싸는 구성이에요.
Docker — 전체 스택을 컨테이너로 묶어 재현 가능하게 배포해요. GPU 패스스루(NVIDIA Container Toolkit)로 컨테이너 안에서 RTX 5080을 어요.
Qdrant — 벡터 데이터베이스예요. RAG(검색 증강 생성)에서 문서를 임베딩 벡터로 바꿔 저장하고, 질문이 들어오면 의미적으로 가까운 문서를 찾아 모델에 맥락으로 넘겨줘요. vLLM이 “생성”을 담당한다면 Qdrant는 “검색”을 담당하여, 모델이 학습하지 않은 최신·사내 문서를 근거 있게 답변하게 만들어요. 모델 옆에 앉아 필요한 자료를 펴 주는 사서와 같아요.
나머지 하드웨어. 64GB DDR5 RAM은 모델 로딩과 CPU 오프로드 여유를 위해요. 2TB NVMe(7000MB/s 이상)는 수 GB짜리 모델 파일을 빠르게 불러오기 위한 저장장치예요. Ubuntu 22.04/24.04 LTS는 NVIDIA 드라이버와 vLLM/Docker가 안정적으로 지원되는 리눅스 환경이에요. RTX 5080의 GDDR7이 960GB/s 대역폭을 가지므로, 14B Q4 모델(약 7GB)의 토큰 생성은 대역폭 제약 없이 빠르게 진행돼요.
어떻게 연결되는가
한 줄로 요약하면: 4-bit 양자화로 가중치를 “매개변수 × 0.5GB”로 줄이는 규칙은 출발점이고, 실제 VRAM 예산은 그 위에 양자화 메타데이터·비양자화 텐서·KV 캐시·문맥 길이·런타임 여유를 더해야 성립한다는 이야기예요.
릴스가 짚은 “70B Q4 = 40~48GB”라는 고정관념을 깨는 정정은, VRAM 예산이 설정에 따라 움직이는 동적 값이라는 점을 가르쳐줘요. 그리고 “용량 ≠ 속도”라는 마지막 규칙은, 카드를 고를 때 “들어가냐”와 “빠르냐”를 따로 계산해야 한다는 실질적인 잣대를 줘요. RTX 5080과 RTX 6000 Ada가 같은 960GB/s 대역폭을 가졌다는 사실은, 용량만 보고 속도를 가늠하면 안 된다는 것을 잘 보여주는 예시예요.
릴스에 등장한 빌드는 이 원칙들을 한 세트로 엮은 것이에요. 14B 모델을 4-bit로 16GB 카드에 맞춰 올리고(예산 계산), vLLM으로 KV 캐시를 페이징해 메모리 낭비를 줄이고(캐시 관리), 연속 배치로 처리량을 높이고(속도), Nginx·Docker·Qdrant로 서빙·배포·검색을 갖추는 구성이에요. “얼마나 들어가는가”와 “얼마나 빠른가”를 분리해 계산하는 습관이, 이 빌드처럼 자체 호스팅 LLM을 세팅하는 출발점이 돼요.
출처: vLLM PagedAttention 설계 문서 · Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP 2023) · NVIDIA RTX 5080 사양 (SpecPeak) · NVIDIA RTX 6000 Ada / RTX 5080 비교 (GPUPerHour) · RTX 4090 vs RTX 5080 비교 (hardwareDB) · Qdrant 벡터 데이터베이스