양자화는 텐서마다 비트를 다르게 준다
한 줄 요약: 양자화 파일 이름에 붙는
GSQ-RCO는 압축 도구 두 개의 이름이에요. GSQ는 각 텐서를 정확하게 낮은 비트로 담는 법을, RCO는 크기 예산 안에서 텐서마다 비트폭을 다르게 배정하는 법을 맡아요. 354GB 모델이 75.8GB가 되고도 성능 99.4%를 유지하는 이유예요.
앞선 모델 이름 해부에서 이름의 꼬리는 “파일 형식과 압축률”이라고 정리했어요. 그런데 요즘 파일 이름에는 Q4_K_M 같은 익숙한 표기 대신 GSQ-RCO가 붙기도 해요. 이건 압축률 표기가 아니라 압축 방식의 이름이에요. 실제 파일 하나를 열어 확인해 봤어요.
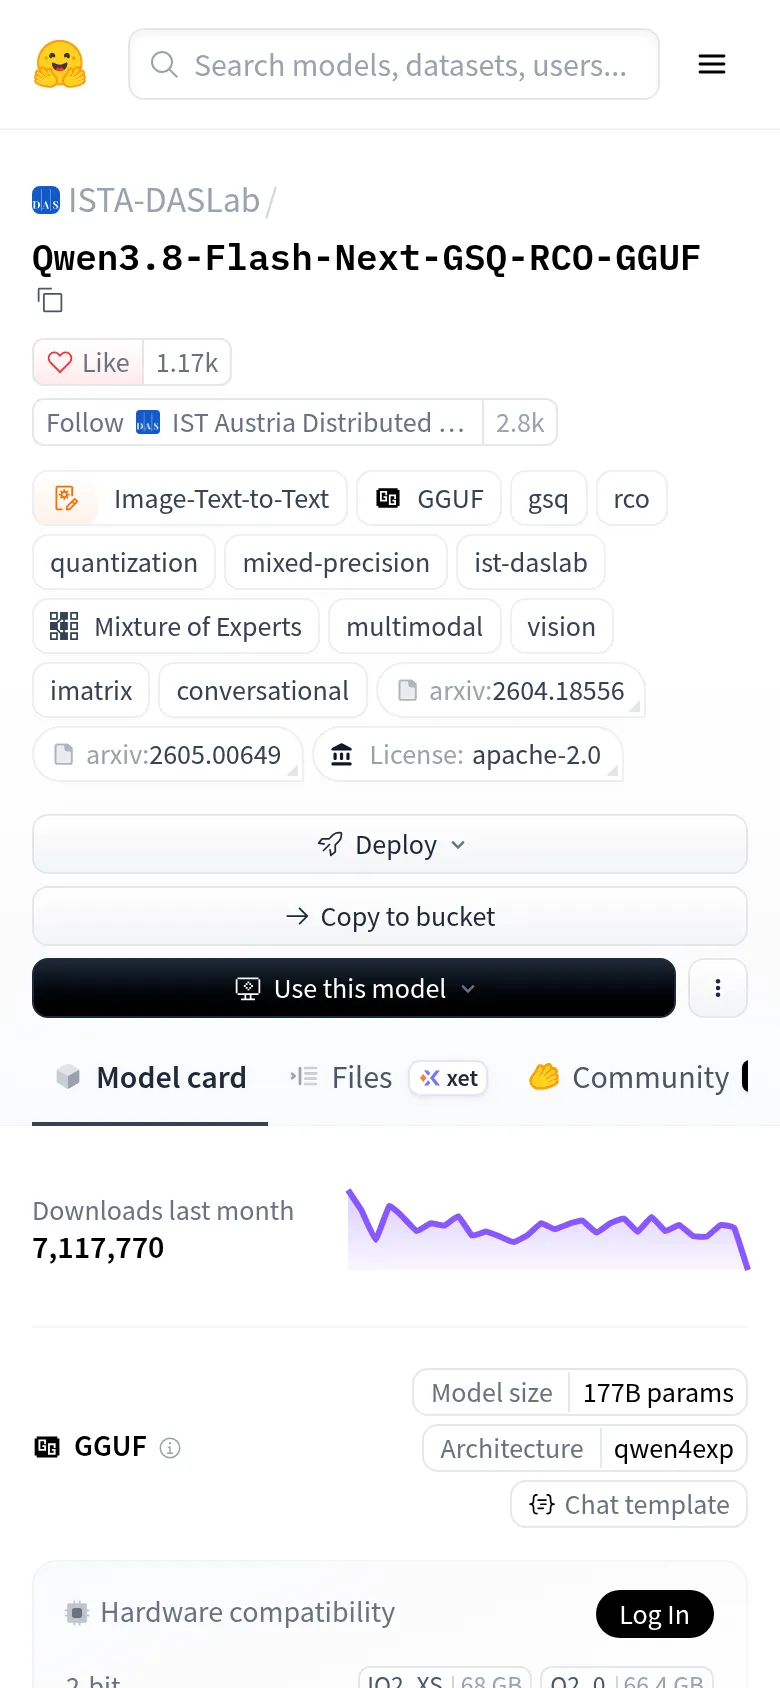
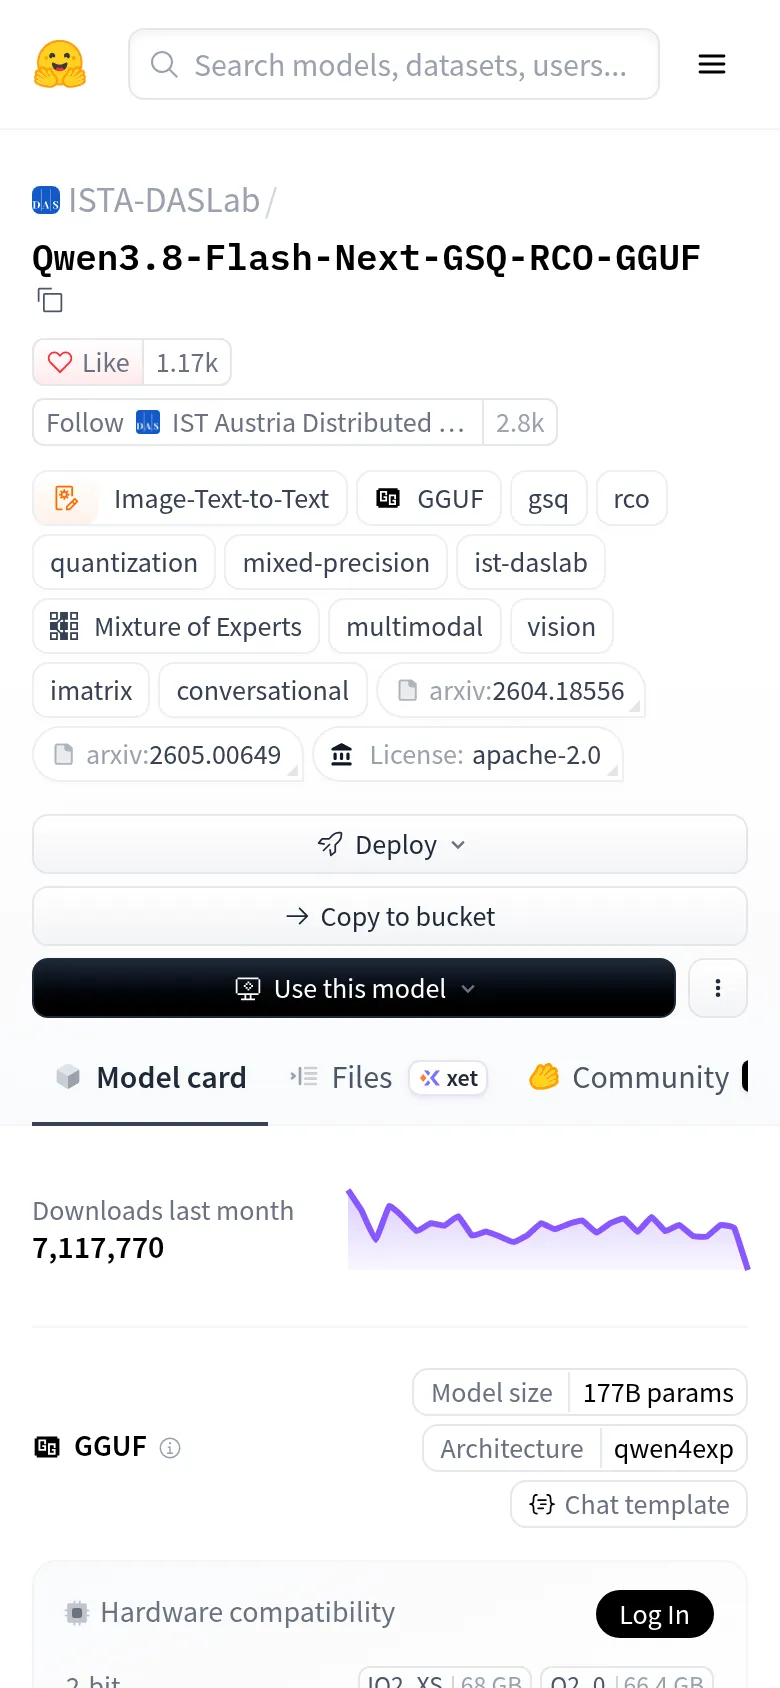
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.ggufISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF는 지난달 다운로드 7,117,770회를 기록한 저장소예요(2026-11-06 기준). 이스트 오스트리아 과학기술원(ISTA)의 DASLab이 만들었고, 원본 Qwen3.8-Flash-Next는 512개 전문가 × 48층 MoE 모델이에요.
먼저 비유 하나로 잡고 갈게요. 양자화는 이삿짐 싸기와 비슷해요. 짐(가중치)이 트렁크(메모리)에 다 안 들어가면, 물건마다 “버릴까, 압축팩에 넣을까”를 정해야 하죠.
- 균일 양자화는 모든 짐을 똑같은 압축팩에 넣는 방식이에요. 간단하지만 깨지기 쉬운 물건도 같이 눌려요.
- GSQ-RCO는 깨지기 쉬운 물건에 완충재를 몰아주고, 튼튼한 물건은 최대한 눌러 담아요. 트렁크 용량(=파일 크기)은 그대로예요.
여기서 텐서는 짐 하나하나예요. 모델 안의 숫자 덩어리(행렬)이고, 양자화는 이 덩어리마다 몇 비트로 담을지 정하는 일이에요. 비트는 숫자 하나를 몇 칸으로 표현할지예요 — 16비트면 정밀하게, 3비트면 거칠게 담아요.
균일 양자화의 한계
기존 GGUF 양자화는 대개 모든 가중치에 같은 방식을 적용해요. Q4_K면 전부 4.5비트죠. 만들기 쉽고 결과를 예측하기도 쉬워요. 대신 모델 안의 텐서들이 양자화에 똑같이 민감하지 않다는 사실은 무시해요.
GSQ-RCO 문서는 이 지점을 정면으로 공략해요. “균일 양자화는 모든 가중치 텐서에 하나의 양자화 타입을 적용하지만, 여기서는 텐서마다 별도 타입을 배정한다”고 명시하죠. 배정은 감도(sensitivity) 기반 경사 탐색으로, 총 크기 예산을 지키면서 이뤄져요.
역할은 이렇게 나뉘어요. 하나는 창고 정리 담당(GSQ), 다른 하나는 예산 배분 담당(RCO)이에요.
| 이름 | 정식 명칭 | 하는 일 |
|---|---|---|
| GSQ | Gumbel-Softmax Quantization | 텐서 하나를 주어진 비트 타입으로 정확하게 담는 법 — 좌표별 격자 배정과 그룹별 스케일을 함께 학습 |
| RCO | Riemannian Constrained Optimization | N개 텐서 중 각각에 K종 타입 중 무엇을 줄지 예산 제약 하에 결정 |
RCO 쪽 계산이 특히 흥미로워요. “텐서마다 타입 하나 선택”은 원래 경우의 수를 세는 조합 최적화라 미분이 안 되는데, 이걸 로짓 공간의 리만 다양체로 바꿔서 과제 손실에 대해 직접 경사 하강을 돌려요. 예산은 정확히 지켜지고, 제약 전용 하이퍼파라미터를 안 만져도 돼요. 두 방법 모두 논문과 코드가 공개돼 있어요(GSQ arXiv 2604.18556, RCO arXiv 2605.00649).
결과 — 354GB가 75.8GB로
모델 카드의 표를 그대로 옮기면 이래요. 기준은 BF16 원본이에요.
| 변형 | 평균 비트 | 크기 | 과제 평균 | 원본 대비 |
|---|---|---|---|---|
| BF16 원본 | 16.00 | 354GB | 93.12 | 100% |
| Q2_0 | 2.40 | 66.4GB | 89.07 | 95.6% |
| IQ2_XS | 2.50 | 68.0GB | 89.16 | 95.7% |
| IQ3_XXS | 3.00 | 75.8GB | 92.57 | 99.4% |
| IQ3_S | 3.50 | 83.6GB | 93.26 | 100.1% |
3비트로 4.7배 작게 담고도 과제 평균의 **99.4%**를 유지해요. AIME25는 원본과 정확히 같은 100.00이고요. IQ3_S는 GPQA-Diamond에서 원본(91.92)보다 높은 92.93을 기록했는데, 문서는 이걸 “성능 향상이 아니라 벤치마크 분산”이라고 스스로 정정해요. 이 정도로 자기 숫자에 보수적인 문서는 드물어요.
두 조각의 정체 — 00001-of-00002
파일명의 00001-of-00002는 파일이 두 조각이라는 뜻이에요. 그런데 두 번째 조각(28.8GB)이 좀 특이해요. 이건 가중치가 아니라 n-gram 임베딩 룩업 테이블(51.2B 파라미터)이에요. 행렬 곱이 아니라 표에서 한 줄씩 찾아 읽는 구조라, 검색 대상에서 제외하고 모든 변형에서 IQ4_NL(4.5비트) 고정이에요.
그래서 메모리 설계가 갈라져요. 실제로 상주해야 하는 건 첫 조각(가중치)뿐이고, 두 번째 조각은 디스크에 두고 필요할 때 읽어도 돼요. 카드가 권하는 실행 옵션도 그것이에요 — -lm mmap --lazy-mode on.
| 변형 | 상주해야 함 | 디스크에 둘 수 있음 | 전체 다운로드 |
|---|---|---|---|
| Q2_0 | 37.6GB | 28.8GB | 66.4GB |
| IQ3_XXS | 47.0GB | 28.8GB | 75.8GB |
| IQ3_S | 54.8GB | 28.8GB | 83.6GB |
즉 “75.8GB 모델”을 돌리려면 VRAM에는 47GB만 있으면 돼요. 24GB 카드 한 장으로는 부족하지만, 48GB 카드라면 첫 조각이 들어가요.
대가 — 같은 비트라도 포맷이 속도를 바꾼다
여기가 실무에서 가장 값진 부분이에요. 문서는 Q2_0(2.40비트)과 IQ2_XS(2.50비트)를 나란히 놓고 비교해요. 크기는 Q2_0이 더 작은데, 속도가 3배 이상 차이 나요.
| 지표 | Q2_0 | IQ2_XS |
|---|---|---|
| 프롬프트 처리 | 367.49 t/s | 108.19 t/s |
| 생성 속도 | 93.79 t/s | 70.30 t/s |
| 평균 지연 | 6.70초 | 12.68초 |
| 생성 속도 편차(11개 분야) | 2.0 t/s | 45.1 t/s |
이유는 룩업 테이블이에요. IQ 계열은 큰 룩업 테이블을 써서 같은 비트에서 정확도가 높지만, 디코딩할 때 테이블을 읽는 비용이 붙어요. 이 모델에서는 그 비용이 추론 속도를 지배해요. Q2_0은 그 포맷을 피해서 빨라진 대신 정확도를 조금 내줬어요(89.07 대 89.16).
특히 눈여겨볼 건 마지막 줄이에요. IQ2_XS의 생성 속도는 분야에 따라 49.4에서 94.5까지 흔들려요(편차 45.1). 요청이 층을 얼마나 건드리느냐에 따라 룩업 비용이 달라지기 때문이에요. 반면 Q2_0은 92.5~94.5로 거의 평평해요. 평균 속도보다 편차가 사용감을 좌우하는 경우가 있다는 걸 보여 주는 숫자예요.
실무 체크리스트
파일 이름과 모델 카드만으로 판단할 수 있는 것들이에요.
- 평균 비트와 총 크기를 먼저 본다 —
IQ3_XXS는 3.00비트, 75.8GB. 이름과 크기가 맞는지 검산해요. - 샤드 수를 확인한다 —
00001-of-00002면 첫 조각만 상주하면 되는 경우가 많아요. - 무엇이 상주해야 하는지 카드에서 찾는다 — 이 모델은 가중치 47GB만 VRAM에, 룩업 28.8GB는 디스크에.
- 포맷 특성을 확인한다 — IQ 계열은 정확, 단순 포맷은 빠름. 같은 비트라도 체감 속도가 2~3배 갈려요.
- 라이선스를 본다 — 이 저장소는 apache-2.0이지만, 파생물은 원본 조건을 따라가요.
정리
GSQ-RCO는 마케팅 단어가 아니라 두 단계 양자화 파이프라인의 이름이에요. GSQ가 “주어진 비트로 정확하게 담기”를, RCO가 “어디에 몇 비트를 줄지”를 맡아요. 그 결과 같은 3비트에서 기존 방식보다 원본에 가까운 성능이 나와요.
이름을 읽는 법을 익히면, 다음엔 숫자 뒤의 방법을 읽게 돼요. 로컬 모델을 고르는 실력은 결국 그 차이에서 갈리는 것 같아요.
- 저장소: ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- GSQ 논문·코드: arXiv 2604.18556 · github.com/IST-DASLab/GSQ
- RCO 논문·코드: arXiv 2605.00649 · github.com/IST-DASLab/RCO
- 이름 읽는 법: 모델 이름 60자, 어디까지 읽어야 하나