모델 이름 60자, 어디까지 읽어야 하나
한 줄 요약: 허깅페이스의 긴 모델 이름은 광고 문구가 아니라 라벨이에요 — 앞은 원본 모델, 가운데는 무엇을 어떻게 바꿨는지(도구·기법·점수), 끝은 파일 형식과 압축률이에요. 60자짜리 실제 사례 하나를 토큰별로 해부해 읽는 순서를 정리했어요.
허깅페이스를 뒤지다 보면 이름이 이렇게 긴 모델을 만나요.
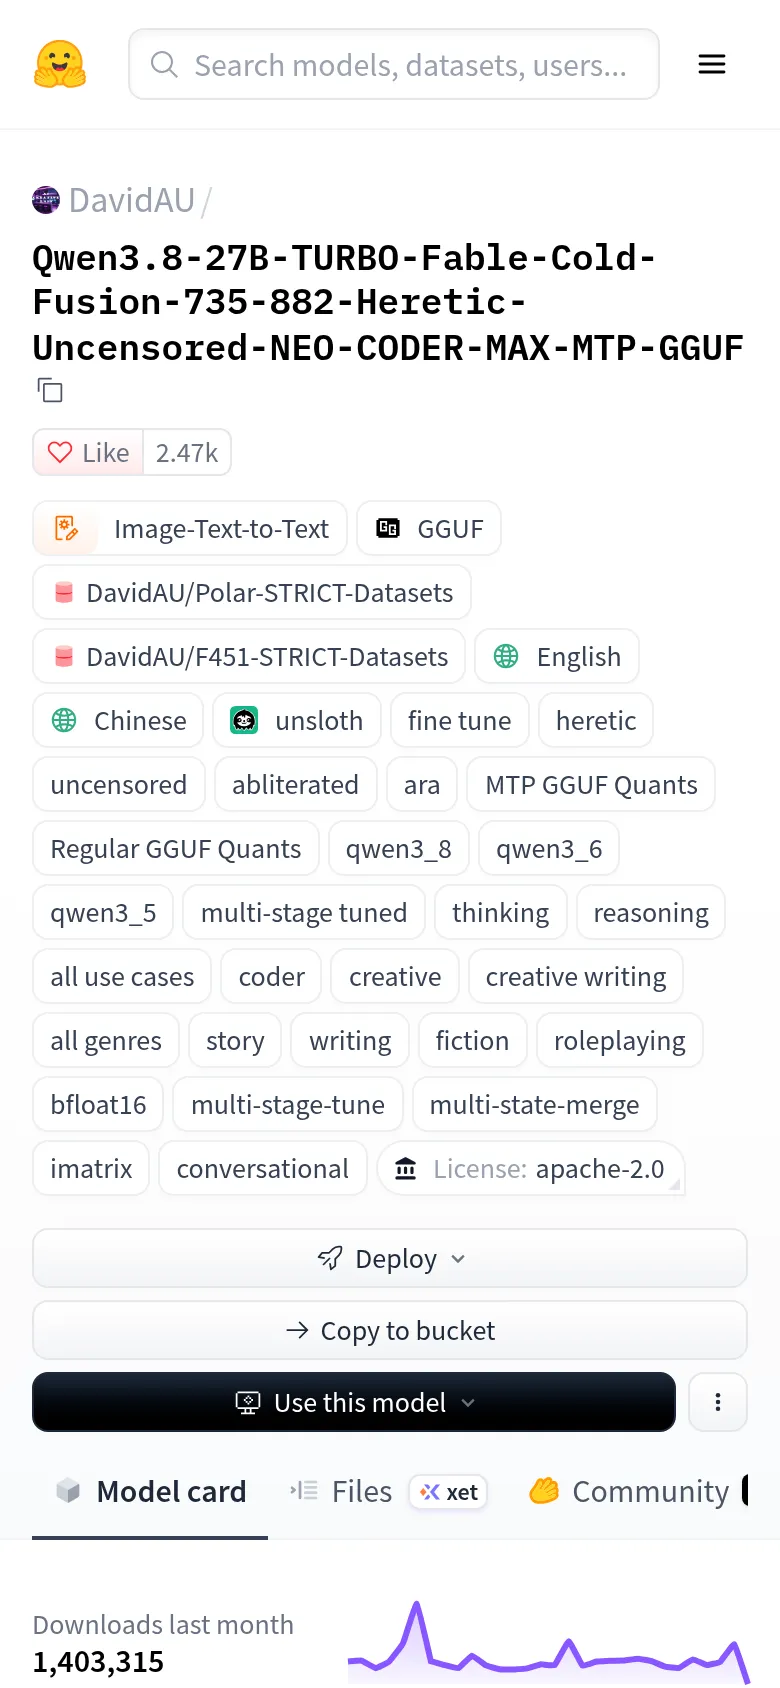
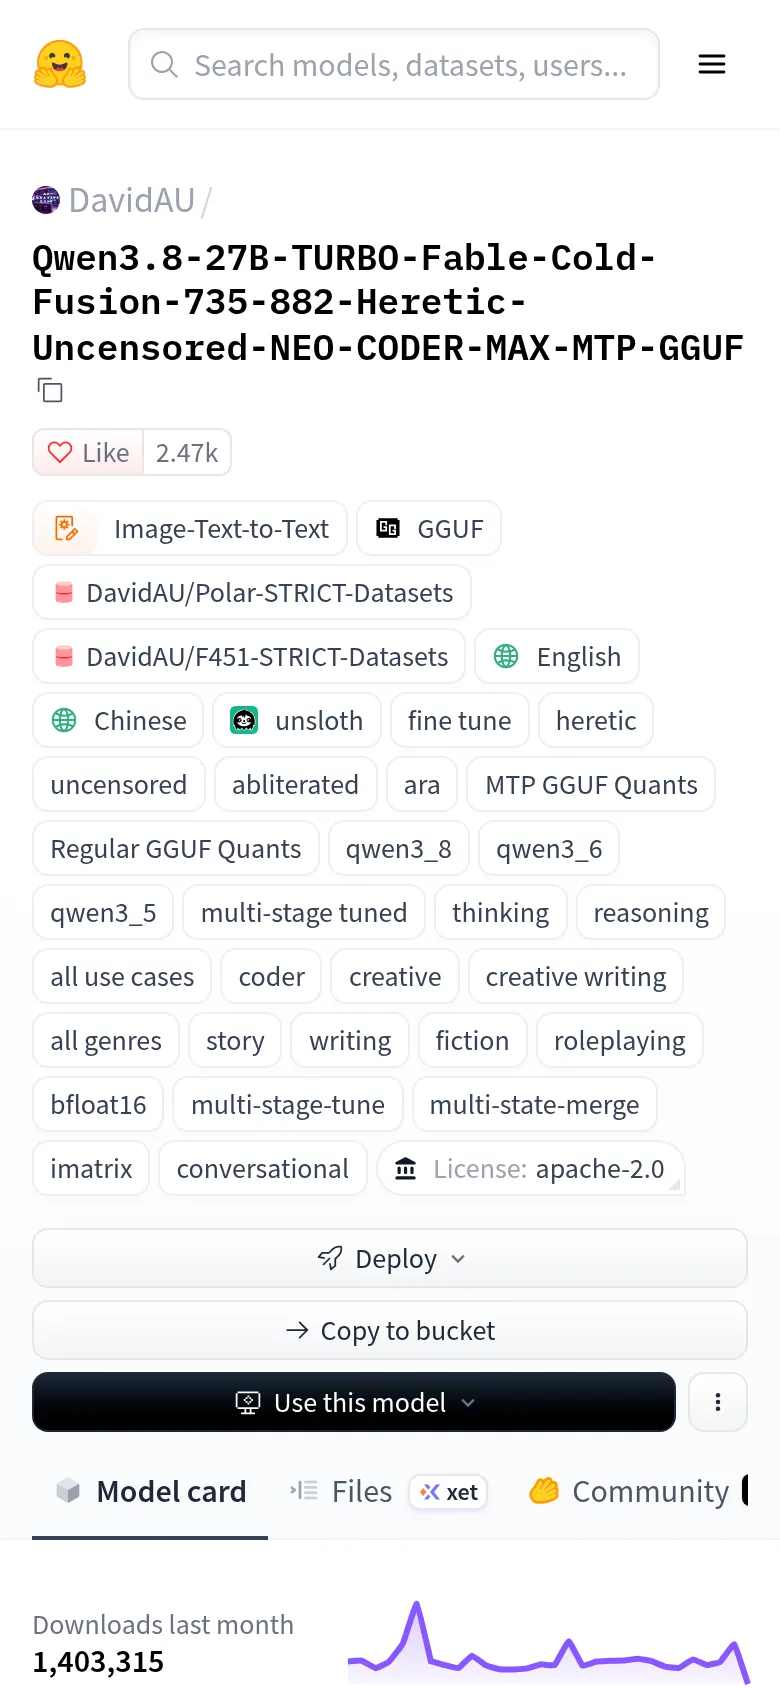
DavidAU/Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882
       -Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF
이걸 다 읽어야 하나 싶지만, 순서만 알면 3초면 판독돼요. 이 모델은 지난달에만 다운로드 1,403,315회를 기록했어요(허깅페이스 API, 2026-11-04 기준). 꽤 많이 쓰이는 이름이라는 뜻이죠. 모델 카드와 각 도구의 공식 문서를 대조해서, 이름의 각 조각이 실제로 무엇을 뜻하는지 확인해 봤어요.
1단계 — 앞은 원본이다
Qwen3.8-27B는 원본 모델이에요. 알리바바 큐웬의 27B 모델이죠. 이름 앞부분이 원본이고, 그 뒤에 붙는 모든 것이 남이 가한 변형이에요. 그래서 모델 이름을 볼 때 가장 먼저 확인할 것은 “누구 것을 얼마나 손댔나”예요.
이 모델을 올린 DavidAU는 변형 모델을 전문으로 올리는 계정이에요. 원본 저장소(Qwen/Qwen3.8-27B)는 지난달 다운로드가 800만 회를 넘었고, 이 변형판은 그 6분의 1 수준이에요.
2단계 — 가운데는 “무엇을 했나”
여기가 이름이 길어지는 구간이에요. 조각마다 성격이 달라요.
| 토큰 | 실제 의미 | 근거 |
|---|---|---|
| Heretic | 거부 반응을 없애는 도구 이름 | p-e-w/heretic ★3.9만, AGPL-3.0 |
| Abliterated | 거부 방향을 지우는 기법 | Arditi et al. 2024 — arXiv 2406.11717 |
| Uncensored | 기술 용어 아님 — 사실상 마케팅 표기 | 문서상 정의 없음 |
| MTP | 멀티 토큰 예측 — 속도를 위한 추가 헤드 | 이 블로그 colibrì 글의 실측 참고 |
| 735 / 882 | 제작자가 주장하는 벤치마크 점수 | 모델 카드 서술, 자체 보고 |
| TURBO / COLD FUSION / NEO-CODER / MAX | 제작자의 훈련 레시피·브랜딩 | 모델 카드 서술 |
몇 개는 더 풀어 볼 만해요.
Heretic은 단순한 수식어가 아니라 도구 이름이에요. GitHub에서 ★3만 9천을 받은 프로젝트로, 스스로를 “학습 없는(training-free) 언어모델 수정 도구”라고 소개해요. 거대 컴퓨팅 없이도 기업만 하던 모델 수정을 하게 해 준다는 게 표어죠. 방식은 두 가지예요 — Heretic 자체 개발한 **임의 랭크 제거(ARA)**가 기본이고, 전통적인 **방향성 제거(abliteration)**도 지원해요. 둘 다 가중치를 학습시키는 게 아니라, 거부 반응을 만드는 방향을 찾아 그 방향 성분을 깎아내는 수학적 조작이에요.
Abliterated는 그 기법의 결과물이에요. 2024년 Arditi 등의 연구에서 출발했고, 지금은 투영(projected) 방식이나 노름 보존(MPOA) 같은 개선판이 나와 있어요. Heretic 문서에도 그 두 가지 변형이 각각 참조로 걸려 있어요.
TURBO와 735·882는 모델 카드에 설명이 있어요. 제작자에 따르면 735는 ARC-C 점수, 882는 ARC-E 점수이고, TURBO는 사고 토큰을 절반에서 10분의 1까지 줄였다는 뜻이에요. COLD FUSION·FABLE FUSION은 그가 쓰는 훈련 레시피 이름이에요. 정리하면 브랜딩처럼 보이는 토큰 중 일부는 숫자 근거가 있고, 일부는 그냥 별명이에요. 이 구분은 이름만 봐서는 불가능하고 모델 카드를 열어야 알 수 있어요.
3단계 — 꼬리는 파일 형식과 압축률
맨 끝 GGUF는 파일 형식이에요. llama.cpp 계열에서 쓰는 양자화 컨테이너죠. 같은 저장소에 Q4_K_M이나 IQ3_XXS처럼 압축률이 다른 파일이 여러 개 올라와 있어요.
허깅페이스 문서의 양자화 표를 보면 각 표기가 실제 비트 수로 이어져요.
| 표기 | 실효 비트/가중치 | 비고 |
|---|---|---|
| IQ2_XXS | 약 2.06 | 중요도 행렬(imatrix) 사용 |
| Q4_K | 약 4.5 | 슈퍼블록 8개 × 32가중치 |
| Q5_K | 약 5.5 | 같은 구조, 더 높은 정밀도 |
이 숫자로 파일 크기를 검산할 수 있어요. 27B 모델을 4.5비트로 담으면 27e9 × 4.5 / 8 ≈ 15.2GB예요. 실제 Q4_K_M 파일이 15GB 안팎이라면 표기와 맞는 거고, 20GB가 넘으면 다른 설정이 섞인 거예요. 다운로드 전에 이름과 파일 크기가 맞는지 보는 것이 가장 빠른 검증이에요.
4단계 — 이름이 말해 주지 않는 것
이름이 친절한 만큼, 이름이 감추는 것도 있어요.
- 다운로드 수 ≠ 품질: 140만 다운로드는 인기 지표예요. 품질 지표가 아니에요.
- 벤치마크는 자체 보고: 735·882는 제작자가 올린 수치예요. 독립 재현 결과가 이름에 붙는 경우는 드물어요.
- 거부 제거의 대가: Heretic 문서는 도구가 거부 반응을 줄이는 대신 다른 능력이 흔들릴 수 있다는 점을 다뤄요. 이름에는 그 손실이 안 적혀 있어요.
- 라이선스는 계승: 이 모델 카드는 apache-2.0으로 표기돼 있지만, 파생 모델의 조건은 원본 조건을 따라가요. 상업적 사용 전에는 원본 라이선스를 확인해야 해요.
정리 — 3초 판독 순서
- 앞: 원본 모델이 무엇인가 (
Qwen3.8-27B) - 가운데: 어떤 도구·기법으로 무엇을 바꿨나 (
Heretic,Abliterated,MTP) - 꼬리: 파일 형식과 압축률 (
GGUF,Q4_K_M) → 파일 크기로 검산 - 나머지: 제작자 브랜딩 — 모델 카드에서만 의미를 확인
이름이 길다는 건 그만큼 손댄 흔적이 많다는 뜻이에요. 흔적 읽는 법을 익히면 60자짜리 이름이 한 줄짜리 정보가 돼요. 낯선 모델을 만났을 때 가장 먼저 볼 것도 결국 이 세 조각이에요.
- 사례 모델: DavidAU/Qwen3.8-27B-TURBO-…-GGUF
- Heretic: github.com/p-e-w/heretic
- 양자화 표기: huggingface.co/docs/hub/gguf
- 거부 방향 연구: arXiv 2406.11717