USB 하나로 인터넷 없이 AI 돌리기
한 줄 요약: USB 드라이브 하나만으로 인터넷 없이 LLM 채팅을 돌리는 포터블 환경은 실제로 존재하는데, 휴대용 파이썬과 Ollama 엔진, GGUF 모델을 폴더 규칙 하나로 묶은 프로젝트이며, 릴스가 소개한 원 저장소는 7월에 개발이 중단돼 후속 프로젝트로 옮겨갔다는 점까지 알아야 해요.
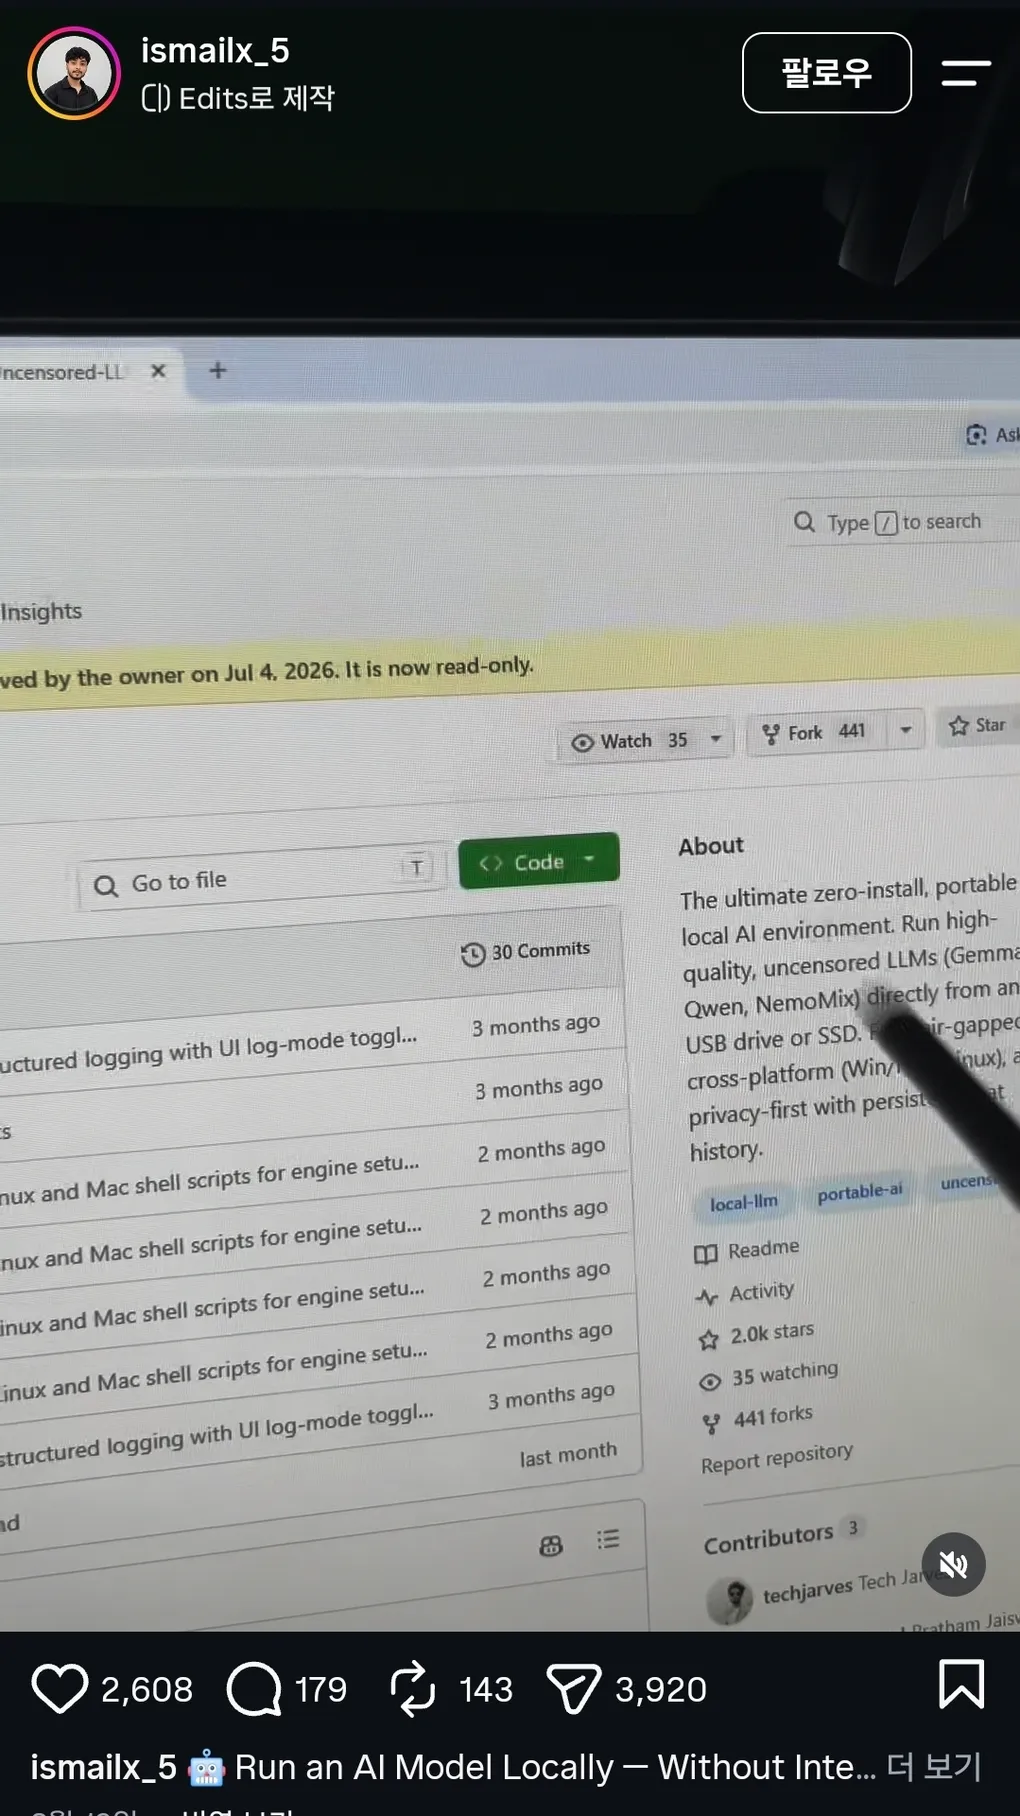
ismailx_5님이 올린 릴스예요. 제목은 “Run an AI Model Locally — Without Internet!“이고, 캡션에는 오프라인 동작·내 기기 실행·데이터 통제·클라우드 계정 불필요가 체크리스트로 적혀 있어요. 화면에 잡힌 GitHub 저장소를 확인해 보니 techjarves의 USB-Uncensored-LLM예요. 2026년 4월 14일에 만들어져 스타 약 2,000개, 포크 470여 개를 받은 프로젝트고요. 소개는 “궁극의 제로설치 포터블 로컬 AI 환경”으로, 에어갭(인터넷 분리) 상태의 USB나 SSD에서 검열 없는 LLM(Gemma, Qwen, NemoMix)을 바로 실행한다는 내용이에요. README 전문을 확인해 검증했는데, 릴스가 다루지 않은 중요한 변화가 하나 있어서 이 글에서 같이 다뤄요.
USB 꽂으면 채팅 화면이 뜬다
이 프로젝트의 구조는 ’설치를 없애는 설계’예요. USB 안에 운영체제별 폴더(Windows·Mac·Linux·안드로이드 Termux)와 Shared라는 공용 폴더가 나뉘요. 공용 폴더에는 각 OS용 엔진 실행 파일, 대화 기록, 모델 가중치, 휴대용 파이썬 환경이 들어가죠. 사용법은 세 단계예요. 접속한 컴퓨터의 OS 폴더에서 install 스크립트를 돌리면 그 컴퓨터에 맞는 50MB짜리 엔진만 Shared/bin 폴더에 받고, 모델을 내려받은 뒤 start 스크립트를 실행하면 로컬 파이썬 서버가 채팅 UI를 띄우는 거예요. 시스템 설정 수정이나 패키지 관리자가 필요 없어요.
흥미로운 설계가 두 가지 보여요. 첫째, 엔진은 커스텀 컴파일된 Ollama로, 꽂힌 컴퓨터에 따라 CPU의 AVX 명령어, NVIDIA CUDA, 애플 Metal을 자동으로 골라 어요. 둘째, 모델 가중치는 한 번만 받아 두 OS에서 같이 쓰는 Shared 폴더 구조라, 5GB가 넘는 모델을 OS마다 복제하지 않아요. 같은 WiFi에 연결된 폰으로도 접근할 수 있어서(포트 3333) 소파에서 노트북의 무거운 모델을 쓰는 것도 돼요.
모델은 어떻게 담을까
담는 것은 GGUF 형식의 모델 가중치예요. 기본 카탈로그는 세 개예요. Gemma 2 2B Abliterated(약 1.6GB)는 가볍고 빨라서 모두에게 권장 모델이고, Gemma 4 E4B Heretic(약 5.34GB)과 Qwen 3.5 9B Uncensored(약 5.2GB)는 더 크고 유능한 모델이에요. HuggingFace의 어떤 .gguf 가중치든 직접 넣을 수도 있어요. RAM 요건도 README가 분명히 밝혀요. 2B·4B 모델은 8GB 작업대면 돌지만, 9B·12B 모델을 부드럽게 돌리려면 16GB 작업대가 필요하다는 식이에요. 재미있는 것은 안드로이드 지원이에요. Termux로 폰에서 직접 돌릴 수 있는데, 2B 모델 기준 초당 3~10토큰으로 노트북 대비 느리지만 ’폰 하나가 곧 에어갭 AI’가 된다는 점이 매력이에요.
’검열 없는’의 정확한 뜻
이 프로젝트의 키워드인 ’검열 없는(uncensored)’은 기술적으로 정의된 상태예요. Abliterated 모델은 안전 정렬(safety alignment)을 담당하는 벡터를 가중치에서 수학적으로 제거해, 거부 반응 자체를 지워 버린 모델이에요. Heretic 파인튜닝은 더 나아가 어떤 질문이든 내용·적법성과 무관하게 순응하도록 만든 파인튜닝이고요. README도 이 시스템은 도덕적 설교나 거부를 하지 않는다고 못 박고 있어요.
이런 모델이 존재하는 이유는, 정렬된 모델들이 무해한 실무 요청까지 과잉 거부하는 사례가 많았기 때문이에요. 다만 양날의 검이에요. 거부가 없다는 건 유해하거나 불법적인 요청도 그대로 수행한다는 뜻이고, 그 책임은 전적으로 사용자에게 있어요. 반대로 데이터 쪽은 오프라인 구조라 유리해요. 에어갭 상태면 프롬프트가 클라우드로 나갈 경로 자체가 없으니까요. 도구는 중립이고 책임이 사용자에 있다는 게 이 프로젝트의 입장이에요.
릴스가 안 알려준 것
스크린샷에 노란 배너로 보이는 문장이 핵심이에요. “2026년 7월 4일에 소유자가 아카이브했으며 현재 읽기 전용”이라는 뜻이에요. README 상단에도 이 저장소는 폐기(deprecated)됐고 개발이 옮겨갔다고 명시돼 있어요. 후속 프로젝트는 Uncensored-Local-Studio로, 2026년 6월 4일 생성돼 스타 1,300개를 넘겼어요. 범위도 넓어졌어요. LLM 채팅에 이미지 생성(Stable Diffusion), 음성 인식(Whisper), 음성 합성(Kokoro)을 얹은 로컬 AI 스튜디오가 됐고, 엔진도 Ollama에서 llama.cpp로 바뀌었으며 MIT 라이선스로 공개돼 있죠. 즉 릴스가 소개한 USB 버전은 1세대이고, 지금 프로젝트의 본진은 후속 저장소예요. 따라 하실 거라면 원 저장소가 아니라 후속 저장소에서 최신 버전을 받아야 해요.
어떻게 연결되나
이 릴스의 체크리스트(오프라인·내 기기·데이터 통제·계정 불필요)는 사실이고, 에어갭 AI라는 수요도 실재해요. 프라이버시가 중요한 문서 작업, 인터넷이 끊긴 재난 상황, 검열 없는 로컬 실험 같은 용도죠. 이전 글들과 이으면 그림이 완성돼요. 로컬 LLM의 문턱은 메모리와 엔진이었는데, 이 프로젝트는 엔진·모델·UI를 USB 하나에 포장해 문턱을 ’설치조차 필요 없음’까지 낮춘 사례예요. 다만 두 가지는 기억하세요. 릴스의 저장소는 이미 개발이 멈췄으니 후속 저장소로 가야 하고, ‘검열 없는’ 모델은 편의가 아니라 책임이 사용자에게 온다는 뜻이라는 점이에요.
이 글의 출처