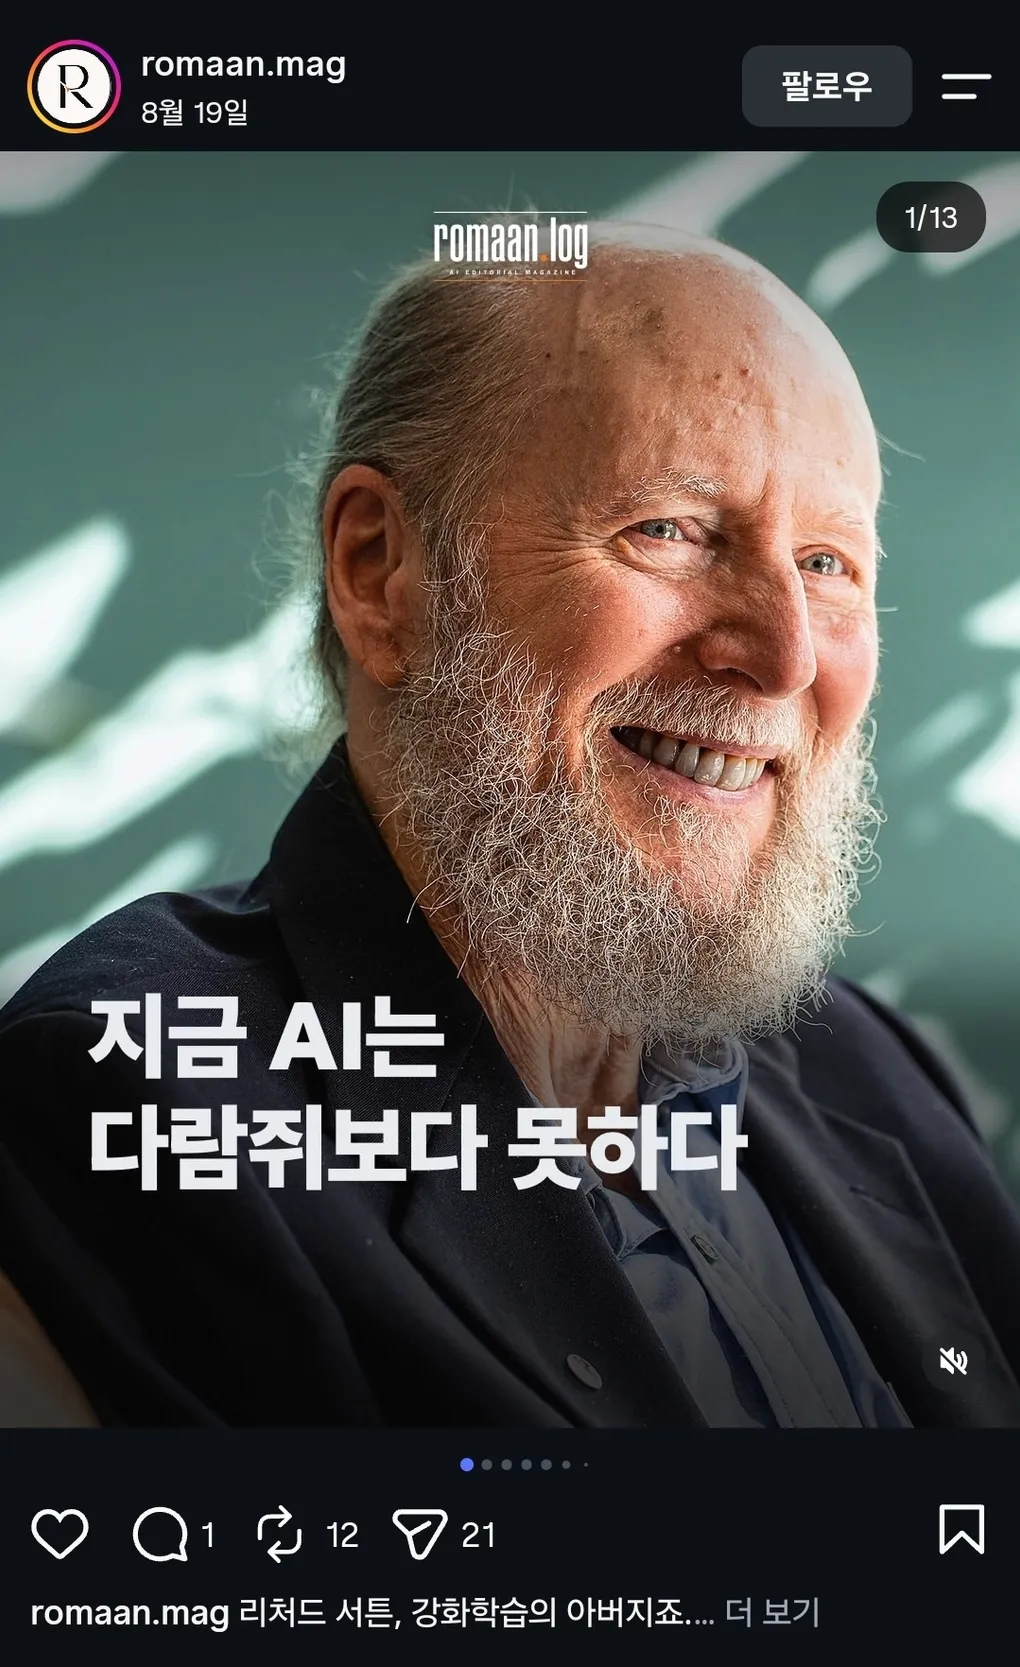
지금 AI는 다람쥐보다 못하다, 서튼의 이유
한 줄 요약: 서튼의 주장은 단순해요. LLM은 사람의 기록을 모방하는 도구일 뿐 지능은 경험에서 오는데, 보고 행동하고 보상받는 흐름에서 스스로 배우는 강화학습이 바로 그 기본이라는 것이에요.
다람쥐보다 못하다는 말
romaan.mag가 올린 릴스예요. 이 계정의 romaan.log 에디토리얼 시리즈는 AI 거물의 발언을 10여 장의 슬라이드로 정리하는 형식인데, 이번 주인공은 리처드 서튼이에요. 앨버타대 교수이자 앨버타 머신러닝 연구소(Amii) 수석 과학 고문이고, 앤드류 바토와 함께 받은 2024년 튜링상 시상 사유에는 “강화학습의 개척자”라고 적혀 있어요. 2019년 에세이 “The Bitter Lesson”의 저자이기도 하죠. 나이는 일흔에 가깝아요(68~69세).
커버 문구가 이 릴스의 요약이에요. “지금 AI는 다람쥐보다 못하다.” 다람쥐는 자기 세계에서 스스로 경험하며 배우는 주체인데, 지금 AI는 그렇지 못하다는 논지예요. 계정이 서튼의 발언을 번역해 정리한 것이라 문장을 다듬어 옮길 테니, 원문 톤과는 차이가 있을 수 있어요. 12개 포인트를 순서대로 풀어 보겠어요.
기본적인 AI는 강화학습
서튼의 출발점은 정의예요. 지능이란 자기 세계를 이해하는 것이라고 보고, 강화학습이 바로 그 이해 방식이라고 봐요. 반면 LLM은 사람을 모방하는 것에 불과하다고, 무엇을 해야 할지 스스로 알아내는 것과는 무관하다는 거죠.
World Model(세계 모델) 개념으로 이 간극을 설명해요. World Model이 있다는 건 앞으로 무슨 일이 일어날지 예측할 수 있다는 뜻인데, LLM은 사람들이 한 말을 그대로 재현하도록 배운 것이라 World Model을 만드는 것과 전혀 달라요. 사람으로 치면, 책을 통째로 외운 사서와 비가 오면 길이 어떻게 변하는지 아는 사람의 차이예요. LLM은 사람이 말하라고 할 때만 예측하고, 앞으로 세상이 어떻게 굴러갈지는 예측하지 않죠. 서튼은 애초에 튜링이 구상한 것도 강화학습으로 배우는 기계였다고 말하고, LLM은 “이런 상황에서 사람은 이렇게 했다”는 기록에서 배우는 방식이라고 정리해요.
맞다 틀리다가 없는 LLM
세 번째 포인트는 개념 문제예요. 사전지식이란 정답이 될지에 대한 힌트, 문제를 풀기 전에 이미 가진 초기 믿음이에요. 가설이란 진짜 사실에 대한 첫 생각인데, 가설이 맞는지 틀린지 가릴 기준이 반드시 있어야 해요. 그런데 LLM 안에는 그런 정의가 없다는 거예요. 말해도 맞는 말인지 피드백을 받지 않고, 애초에 맞는 말의 정의 자체가 없으니 정답이 없고, 정답이 없으면 사전지식도 정할 수 없죠. 반면 강화학습에는 맞는 행동이 있어요. 보상을 가져다주는 행동이 맞는 행동이니까요.
네 번째 포인트에서 서튼은 존 매카시의 정의를 인용해요. “지능은 목표를 이루는 능력의 계산적인 부분.” 목표가 없으면 지능이라 부를 계산이 없다는 거죠. LLM의 다음 토큰 예측은 자기가 다음에 할 말을 그리는 것뿐이고, 자기 행동에 세상이 어떻게 반응할지가 아니니, 예측하고 스킬을 만족하는 건 목표가 아니라는 거예요.
아이는 모방으로 배우지 않는다
다섯 번째는 그의 유명 글 “The Bitter Lesson”을 다시 꺼내요. 사람 지식보다 연산과 학습의 결합이 이긴다는 관점인데, LLM이 그 사례였지만 막대한 컴퓨트를 쓰면서도 방대한 사람 지식을 흡수하는 방식이라고 지적해요. 그래서 사람 지식 없이 스스로 경험에서 배우는 시스템이 다음이라고 봐요. 확장 가능한 방법이란 경험에서 배우는 것, 이것저것 해보고 결과를 보는 것이라 누가 알려줄 필요가 없다는 거죠.
근거로 아이를 어요. 아이들은 모방으로 배우지 않아요. 그냥 이것저것 시도하고, 손을 휘두르고, 눈을 이리저리 움직이고, 소리를 낼 뿐이에요. 실제 행동에는 따라 할 모범도 예시도 없었는데 배우죠. 심리학적으로도 모방이라는 기본 학습 과정은 없다고 봐요. 있는 건 예측과 시행착오, 그리고 ’뭘 했고 그 결과가 있었다’는 기록뿐이라는 게 서튼의 설명이에요. 지도학습은 자연에서 일어나는 학습이 아니에요. 유아는 학교에 다니지 않는데도 세상에 대해 전부 배워요.
경험 패러다임
서튼이 ’경험 패러다임’이라 부르는 그림도 여기서 나와요. 동물의 생애 첫 순간부터 계속 일어나는 일은 하나의 흐름이에요. 무언가를 보고(감각), 무언가를 하고(행동), 그 결과를 받는다(보상). 평생 끝이 없는 흐름이죠. 지능이란 그 흐름 속에서 보상이 늘어나는 쪽으로 행동을 바꾸는 것이고, 지식이란 결국 그 흐름에 대한 진술이라는 거예요.
왜 이 방식밖에 없는지도 설명해요. 우리가 사는 세상은 너무 커서 미리 다 가르칠 수 없다는 거예요. 같은 일을 하는 사람들 중 누가 잘할지는 미리 예상할 수도, 전부 넣어둘 수도 없는 것들이죠. 모든 걸 가르친 에이전트는 배울 필요가 없는 존재가 되는데, 그렇게 만드는 건 불가능하니 결국 스스로 배우는 수밖에 없다는 논리예요.
언어는 껍질, 일반화는 방향
여덟 번째 포인트는 언어의 위상이에요. 언어가 인간을 동물과 구별해 주지 않는다는 게 서튼의 견해예요. 인간도 동물이니까요. 아이들을 이해하면 인간 지능도 거의 다 이해한 셈이라는 게 서튼의 시각이에요. 언어는 그 위에 살짝 얹혀진 겉껍질일 뿐이라고 보죠.
열한 번째는 일반화예요. 한 상태에서 배운 게 다른 상태로도 옮겨가는 것이 일반화인데, 문제는 방향이에요. 잘못된 쪽으로도 일반화될 수 있어요. 좋은 쪽으로 일반화되도록 만드는 방법은 우리에게 없고, 잘 되는 사람이 있다면 그건 설계 덕이 아니라 연구자가 이것저것 해보다 찾아낸 것이라는 게 서튼의 설명이에요.
단순한 원리가 이긴다
마지막 포인트는 서튼의 세계관을 보여 줘요. 탐색과 학습처럼 단순한 원리를 예전 사람들은 ’약한 방법’이라 불렀고, 사람 지식을 붙이는 쪽을 ’강한 방법’이라 불렀죠. 그런데 약한 방법이 완전히 승리했어요. 서튼은 놀랍지 않다고 해요. 늘 단순하고 기본적인 원리를 지지했으니까요. 지금이 유혹의 시기라고 말하면서, 사람들이 오래전부터 미래를 어떻게 그려왔는지를 돌아보라고 조언하는 걸로 이 릴스는 끝나요.
어떻게 연결되나
다람쥐라는 비유가 왜 나왔는지는 이쯤에서 맞춰져요. 다람쥐는 자기 세계에서 살아남는 법을 경험으로 배우는 주체고, 지금 AI는 그 경험 없이 사람의 기록을 모방하는 존재라는 거예요. 캡션도 같은 질문으로 마무리해요. AI는 스스로에게 잘 맞는 학습 방식을 찾을 수 있을까, 호기심을 가질 수 있을까, 가능하다면 인류와 전혀 다른 초지능 ’종’이 생기는 것 아닐까. 서튼과 데이비드 실버가 2025년에 쓴 “Era of Experience”가 바로 이 경험 패러다임을 제안한 글이고, 지난 글에서 다룬 Anima Anandkumar의 Neural Operator도 언어 모델 바깥쪽의 배움을 찾는다는 점에서 공명하지만, 물리 법칙이라는 가이드라인을 얹는다는 점에서 ’사람 지식 없이’가 원칙인 서튼과는 위치가 살짝 다르죠. 언어 모델의 스케일 경쟁 옆에서, 배움의 원리를 다시 묻는 흐름이 하나 더 있다는 것. 그게 이 릴스가 전하려는 그림이에요.
출처
- 게시물: romaan.mag, https://www.instagram.com/p/DcNyAcCEWh3/ (2026-09-08 접속, 릴스 12개 포인트 기준 — 계정의 번역·요약이라 문장은 다듬어 옮김)
- R. Sutton, “The Bitter Lesson” (2019)
- R. Sutton, D. Silver, “Welcome to the Era of Experience” (2025)
- ACM, “2024 ACM A.M. Turing Award — Andrew Barto and Richard Sutton Recognized as Pioneers of Reinforcement Learning” (2025-03 발표)
- Wikipedia, “Richard S. Sutton” — 1957/1958년생(2026년 기준 68~69세)