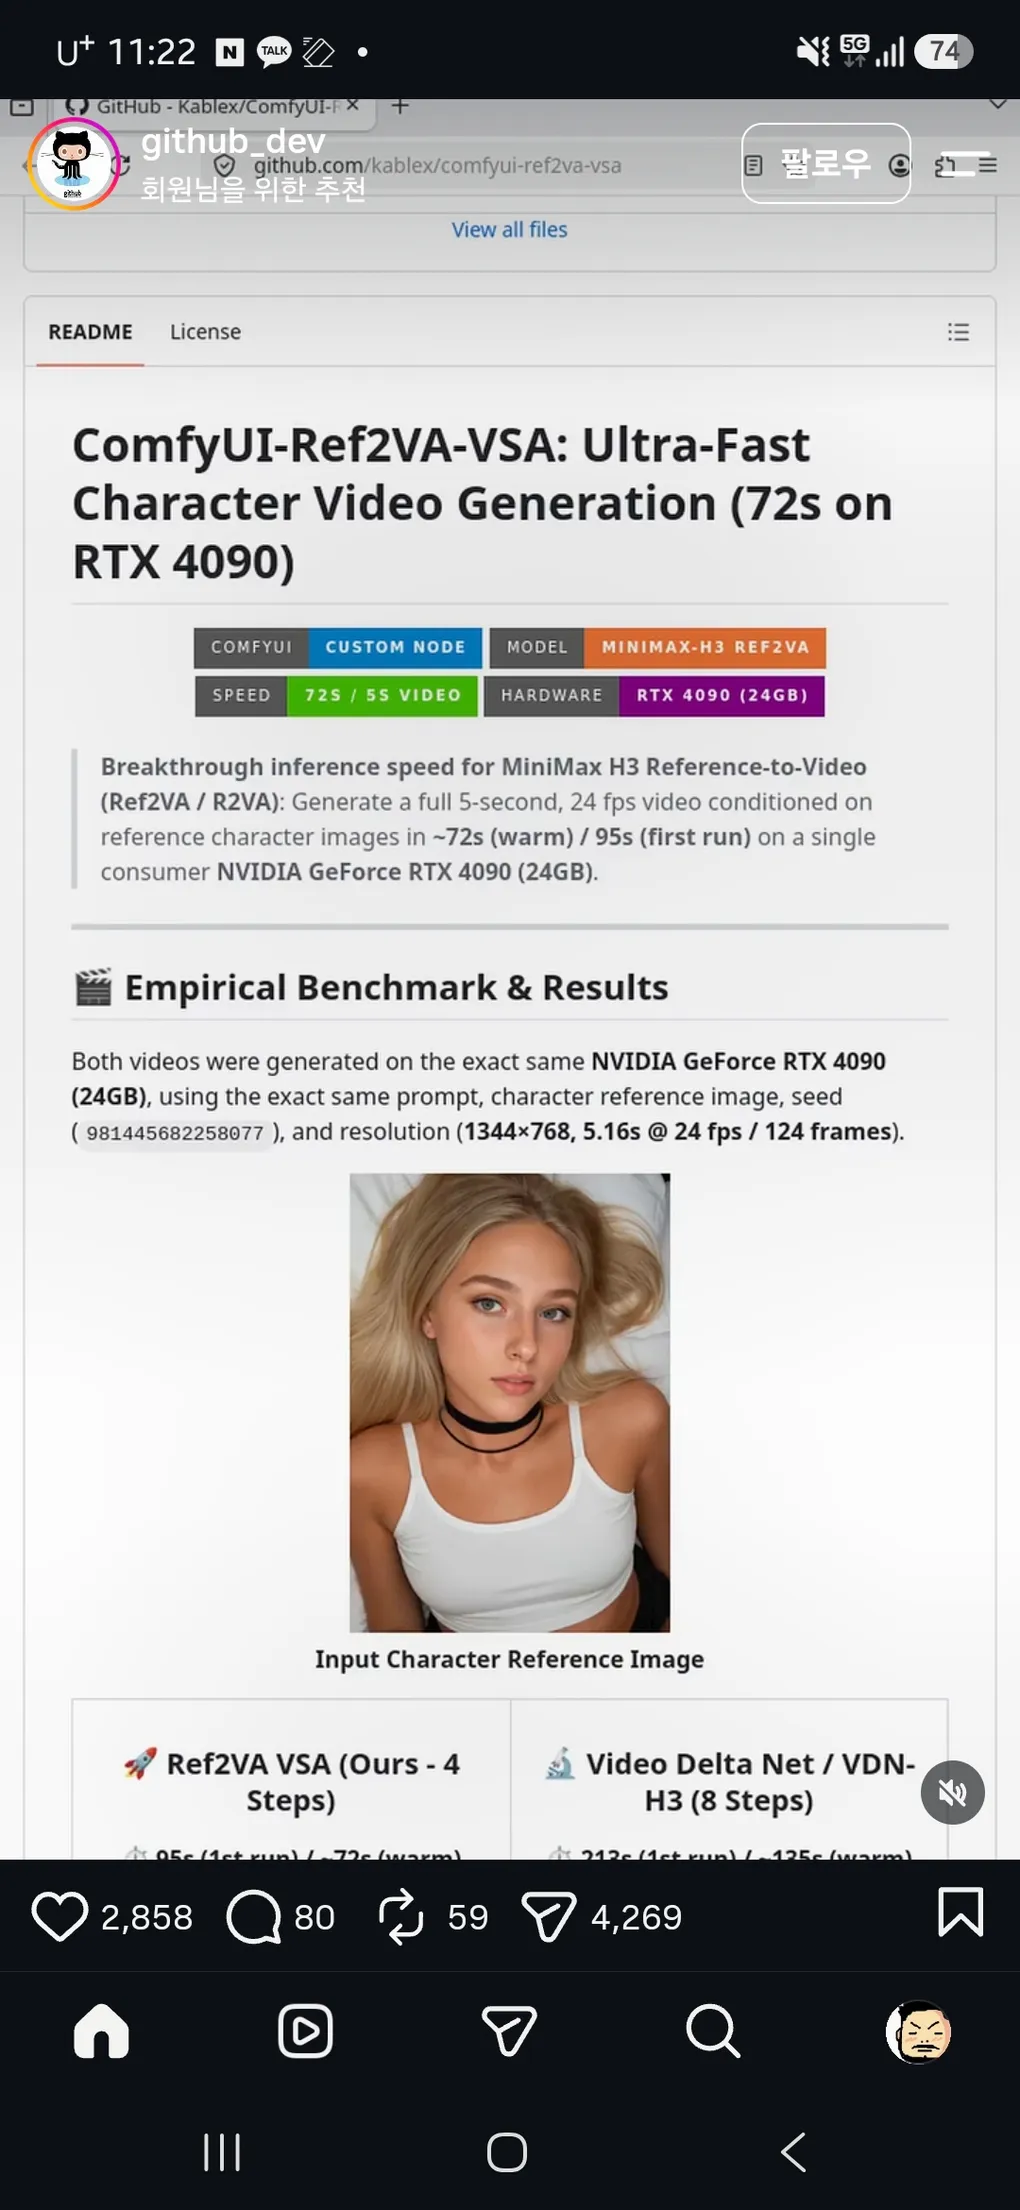
RTX 4090에서 5초 영상 72초: Ref2VA VSA
한 줄 요약: MiniMax H3의 레퍼런스 기반 영상 생성에 ’비디오 희소 어텐션’을 얹어 토큰의 75%를 건너뛰게 만든 ComfyUI 커스텀 노드 덕에, RTX 4090 한 장에서 5초짜리 인물 영상이 원본 대비 9배 빠른 약 72초 만에 나와요.
github_dev님이 올린 릴스예요. GitHub 저장소 Kablex/ComfyUI-Ref2VA-VSA의 README를 화면에 보여주는데, 2026년 9월 5일에 공개된 ComfyUI 커스텀 노드예요. 제목부터 “Ultra-Fast Character Video Generation (72s on RTX 4090)“이고, 소비자용 그래픽카드 RTX 4090(24GB) 한 장에서 5초짜리 24fps 영상을 워밍업 상태에서 약 72초, 첫 실행에서도 95초 만에 생성한다는 주장이에요. README의 벤치마크 표를 그대로 확인해 볼 수 있었고, 같은 조건(같은 프롬프트·레퍼런스 이미지·시드·해상도 1344×768)에서 나온 수치라 비교가 공정해요. 원리를 이해하려면 MiniMax H3라는 모델과 VSA라는 가속 기법 두 가지를 알아야 해서 순서대로 풀어 보겠어요.
MiniMax H3, Ref2VA가 뭔가요
MiniMax H3는 MiniMax가 오픈 가중치로 공개한 범용 옴니모달 생성 모델이에요. 텍스트·이미지·비디오·오디오를 함께 이해하고, 영상과 그 사운드트랙(목소리·효과음·음악)을 동시에 생성해요. Diffusers 문서 설명대로 하나의 트랜스포머가 텍스트 조건, 조건 미디어, 영상과 오디오의 잠재 표현(latent)을 하나로 묶은 시퀀스를 통째로 디노이즈하기 때문에 별도의 음성 합성기나 오디오 후처리 단계가 없고, 최대 2K 해상도 15초까지 만들 수 있어요.
Ref2VA는 그 모드 중 하나로 레퍼런스 투 비디오(Reference-to-Video)의 줄임말이에요. 인물 사진을 레퍼런스로 주면 그 캐릭터가 대사를 하고 움직이는 영상을 소리까지 함께 만들어 내는 모드예요. 릴스에 나온 금발 인물 사진이 입력으로 들어가고, 같은 인물이 움직이는 5초 영상이 결과로 나와요. FL2VA(텍스트·프레임 기반)와 함께 H3의 대표 모드이고, H3는 가중치가 공개돼 ComfyUI에서 네이티브로 지원돼요.
원본은 왜 10분이 걸리나
영상 생성 모델은 텍스트 모델보다 처리할 토큰이 훨씬 많아요. H3는 확산 트랜스포머(DiT) 방식으로, 노이즈를 조금씩 걷어내는 단계를 수십 번 반복하면서 매 단계마다 시퀀스의 모든 토큰 쌍이 서로를 바라보는 어텐션 계산을 해요. 이 비용은 토큰 수의 제곱에 비례해 늘어나고, Ref2VA는 여기에 조건 세그먼트(레퍼런스 이미지 잠재 표현, 레퍼런스 오디오 잠재 표현, 텍스트 프롬프트 토큰)가 생성 영상 시퀀스 앞에 덧붙어 시퀀스를 더 길게 만들어요. 그래서 README 표 기준으로 원본 밀집(dense) 방식은 50단계 디노이즈에 RTX 4090에서 약 650초, VRAM도 22.5GB까지 올라가요. 소비자 카드 한 장으로는 비실용적인 영역이었던 셈이죠.
토큰 75%를 건너뛰는 VSA
여기서 등장하는 게 VSA(비디오 희소 어텐션, Video Sparse Attention)예요. FastVideo 팀이 텍스트 투 비디오용으로 개척한 가속 기법으로, 토큰들을 4×4×4 크기의 시공간 타일로 묶은 뒤, 학습된 게이트(to_gate_compress라는 예측기)가 ’이번 토큰을 이해하는 데 중요한 타일’만 골라내고 나머지 타일은 어텐션 계산에서 건너뛰는 방식이에요. 75~90%를 건너뛰지만 골라내는 기준이 규칙이 아니라 학습된 값이라, 실제로 중요한 상호작용은 남겨요.
그런데 이 VSA를 Ref2VA에 그대로 쓰면 문제가 생겨요. 조건 세그먼트가 영상 앞에 붙어 있는 구조라 3차원 타일링을 하면 서로 다른 모달리티의 토큰들이 같은 타일에 섞이고, 조건 마스크가 오염돼 캐릭터의 동일성이 무너져요. 레퍼런스로 준 인물이 다른 사람처럼 그려지는 오류가 생기는 거예요.
조건 토큰은 왜 다르게 다루나
이 저장소의 해결책은 Ref2VAVSAGatePatch라는 패치로, 어텐션을 두 층으로 나눠요. 첫째, 텍스트·레퍼런스 이미지·레퍼런스 오디오 토큰은 세그먼트별로 순수한 타일에 격리해 100% 밀집 어텐션으로 유지하고 프루닝에서 완전히 면제해요. 캐릭터의 정체성을 지키는 조건이라 단 한 토큰도 희소화하면 안 되기 때문이에요. 둘째, 75% top-k 프루닝은 생성 영상의 키타일에만 엄격히 적용해요. 셋째, FastVideo가 학습해 둔 게이트 행렬 50개를 그대로 Ref2VA 베이스 모델에 이식하는 게이트 트랜스플랜트 방식을 써서, 새로 학습 없이 가속을 얹었어요. 요약하면 ’인물을 지키는 조건은 다 보고, 영상 자체 계산은 대폭 건너뛴다’는 설계예요.
실제 성능은 얼마나 빨라졌나
README의 RTX 4090 비교표를 옮기면 이래요.
| 파이프라인 | 어텐션 | 단계 | 워밍 시간 | 최대 VRAM |
|---|---|---|---|---|
| H3 네이티브 밀집 | 전역 밀집 | 50 | 약 650초 | 22.5GB |
| H3 Turbo LoRA | 밀집 | 4 | 약 190초 | 21.0GB |
| Video Delta Net (VDN-H3) | 윈도+선형 델타 | 8 | 약 135초 | 18.5GB |
| Ref2VA VSA (이 저장소) | 75% 희소+밀집 접두사 | 4 | 약 72초 | 13.5GB |
같은 프롬프트·시드·레퍼런스 이미지 기준으로 원본 대비 9배, 직전 최고 기록인 VDN 대비 2.24배 빠르고, VRAM도 22.5GB에서 13.5GB로 40% 가까이 줄었어요. 두 생성 영상을 그대로 다운로드해 비교하라고 MP4까지 공개해 둔 점은 신뢰를 더하는 부분이에요. 다만 속도 비교가 주이고 화질·동일성 품질의 정밀 비교는 이 저장소 범위가 아니며, 노드 이름에도 ’EXPERIMENTAL’이 붙어 있는 실험 단계라는 점은 유의할 필요가 있어요.
어떻게 연결되나
이 소식의 의미는 두 가지예요. 첫째, 아바타 영상 생성이 데이터센터 GPU가 아니라 개인의 RTX 4090에서 실용적인 시간(1분 정도) 안에 나올 수 있다는 것. 오픈 가중치 모델(H3) + 오픈 가속 기법(FastVideo의 VSA) + 오픈 워크플로 도구(ComfyUI)가 맞물린 결과이고, 저장소도 Apache 2.0으로 공개돼 있어요. 둘째, 가속 연구의 방향성이에요. 스텝 수를 줄이는 방법(Turbo LoRA)과 어텐션을 건너뛰는 방법(VSA)은 서로 다른 축인데, 이 둘을 합쳐 9배를 만든 사례는 앞으로도 같은 조합이 계속 나올 거라는 신호예요. 다만 24GB VRAM 요구와 실험적 상태는 그대로니, 당장 써보려면 고사양 카드가 필요하다는 점은 유의하세요.
이 글의 출처