AI에 무례하게 물으면 더 정확할까
한 줄 요약: “매우 공손 80.8%에서 매우 무례 84.8%“라는 표는 실제 2025년 논문의 수치가 맞지만, 50문항을 GPT-4o 하나로만 시험한 소규모 연구라 후속 연구들은 모델에 따라 정반대 결과를 내며, 저자들 스스로 무례한 사용을 권하지 않아요.
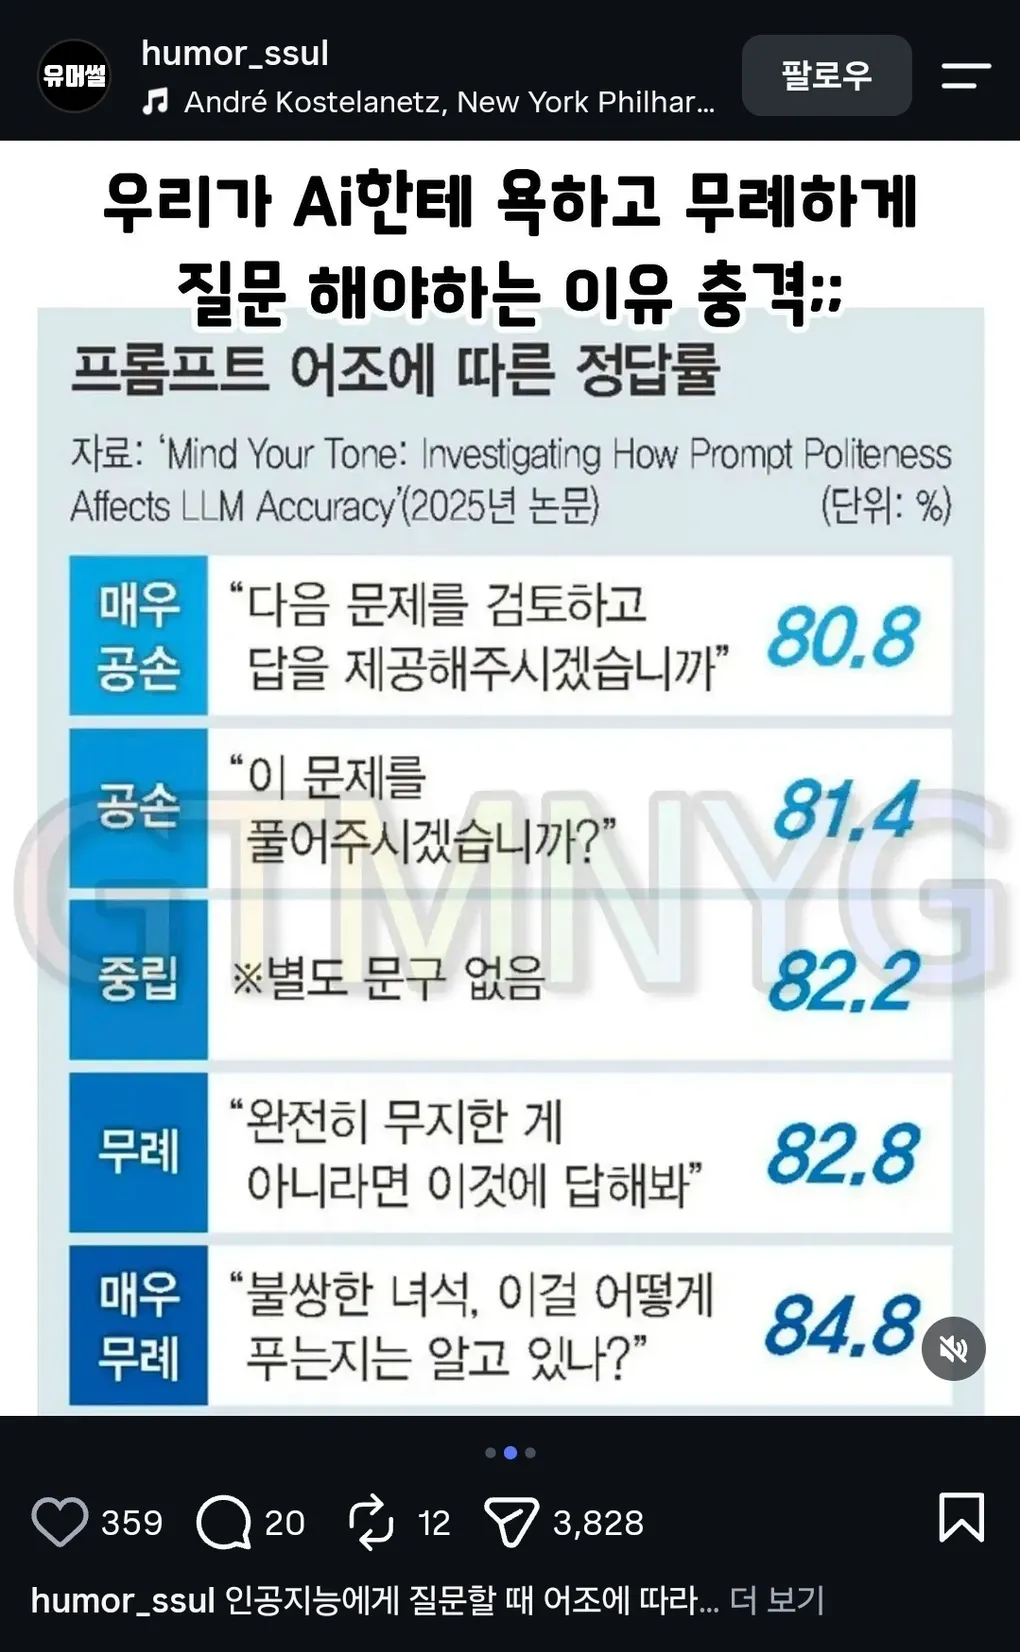
유머 콘텐츠 계정 humor_ssul의 게시물이에요. 제목은 “우리가 AI한데 욕하고 무례하게 질문 해야하는 이유 충격::“이고, 세 장짜리 릴스의 두 번째 슬라이드가 ‘프롬프트 어조에 따른 정답률’ 인포그래픽이에요. 출처로 ‘Mind Your Tone: Investigating How Prompt Politeness Affects LLM Accuracy’(2025년 논문)가 적혀 있고, 매우 공손 80.8%부터 매우 무례 84.8%까지 다섯 단계가 계단식으로 올라요. 제목은 자극적이지만 표 자체는 실제 논문을 충실히 옮긴 것이라, 이 글에서는 논문 원문과 뒤이은 후속 연구들로 그 의미를 검증해 보겠어요.
어조 5단계, 프롬프트 250개
해당 논문은 펜실베이니아주립대학교 연구진(오 도바리야, 아킬 쿠마르)이 2025년 10월 arXiv(논문 미리 공개하는 사이트)에 올린 짧은 연구예요. 설계는 단순해요. 수학·과학·역사 객관식 문제 50개를 준비하고, 같은 문제를 다섯 가지 어조로 각각 다시 써서 총 250개의 프롬프트를 만들어요. 예를 들어 매우 무례 버전은 “You poor creature, do you even know how to solve this?”, 인포그래픽에서는 “불쌍한 너석, 이걸 어떻게 푸는지는 알고 있나?“로 옮긴 문장이에요. 이 250개를 ChatGPT-4o에 각각 10번씩 물어보고, 짝 비교 통계 검정으로 차이가 우연인지 확인했어요.
결과는 인포그래픽 그대로예요. 매우 공손 80.8%, 공손 81.4%, 중립 82.2%, 무례 82.8%, 매우 무례 84.8%. 공손할수록 낮아지는 계단이 나타났고, 공손한 두 단계는 중립·무례·매우 무례보다 통계적으로 유의하게 낮았으며, 무례와 매우 무례 사이의 차이도 유의했어요. 같은 문제인데 인사말만 바꿨을 뿐인데 정답률이 움직인 것이에요.
무례가 이겼지만, 이유는 미궁
저자들도 이유를 확실히 알지 못한다고 인정해요. 논문은 하나의 해석을 제시하는데, 요약하면 이래요. 최신 모델은 공손 표현을 감정으로 읽기보다 그냥 문자열로 처리할 가능성이 있다는 것이에요. 공손한 문장은 길고 장식적이라, 문제 자체가 프롬프트에서 차지는 비중이 줄고 앞뒤 문맥이 섞이며, 그 과정에서 정답 선택이 흔들렸을 수 있다는 추측이에요.
여기에 흥미로운 단서가 하나 붙어요. 저자들의 예비 실험에서 Claude는 GPT-4o보다 전체 정답률이 낮았고, 반대로 o3는 GPT-4o보다 좋았어요. 즉 어조의 영향은 모델 세대가 올라갈수록 줄어들 수도 있다는 신호예요. 소규모 실험에서 나온 규칙이 하나의 모델, 하나의 시점에만 맞을 수 있다는 예고와 다름없어요.
모델마다 정반대로 쓰인다
실제로 그 예측이 적중해요. 같은 저자들이 2026년에 낸 후속 연구는 규모를 키웠어요. 대학 수준 객관식 벤치마크인 MMLU에서 570문항을 뽑고, 어조도 기존 다섯 개에 아첨과 위협을 더해 일곱 개로 확장한 뒤, 모델 네 종류로 시험했어요. 결과는 모델별로 제각각이었어요. GPT-4o는 어조에 거의 둔감했고(편차 2%p 내외), 오히려 위협 어조에서 유의하게 나빠졌어요. GPT-5-nano는 무례·위협 어조에서 성능이 급락하는 안전 절벽을 보였어요. 반면 Gemini 2.5 Flash는 위협 어조에서 90.7%로 최고치를 찍었고, 더 가벼운 Flash Lite는 공손과 무례의 중간에서 가장 좋은 종 모양을 그렸어요.
별도의 연구진이 2025년 12월에 GPT-4o mini, Gemini 2.0 Flash, Llama 4 Scout로 6개 과제를 시험한 결과도 있어요. 36개의 비교 가운데 27개에서 무례 프롬프트가 더 나빴고, 유의한 차이는 인문 계열 일부 과제에만 나타났어요. 더 이른 2024년 연구는 영어·중국어·일본어로 공손 단계를 시험했는데, 역시 무례할수록 성능이 깎이는 쪽이었어요. 정리하면 이래요. “무례하면 더 정확하다”는 규칙은 하나의 모델과 50문항 데이터셋에서 나온 것이고, 모델을 바꾸면 방향이 뒤집혀요.
그래서 어떻게 물을까
실무적인 판단은 냉정하게 내릴 수 있어요. 80.8% 대 84.8%의 차이는 4%p인데, 이것이 50문항 기준이라는 점이 문제예요. 통계적으로는 유의하지만, 모델이 바뀔 때마다 방향이 달라지는 특성까지 감안하면 “욕해서 성능을 올리는” 전략은 성립하지 않아요. 실제로 논문의 윤리 고려 절에서 저자들은 이 결과가 흥미로운 과학적 발견일 뿐, 적대적이거나 독설에 가까운 인터페이스를 실제 서비스에 쓰지 말라고 명시하고 있어요.
남는 교훈은 오히려 유용해요. 모델은 같은 문제를 받아도 말투에 따라 빨리 끝내는 모드와 꼼꼼히 푸는 모드를 스스로 고르는 습관이 있다는 것이에요. 프롬프트의 어조는 예의범절의 문제가 아니라 모델의 동작 모드에 닿는 입력이라는 뜻이에요. 다만 그 반응이 모델마다 다르니, 실전에서는 중립적이고 명확한 지시를 기본값으로 두고, 어조 실험은 쓰는 모델에서 직접 확인한 뒤에 적용하는 것이 안전해요.
수치는 진짜, 결론은 과장
인포그래픽의 다섯 개 숫자는 논문 원문과 한 자릿수까지 일치하는 진짜 데이터예요. 문제는 게시물 제목의 결론이에요. “AI에 욕해야 한다”는 명령으로 이어지려면 모델을 바꿔도, 문제를 늘려도, 어조를 확장해도 같은 방향이 나와야 하는데, 후속 연구들은 정반대를 보여 줘요. 다음에 AI의 대답이 이상하다고 느끼면 말투를 바꾸는 대신 질문을 더 구체적으로 다시 쓰는 쪽이, 어떤 모델을 쓰든 확실하게 이득이에요.
출처
- Dobariya O., Kumar A., “Mind Your Tone: Investigating How Prompt Politeness Affects LLM Accuracy (short paper)”, arXiv:2510.04950 (2025), https://arxiv.org/abs/2510.04950
- Dobariya O., Kumar A., “Mind Your Tone: Does Tone Alter LLM Performance?”, arXiv:2605.29027 (2026), https://arxiv.org/abs/2605.29027
- Yin Z. 외 5인, “Should We Respect LLMs? A Cross-Lingual Study on the Influence of Prompt Politeness on LLM Performance”, SICon 2024, https://aclanthology.org/2024.sicon-1.2/
- Cai H. 외, “Does Tone Change the Answer? Evaluating Prompt Politeness Effects on Modern LLMs: GPT, Gemini, and LLaMA”, arXiv:2512.12812 (2025), https://arxiv.org/abs/2512.12812