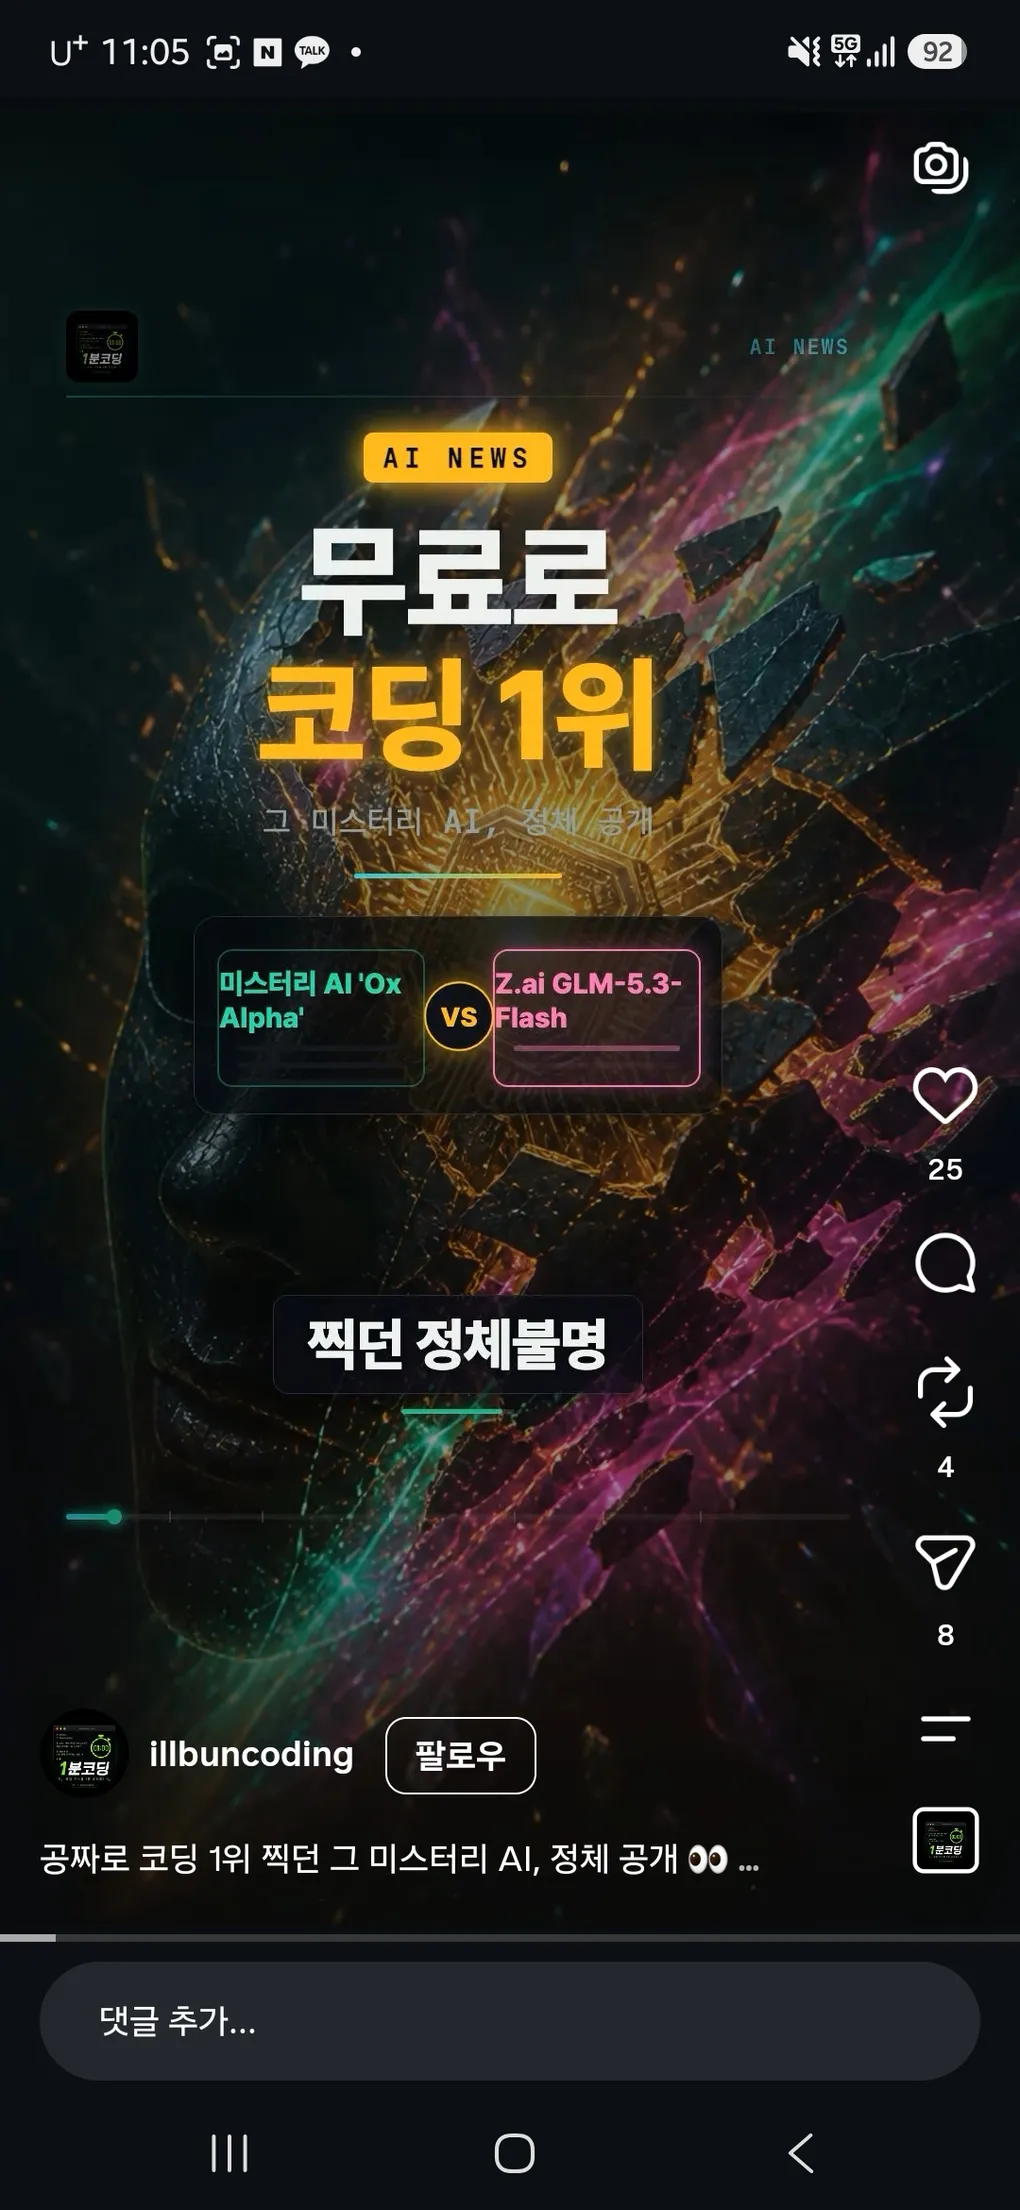
코딩 1위 익명 모델 'Ox Alpha'의 정체
한 줄 요약: 이름도 소속도 없는 익명 AI가 공짜 코딩 모델로 오픈라우터 인기 1위를 찍자 정체를 캐는 범인 찾기가 벌어졌고, 엿새 뒤 Z.ai가 “우리 GLM-5.3-Flash의 사전 테스트였다”며 오픈웨이트까지 공개한 사건이에요.
8월 20일, 오픈라우터(OpenRouter, 수백 개 AI 모델을 하나의 API로 호출할 수 있게 해 주는 모델 라우팅 플랫폼. 여러 회사 리모컨을 하나로 합친 셈이에요)의 모델 목록에 이상한 줄이 하나 생겼어요. 모델 이름은 Ox Alpha, 개발사 칸은 Stealth, 가격은 입력·출력 모두 0달러였어요. 스크린샷 속 세 개의 계정, AI 뉴스 채널 ai_freaks.kr과 ai.asap.kr, 1분코딩(illbuncoding)이 모두 같은 소식을 다뤘어요. “페이블도 이겼다는 정체불명 무료 모델?”, “1위 하던 익명 모델이 풀렸습니다”, “공짜로 코딩 1위 찍던 그 미스터리 AI, 정체 공개”. 이 글에서는 무슨 일이 있었는지, 정체가 어떻게 밝혀졌는지, 밝혀진 그 모델이 기술적으로 무엇인지 차례로 풀어 보겠어요.
미스터리 AI Ox Alpha란 무엇인가
스텔스 모델(stealth model, 개발사가 이름을 숨긴 채 선보이는 미리보기 모델)이 등장한 건 이번이 처음이 아니에요. 그러나 Ox Alpha는 규모가 달랐어요. 오픈라우터는 이 모델을 “코딩, 장기 에이전트 작업, 프로덕션 워크로드를 위한 추론 모델”이라고 소개했고, 스펙도 화려했어요. 104만 8,576토큰짜리 컨텍스트 윈도우(약 100만 토큰, 장편소설 두 권을 한꺼번에 올려 둘 수 있는 작업대), 131,072토큰 출력 한도, 텍스트·이미지·비디오를 입력으로 받고, 가격은 0달러였어요.
요금이 0달러인 데다 사용량 제한이 널널했기 때문에 실험이 폭주했어요. OpenCode(오픈소스 터미널 코딩 에이전트)는 “하루 100조 토큰 처리 가능”이라는 카피와 함께 자체 경로로 무료 배포를 시작했고, 오픈라우터 활동 통계 기준 일일 요청은 사흘 만에 2,700만 개에서 7,000만 개로 뛰었어요. 오픈라우터가 집계한 558개 모델 가운데 주간 인기 1위를 기록했어요. 흥미로운 건 트래픽의 주인공이에요. 상위 발신 앱을 보면 채팅창이 아니라 클로드 코드(Claude Code), 헤르메스 에이전트 같은 코딩 에이전트가 줄지어 있었어요. 개발자들이 실제 업무를 돌려 보기 시작한 거예요.
벤치마크 비교글도 터져 나왔어요. 개발자 벤 데이비스가 DeepSWE(실제 GitHub 이슈를 코딩 에이전트가 스스로 해결하는 비율을 재는 벤치마크)에서 10개 태스크만 돌렸는데 80%를 기록했어요. 같은 태스크에서 Claude Fable 5는 65%, GPT-5.6-sol은 52%였어요. “이게 뭐지?“라는 글이 하루 만에 회자됐어요. 다만 본인이 경고했던 대로였어요. 10개는 전체 113개 중 9% 미만이라 분산이 크고, 이후 전체 세트에 가까운 실행에서는 약 63%로 GPT-5.6-sol과 비슷한 수준으로 수렴했어요. 릴스의 “1위”도 결국 이 맥락에 놓고 읽어야 해요. 화제의 실체는 점수 자체보다, 에이전트들이 돈을 내지 않고도 최상위급 성능을 쓰고 있다는 사실이었어요.
여기에 스트라이프 CEO 패트릭 콜리슨이 “very impressive”라는 한 줄을 남겼고(스트라이프는 당시 70억 달러 이상으로 알려진 오픈라우터 인수를 진행 중이었어요), 미스터리는 마케팅이 되었어요. 회사에 물어도 답은 언제나 같았어요. 오픈라우터는 “우리는 개발자가 아니라 중계자”였고, 개발사는 말이 없었어요.
개발자들의 지문 감식 작전
그래서 커뮤니티가 범인 찾기를 시작했어요. 재미있는 건 방식이에요. 글자체, 실수 패턴 같은 헛다리가 아니라 API 응답 자체를 측정했어요.
핵심 도구는 오픈소스 크롤러 Crawl4AI의 개발자 unclecode가 만든 modelprint예요. 익명 API 엔드포인트에 인프라 프로브 아홉 개를 날려 응답을 알려진 모델들과 대조하는 지문 감식 도구예요. 8월 21일, 개발자 아나나이 아로라(Ananay Arora)는 토크나이저 검사에서 Ox Alpha가 GLM 계열과 1:1로 일치한다고 공유했어요. 토크나이저는 문장을 어떤 토큰 단위로 쪼개 읽는가를 정하는, 모델의 글 읽는 버릇이에요. 읽는 버릇은 쉽게 안 바뀌니 정체를 알아보는 지문으로 쓸 수 있어요. 30개 검사 그룹에서 전부 일치했어요. 다른 후보 토크나이저들은 11개 중 4개를 넘지 못했어요. modelprint의 9개 인프라 프로브 중 6개도 GLM-5.3과 일치했고, 에러 코드와 오디오 입력 거부 같은 행동 패턴까지 겹쳤어요. 심지어 실수로 새어 나온 서버 스택 트레이스의 클래스 이름이 청푸(Zhipu, Z.ai의 전신) 공개 문서의 엔드포인트 명명 규칙과 맞아떨어졌다는 보고도 있었어요.
다만 감식팀 스스로가 신중했어요. “지문 일치는 같은 인프라를 쓴다는 증거지, 정체의 증거가 아니다”라는 게 unclecode의 설명이었어요. 한 회사가 같은 스택에 두 모델을 얹을 수도 있으니까요. 그래서 감식에 나선 이들은 후보가 좁혀지는 와중에도 정답이 아닌 ’계열’이라고만 말했어요.
사실 선례가 있었기에 모두들 ’그 랩(lab)’을 의심했어요. 2월에 ’Pony Alpha’로 예고됐다가 5일 만에 GLM-5로 밝혀진 것도 Z.ai였고, ’Hunter Alpha’는 샤오미 MiMo-V2-Pro, ’올빼미(Owl Alpha)’는 메이투안의 LongCat-2.0이었어요. 중국 랩들이 스텔스 미리보기를 출시 전략처럼 쓰고 있었던 거예요.
가설을 뒷받침한 스펙 차이
가설이 확신으로 넘어가는 데는 디테일이 한 개 있었어요. GLM-5.3은 8월 14일에 나왔는데 텍스트 전용 모델이었어요. Ox Alpha는 엿새 뒤에 나타나 이미지와 비디오까지 받았어요. 그러니 정체는 그대로 복사한 게 아니라, GLM-5.3 계열에서 멀티모달로 확장 중인 미공개 업그레이드 모델이어야 해요. 감식이 정확했다면 그 이름은 GLM-5.3-Flash일 것이고, 실제로 그랬어요.
8월 26일, Z.ai가 공식 발표를 냈어요. Ox Alpha는 GLM-5.3-Flash의 익명 사전 테스트였어요. OpenCode와 오픈라우터에 올려 실사용 피드백을 모았더니 그 주 가장 인기 있는 모델이 됐다는 것, 그리고 그 트래픽 전부를 중국산 AI 칩으로 서빙했다는 것까지 직접 확인했어요.
이름 밝힌 뒤 드러난 스펙
이름이 밝혀진 모델이 어떻게 저 가격을 만들어냈는지가 기술적으로 가장 읽을 거리예요. 발표 기준으로 정리하면 이래요.
MoE 구조, 320B 중 18B만 활성. GLM-5.3-Flash는 MoE(Mixture of Experts, 전문가 혼합) 모델이에요. 두뇌를 100% 동시에 쓰는 사람은 없죠. MoE는 이것을 구조로 만든 모델이에요. 전체 매개변수는 3,200억 개지만 토큰 하나를 처리할 때 깨어 쓰는 전문가 네트워크는 180억 개뿐이에요. 나머지는 쉬고 있다가 토큰이 바뀌면 다른 전문가가 깨어나요. 전체 두뇌는 크되 한 번에 쓰는 부분만 작으니, 계산량도 작은 모델 수준을 유지해요. 릴스의 ai.asap.kr 그래프가 짚은 “320B 중 18B만 쓰는 멀티모달 오픈웨이트”가 이 말이고, GLM-5.2 대비 벤치마크 점수는 올리면서 가격은 대략 10분의 1로 내린 근거도 여기에 있어요.
하이브리드 어텐션 + IndexPool. GLM 시리즈 처음으로 선형 어텐션(linear attention)과 희소 어텐션(sparse attention)을 섞었어요. 두꺼운 책을 통째로 암기하는 대신, 최근에 읽은 부분은 노트에 적어 두고(선형 어텐션) 필요한 장면만 목차로 찾아 펴 보는(희소 어텐션) 방식이에요. 100만 토큰 컨텍스트를 지탱하는 핵심이 이 설계예요. 인덱서의 키 벡터 네 개를 가중 풀링으로 한 장의 목차 카드로 접어 압축하는 IndexPool까지 더하면, GLM-5.3 대비 어텐션 계산량은 3.0배, KV 캐시는 4.4배 줄어들어요. KV 캐시는 모델의 자주 쓰는 단어집이라고 하면 이해가 빨라요. 지금까지 읽은 문맥을 다시 계산하지 않고 바로 꺼내 쓰게 해 주는 셈인데, 그 단어집 두께가 4분의 1 수준이 된다는 뜻이에요. 긴 문맥 서빙 비용이 폭증하는 지점을 정면으로 줄인 거예요.
네이티브 멀티모달 + 오픈웨이트. GLM-5 시리즈에서 처음으로 이미지와 비디오를 처음부터 함께 학습한(30조 토큰 멀티모달 코퍼스) 모델이고, 이게 릴스에서 본 미스터리 모델의 스펙과 딱 맞아떨어지는 부분이에요. 가중치는 MIT 라이선스로 허깅페이스에 공개됐어요(기본 FP8 체크포인트 기준 약 306GiB라 셀프 호스팅은 어느 정도 규모가 필요해요). Z.ai 발표 기준으로 DeepSWE v1.1 63.4(GLM-5.2는 46.2), 터미널 벤치 2.1 84.3이고, 자사 코딩 벤치마크 최대 난이도에서 Claude Opus 4.8(29.5)에 근접(29.0)해요. 인공지능 분석 사이트 Artificial Analysis의 인텔리전스 지수에서 기록한 57점을 태스크당 0.045달러(할인가)에 낸다는 게 이 그래프의 요점이에요. ai.asap.kr 스크린샷의 “GLM-5.3-Flash (discounted) $0.045 · 57 pts”가 바로 그 파레토 경계, “이 가격에 이만큼 똑똑한 모델은 없다”는 기준선이 이동했다는 표시예요. 같은 지능을 쓰려면 그동안 대략 10배 가격이 필요했다는 계산이에요.
정리하면 Ox Alpha의 공짜 1위 신화는 세 층이 겹친 결과예요. MoE로 활성 매개변수를 줄이고, 하이브리드 어텐션으로 긴 문맥의 서빙 비용을 낮추고, 그 결과를 익명 프리뷰로 검증한 것이에요.
공짜의 가격, 데이터 약관
정체 공개 소식에 기뻐하기 쉽지만, 실사용자들이 제일 예민했던 지점은 프라이버시였어요. 오픈라우터의 Ox Alpha 페이지는 “프롬프트와 응답은 제공자가 보존하되 학습에는 쓰지 않는다”고 적었어요. 반면 OpenCode 경로는 “영(0) 데이터 보존(Zero Data Retention)“을 내세웠어요. 같은 모델이라도 어느 통로로 부르느냐에 따라 보존 정책이 달라진다는 뜻이고, 두 조항이 같은 요청 경로 위에서 서로 다른 회사를 말하므로 혼동하면 안 된다는 지적도 나왔어요.
보이지 않는 상대에게 사내 코드를 흘려 보내는 일은 이름이 밝혀져도 그대로 남는 문제예요. Ox Alpha가 Z.ai의 GLM 계열이라는 게 확인된 지금은 적어도 ’누가 받는지’는 알 수 있게 됐지만, 다음 스텔스 모델에서는 같은 약관 문제가 다시 반복될 가능성이 높아요. 스텔스 미리보기를 쓸 때는 프라이빗 리포 대신 공개·합성 데이터부터 돌려 보는 게 정석이에요.
어떻게 연결되는가
한 줄로 요약하면: 익명 무료 코딩 모델의 정체 공개 사건은 곧 ’성능은 먼저 증명하고 이름은 나중에 붙인다’는 새로운 모델 출시 전략의 데모였다는 이야기예요. Z.ai 입장에서는 실사용 데이터와 평판을 먼저 받고, 개발자 입장에서는 브랜드 프리미엄 없이 실력만 보고 고를 기회를 얻은 셈이에요. 승자는 결국 오픈웨이트로 돌아온 Z.ai였고, 그 순간 Ox Alpha는 “수수께끼”에서 “MIT 라이선스 모델”로 바뀌었어요.
이 블로그와 이어지는 지점도 뚜렷해요. MoE라는 구조 자체는 이전 글에서 다룬 로컬 모델 이야기와 같은 축이고, “활성 매개변수를 줄여 비용을 낮춘다”는 발상은 GGUF 양자화나 VRAM 예산 계산과 정확히 같은 문제의 다른 층이에요. 다음에 익명 모델이 또 나타나면, 이제는 여러분도 토크나이저 검사 한 번 돌려 볼 차례예요.
출처:
- 원본 릴스 — 무료로 코딩 1위 찍던 그 미스터리 AI, 정체 공개 (Instagram)
- Ox Alpha — OpenRouter
- GLM-5.3-Flash: Frontier Intelligence, Flash Cost — Z.ai 공식 블로그 (2026-08-26)
- Nobody knows who built AI coding model Ox Alpha — SiliconANGLE (2026-08-23)
- Z.ai open-sources ‘Ox Alpha’ model as GLM-5.3-Flash — SiliconANGLE (2026-08-26)
- AI Model Ox Alpha Is Free, Beats Claude Fable, and Nobody Knows Who Built It — Decrypt
- zai-org/GLM-5.3-Flash — Hugging Face