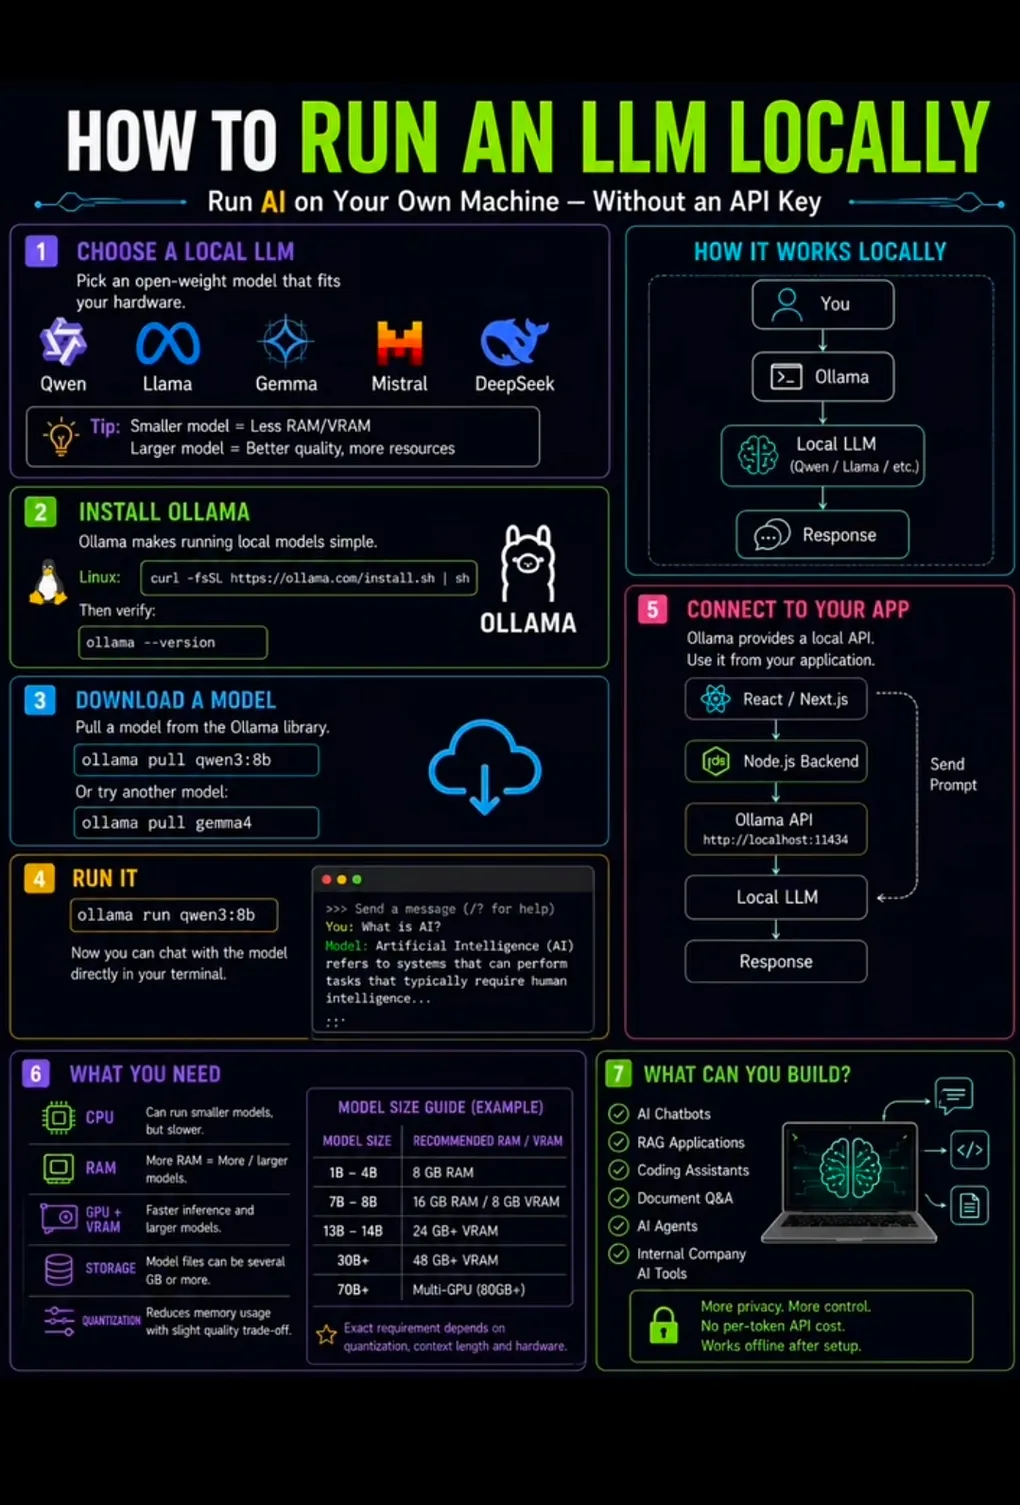
[릴스 해설] Ollama로 로컬 LLM 돌리는 5단계
한 줄 요약: 이 인포그래픽은 API 키 없이 로컬에서 AI 모델을 돌리는 절차를 5단계로 정리해요 — 모델 고르기, Ollama 설치, 모델 내려받기, 터미널 실행, 내 앱 연결 — 그리고 각 단계에 하드웨어 기준표를 붙이에요. 절차대로만 하면 10분 안에 로컬 AI가 켜져요.
이번 인포그래픽은 “HOW TO RUN AN LLM LOCALLY — Run AI on Your Own Machine, Without an API Key”라는 제목의 초보자용 설치 가이드예요. 7개 섹션으로 구성돼 있어요. 로컬 LLM 고르기(큐원·라마·제마·미스트랄·딥시크), Ollama 설치, 모델 내려받기, 터미널 실행, 앱 연결, 하드웨어 요구 사항, 만들 수 있는 것. 절차 자체는 정확하고, 수치 가이드 표도 크게 틀리지 않아요. 각 단계를 검증하면서 풀어 보겠어요.
5단계 절차 훑어보기
다이어그램의 흐름은 이래요. ① 모델 선택 — 오픈 가중치 모델(Qwen·Llama·Gemma·Mistral·DeepSeek) 중 하드웨어에 맞는 것을 골라요. 팁으로 작은 모델은 적은 RAM/VRAM을, 큰 모델은 더 나은 품질과 더 많은 자원을 요구한다고 적혀 있어요. ② Ollama 설치 — 리눅스에서는 curl -fsSL https://ollama.com/install.sh | sh 한 줄이고, ollama --version으로 확인해요. ③ 모델 다운로드 — ollama pull qwen3:8b, ollama pull gemma4처럼 라이브러리에서 당겨 와요. ④ 실행 — ollama run qwen3:8b로 터미널에서 바로 대화해요. ⑤ 앱 연결 — Ollama가 제공하는 로컬 API(localhost:11434)를 React/Next.js 프론트와 Node.js 백엔드 같은 자기 앱에서 호출해요.
이 가운데 ②~④는 이전에 비교한 Ollama의 강점 그대로예요. 항상 떠 있는 백그라운드 서버와 짧은 명령 두 개면 로컬 AI가 돌아가는 구조로, 터미널이 있는 사람에게는 가장 빠른 시작점이에요.
모델 크기 가이드, 규칙으로 검증해 보기
인포그래픽의 모델 크기 가이드표는 이래요. 1B–4B 모델은 8GB RAM, 7B–8B는 16GB RAM 또는 8GB VRAM, 13B–14B는 24GB 이상, 30B 이상은 48GB 이상, 70B 이상은 멀티 GPU(80GB 이상). 그 아래 작은 글씨로 “정확한 요구량은 양자화·컨텍스트 길이·하드웨어에 따라 다르다”고 단서를 달았어요.
이 표를 이 블로그의 4-bit VRAM 예산 규칙, 즉 가중치 메모리 ≈ 매개변수 수 × 0.5GB로 검증해 보면 표가 얼추 맞아요. 8B 모델의 4-bit 가중치는 4GB이므로 8GB VRAM이면 가중치와 여유분이 들어가요. 70B는 가중치만 35GB라 멀티 GPU가 필요하다는 것도 맞아요. 다만 가이드가 ’VRAM’과 ’RAM’을 같은 칸에서 구분하고 있고, 실제로는 KV 캐시(문맥 길이에 비례)와 런타임 오버헤드가 0.5GB 규칙 결과에 더해진다는 점을 이전 글에서 다뤘어요. 즉 표는 출발점이고, 문맥이 길어질수록 여유분은 늘어나요. 양자화 항목도 메모리 절감 대품 품질 절충이라고 정확히 짚고 있어요.
localhost:11434 — 앱이 붙는 방식
다섯 번째 단계가 사실 이 인포그래픽의 백미예요. Ollama는 집 안에 항상 열어 둔 창구와 같아요. localhost:11434에서 API를 제공하므로 내 앱들이 그 창구로 가면 모델이 자리에서 답을 내놔요. React·Next.js 프론트에서 Node.js 백엔드로, 백엔드에서 Ollama API로 이어지는 구성을 그림으로 보여줘요. 이전 Ollama vs LM Studio 글에서 다룬 것과 같은 방식으로, OpenAI 호환 레이어에 base URL만 교체하면 기존 OpenAI SDK 코드를 그대로 재활용할 수 있어요. “API 키 없이”라는 부제의 실체는 이것이에요. 호출 단가가 없는 대신, 내 컴퓨터의 RAM·VRAM이 호출 대가예요.
이 다이어그램이 안 말하는 것
초보자 가이드답게 빠뜨린 것도 있어요. 첫째, 별도 언급 없는 GUI 대안이에요. LM Studio 같은 데스크톱 앱으로 모델을 눈으로 탐색하는 경로가 있고, 최근에는 헤드리스 모드까지 지원해요. 둘째, 보안이에요. Ollama의 API를 컴퓨터 밖으로 노출하면(0.0.0.0 바인딩 같은 설정) 아무나 모델을 호출할 수 있으니, 기본값인 localhost 바인딩을 유지하는 것이 안전해요. 셋째, 벤치마크예요. 성능은 도구가 아니라 하드웨어와 모델이 결정한다는 점은 이 시리즈에서 계속 강조해 온 부분이에요.
어떻게 연결되는가
한 줄로 요약하면: 모델 고르기 → 설치 → 내려받기 → 실행 → 연결의 5단계로, API 키 없는 로컬 AI의 전체 입문 지도가 인포그래픽 한 장에 담겨 있다는 이야기예요.
이 블로그의 로컬 LLM 시리즈와 합치면 입문 지도가 완성돼요. GGUF 양자화 글(포맷), 4-bit VRAM 예산 글(용량 계산), 128GB 미니 PC 글(하드웨어), Ollama vs LM Studio 글(도구 선택), 그리고 이 글(설치 절차)까지. 처음부터 끝까지 이 다섯 편이면 로컬 LLM을 실제로 돌리는 데 필요한 결정이 전부 커버돼요.
출처: