0.6B 음성인식 모델, CPU에서 돈다?!
한 줄 요약: NVIDIA가 공개한 6억(0.6B) 파라미터 음성인식 모델 Nemotron 3.5 ASR은 앞 상태를 캐시로 재사용하는 스트리밍 구조 덕분에 GPU 없이 CPU에서도 40개 언어 실시간 전사가 가능해요.
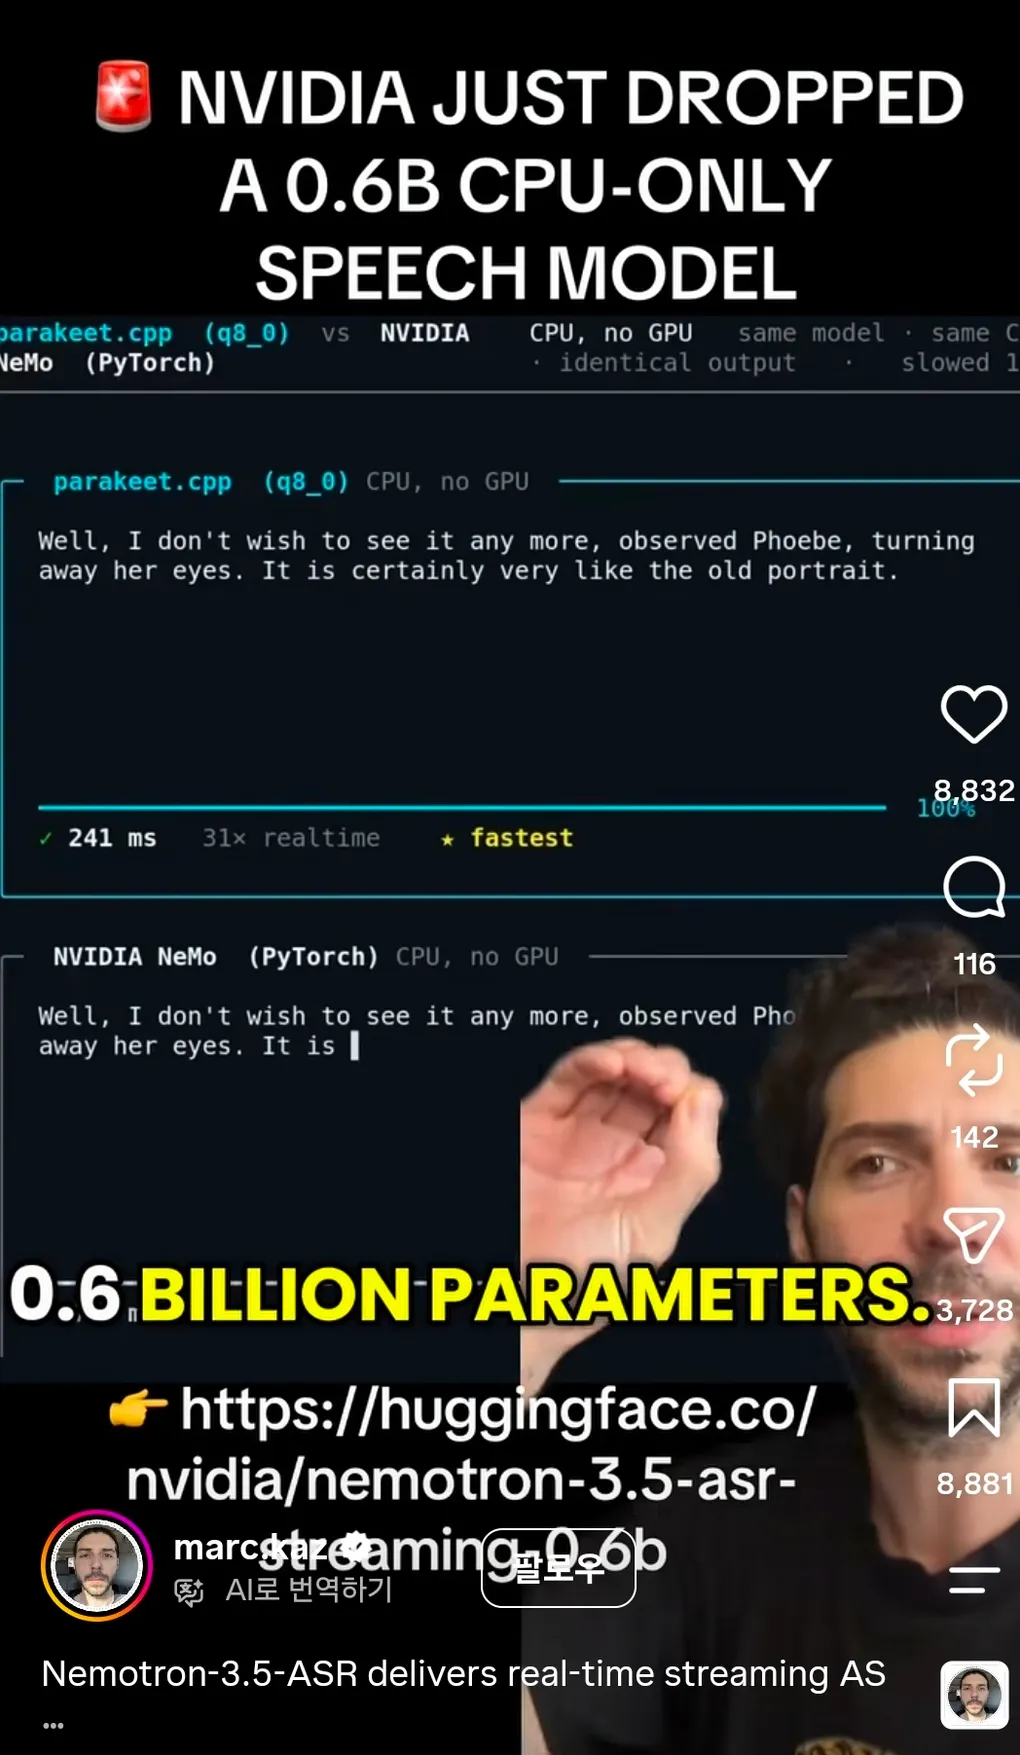
marc.kaz 님 릴스에 “NVIDIA JUST DROPPED A 0.6B CPU-ONLY SPEECH MODEL”이라는 헤드라인이 나왔어요. 릴스 화면에는 같은 모델을 공식 NeMo(PyTorch) 런타임과 parakeet.cpp(q8_0)로 CPU에서 각각 돌려 비교하는 장면이 있고, parakeet.cpp는 241ms 만에 받아적기를 끝내 31배 실시간 속도, 가장 빠르다는 표시가 어요. 이 정보는 팩트체크가 가능해요. 모델은 2026년 6월 4일 Hugging Face에 공개된 nvidia/nemotron-3.5-asr-streaming-0.6b 모델 카드 그대로고, C++ 포트인 parakeet.cpp에도 이 모델 지원이 6월 6일 병합됐어요.
릴스 정보 팩트 체크
릴스 캡션의 주장을 모델 카드와 대조하면 이래요. 0.6B 파라미터는 모델 카드의 600M과 일치해요. “40개 이상 언어”도 사실이지만 정확히는 40개 언어-로케일이고, 이 중 즉시 사용 가능한 건 최상위 티어 19개와 광역 티어 13개를 합친 32개예요. 나머지 8개는 파인튜닝을 해야 완전한 전사가 돼요. 실시간 스트리밍 출력, 완전 오프라인 동작, 상용 사용 허가도 모두 모델 카드에 명시돼 있어요. 공식 NeMo보다 2.5배 빠르다는 수치는 릴스의 벤치마크 기준이고, 아래에서 따로 다룰게요.
ASR이란 무엇인가
ASR(Automatic Speech Recognition, 자동 음성 인식)은 음성 오디오를 텍스트로 바꾸는 기술이에요. 휴대폰 음성 입력, 회의록 자동 전사, 영상 자막이 모두 이 카테고리예요. OpenAI의 Whisper가 가장 널리 쓰인 모델이고, NVIDIA는 Parakeet이라는 음성인식 모델 계열을 만들어 왔어요. Nemotron 3.5 ASR은 그 계열의 최신 다국어 버전이에요.
스트리밍이 왜 어려운가
말하는 동안 텍스트가 실시간으로 나오려면 오디오를 조각내서 처리해야 해요. 전통적인 버퍼 방식은 문맥을 이어가려고 겹치는 구간을 반복해서 계산하느라 낭비가 커요. Nemotron 3.5의 답은 캐시 인식(Cache-Aware) FastConformer-RNNT 구조예요. RNNT(Recurrent Neural Network Transducer)는 오디오 프레임을 순서대로 처리하며 바로바로 토큰을 내보내는, 스트리밍에 맞춘 디코더 방식이에요. 인코더의 셀프어텐션과 합성곱 층 상태를 캐시에 보관해 두고, 새로 들어온 오디오 조각만 계산해요. 겹치는 계산이 아예 없어지고, 청크 크기를 80ms부터 1120ms까지 선택해 재학습 없이 지연과 정확도의 균형을 조정할 수 있어요.
모델을 한 명의 속기사로 그려보면 차이가 보여요. 버퍼 방식 속기사는 문맥을 잊지 않으려고 방금 받아쓴 부분을 몇 번이고 다시 읽는 사람이에요. 캐시 인식 속기사는 노트에 앞 내용을 남겨두고 새로 들려오는 말만 받아적죠. LLM에서 KV 캐시를 ’자주 쓰는 단어집’이라고 했다면, 이건 그 원리의 음성 버전이에요.
0.6B를 CPU에서 돌리는 의미
0.6B는 6억 개 파라미터예요. 요즘 언어 모델 기준으로는 아주 작은 크기예요. 작다는 건 곧 GPU 없이 사무실 PC나 미니PC의 CPU만으로도 돌아간다는 뜻이에요. 이게 실무에서 중요한 이유는 세 가지예요. 네트워크와 클라우드 없이 오프라인으로 동작하고, 음성 데이터가 외부로 나가지 않으며, 릴스 캡션처럼 로컬 에이전트 파이프라인에 붙이기 쉬워요. 음성으로 명령하면 에이전트가 일하는 구조에서 첫 관문이 음성인식인데, 그 관문의 비용이 크게 내려간 셈이에요.
parakeet.cpp는 무엇인가
NVIDIA 공식 스택은 NeMo와 PyTorch라는 무거운 파이썬 환경을 요구해요. LocalAI 팀이 만든 parakeet.cpp는 NVIDIA Parakeet 계열 음성인식 모델을 C++(ggml)로 옮긴 포트예요. 실행 파일 하나에 GGUF 파일 하나만 있으면 파이썬 없이 추론돼요. GGUF는 llama.cpp 생태계에서 쓰는 모델 파일 포맷이고, 릴스에 나온 q8_0은 8비트 양자화 버전이에요. 프로젝트 블로그는 NeMo와 글자 단위로 동일한 전사 결과를 내며 CPU 기준 중앙값 1.40배 속도, whisper.cpp 대비 약 27배를 보고했어요. 릴스가 말한 2.5배는 같은 모델·같은 CPU 조건에서 공식 NeMo 런타임을 이긴 벤치마크 화면 기준이고요. 속도 향상 폭은 오디오 길이와 설정마다 달라지지만, ’같은 결과물을 훨씬 가벼운 실행 환경으로’라는 점은 두 출처가 일치해요.
한국어는 지원되나
지원돼요. 한국어(ko-KR)는 19개 최상위 티어(transcription-ready)에 포함돼 있고, 일본어(ja-JP)도 같은 티어예요. 언어를 지정하지 않고 auto로 두면 모델이 말하는 언어를 감지해 출력 끝에 언어 태그를 붙이에요. 문장부호와 대소문자도 별도 후처리 없이 같이 나와요. 다만 영어만 쓰는 환경에서는 정확도가 더 높은 영어 전용 스트리밍 모델을 쓰라고 모델 카드가 권하고 있어요.
어떻게 연결되나
이 릴스의 포인트를 정리하면 ’GPU 없이, 오프라인으로, 실시간’이에요. 이 블로그에서 다뤄온 로컬 LLM 스택에 음성 입력 조각이 붙은 셈이에요. 음성을 받아 적는 ASR, 생각하는 LLM, 말하는 음성 합성으로 이어지는 로컬 음성 에이전트 파이프라인에서 이제 첫 단계가 CPU 자원만으로 해결돼요. 0.6B짜리 속기사가 노트 하나로 실시간 받아적는 시대가 된 이유가 정확히 이 구조예요.
이 글의 출처
- NVIDIA, “nvidia/nemotron-3.5-asr-streaming-0.6b” 모델 카드, Hugging Face (2026.06.04), https://huggingface.co/nvidia/nemotron-3.5-asr-streaming-0.6b
- mudler(LOCALAI), “parakeet.cpp” 저장소 (MIT 라이선스), https://github.com/mudler/parakeet.cpp
- Ettore Di Giacinto, “parakeet.cpp: NeMo transcripts, byte for byte, without the Python”, LocalAI 블로그 (2026.06.05), https://localai.io/blog/parakeet-cpp-asr-on-cpu/
- parakeet.cpp PR #10, “Add nemotron-3.5-asr-streaming-0.6b” (2026.06.06), https://github.com/mudler/parakeet.cpp/pull/10
- marc.kaz, “NVIDIA JUST DROPPED A 0.6B CPU-ONLY SPEECH MODEL”, Instagram 릴스, https://www.instagram.com/reel/DZvHgEcOLfB/