7GB 램에 20B 모델: Maple-Preview
한 줄 요약: 처음부터 값이 세 개뿐인 숫자로 학습한 20B MoE 모델 Maple-Preview는 5.31GB 체크포인트와 M4 맥 미니에서 초당 218토큰이라는 결과로, 20B급 추론 모델을 노트북과 스마트폰 안에 넣을 수 있다는 가능성을 보여줘요.
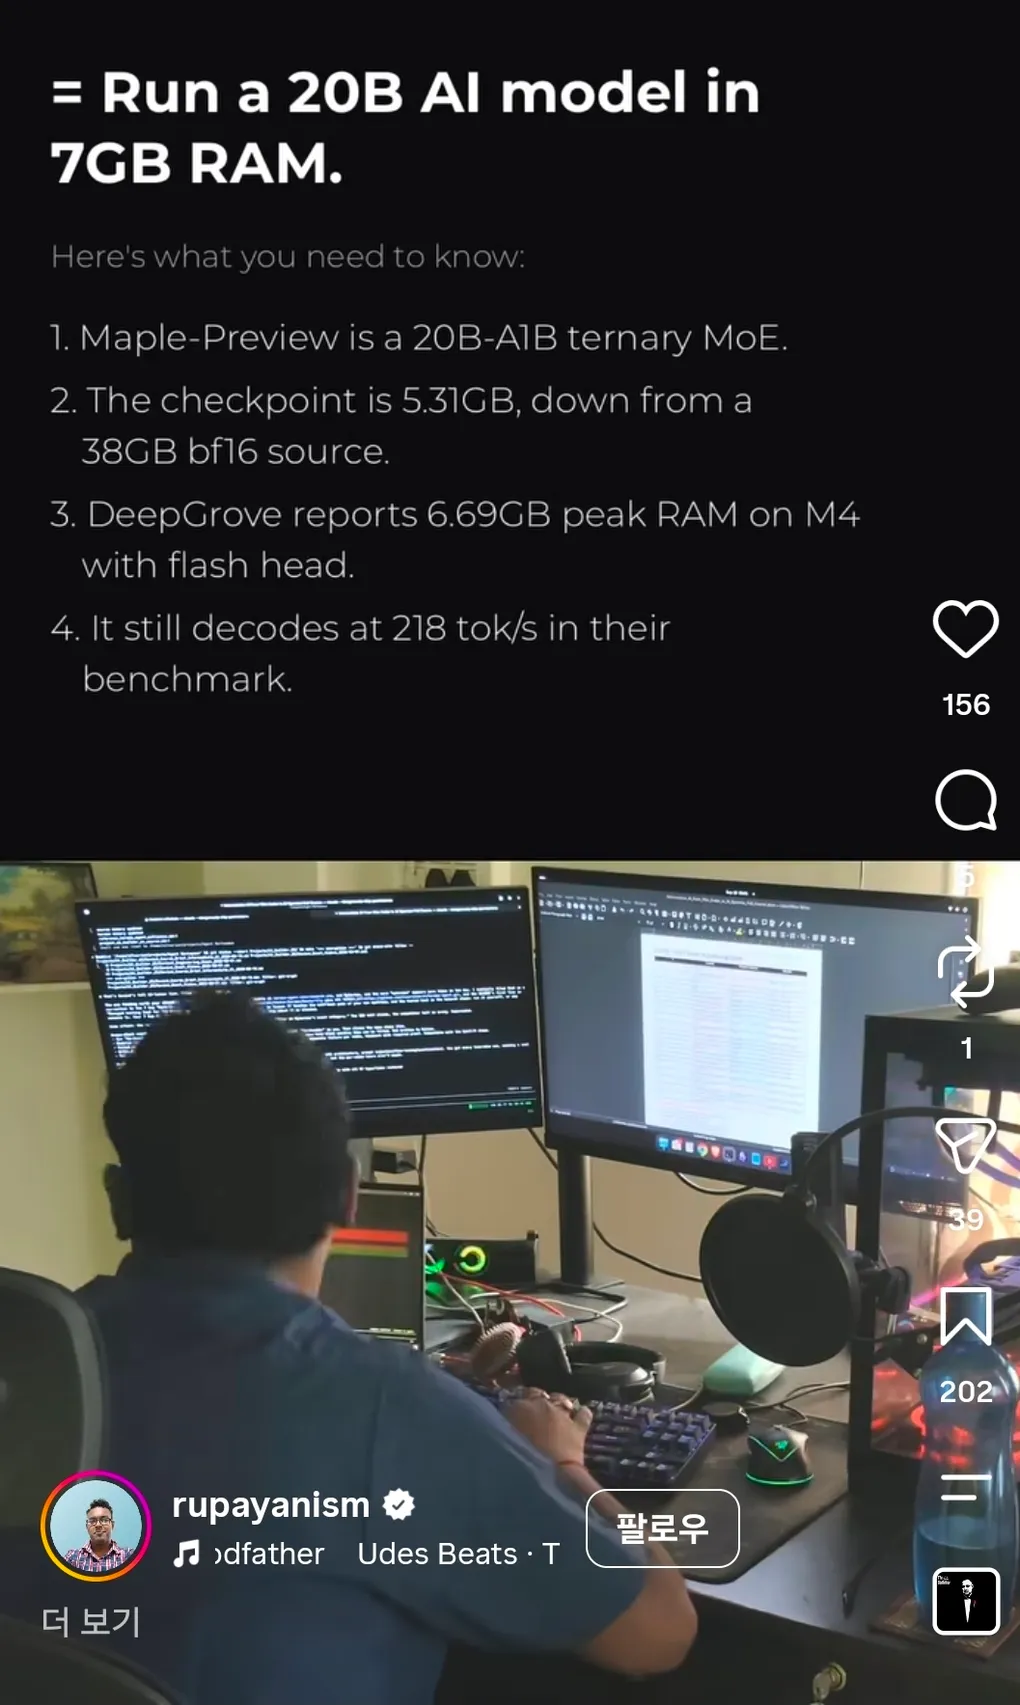
rupayanism님이 올린 릴스예요. “Run a 20B AI model in 7GB RAM”이라는 문구로, DeepGrove가 2026년 8월 5일에 공개한 오픈소스 모델 Maple-Preview를 네 항목으로 소개해요. ① 20B-A1B 삼진(ternary) MoE라는 것, ② 체크포인트가 38GB짜리 bf16 원본에서 5.31GB로 줄었다는 것, ③ DeepGrove 발표 기준으로 M4 칩에서 플래시 헤드(Flash-head)를 썼을 때 최대 램 사용량이 6.69GB라는 것, ④ 벤치마크에서도 여전히 초당 218토큰으로 디코드(토큰 단위 답 생성)한다는 것까지예요. 네 항목을 DeepGrove의 Hugging Face 모델 카드, 공식 MLX 런타임 문서, AI/TLDR·AI Beat의 정리 글과 대조해 봤는데 수치는 모두 공식 발표와 일치했어요. 다만 6.69GB라는 최대 램 사용량 수치만은 제가 확인한 공개 자료에 직접 실려 있지 않아 릴스의 인용 그대로 가져왔어요.
Maple-Preview가 뭔가요
Maple-Preview는 미국의 독립 AI 연구소 DeepGrove가 공개한 추론(reasoning) 모델이에요. 200억 개의 파라미터를 갖췄으면서도 체크포인트(학습 결과물 파일)는 5.31GB에 불과하고, 131,072 토큰 컨텍스트를 지원하며, MIT 라이선스로 공개돼 누구나 내려받아 쓸 수 있어요. DeepGrove는 IMO(국제수학올림피아드) 수준의 문제를 풀고, 같은 무게급 효율 모델인 Gemma 4·Qwen3.5·gpt-oss보다 5~16배 빠르다고 주장해요. 이름 뒤에 붙은 ’프리뷰’는 아직 완성이 아니라는 뜻인데, 이 부분은 뒤에서 다뤄요.
20B-A1B, 깨어 있는 두뇌만 쓰기
모델 이름에 붙은 20B-A1B를 읽는 법부터 짚을게요. 앞의 20B는 두뇌 전체에 들어 있는 파라미터 수, 뒤의 A1B는 토큰 하나를 처리할 때 실제로 깨어 쓰는 파라미터 수예요. 이 모델은 MoE(Mixture of Experts, 전문가 혼합) 구조로, 24개의 층마다 256명의 전문가(expert)가 대기하고 라우터라는 안내 담당이 토큰마다 그중 8명만 호출해요. 256명 중 8명이면 전체의 3퍼센트예요. 그래서 두뇌 전체는 20B인데 실제 계산은 1B짜리 두뇌만 깨어 있는 셈이죠. 이 덕분에 지식 저장 용량은 20B급으로 넓으면서, 토큰 하나를 처리하는 비용과 속도는 1B급에 가깝게 유지돼요.
값이 세 개뿐인 삼진 무게
이번 공개의 핵심은 삼진(ternary) 무게예요. 모델 안에는 지식이 숫자 형태로 저장되는데, 보통 모델은 이 숫자 하나를 소수점 아래까지 정밀하게 기록해요. Maple-Preview는 처음부터 각 숫자를 −α, 0, +α 세 값 중 하나로만 적어요. 밝기를 미세하게 조는 다이얼 대신 끔·중간·켬 세 단계 스위치만 쓰는 셈이에요. 세 값이면 파라미터 하나가 담는 정보량이 약 1.58비트밖에 안 되고, 실제 파일에는 2비트 단위로 포장돼요.
중요한 건 이게 사후 양자화(quantization)가 아니라는 점이에요. 흔한 방식은 높은 정밀도로 학습을 끝낸 뒤 비트를 깎아 눌러 담는 것인데, 이러면 모델이 원래 쓰던 정밀한 값을 억지로 근사하게 돼요. Maple-Preview는 학습하는 순간부터 최적화기(optimizer)에게 삼진 값만 줬기 때문에, 처음부터 삼진으로 자연스럽게 표현되는 해를 찾아요. 포장이 압축이 아니라 원본인 이유죠.
38GB에서 5.31GB까지
숫자로 확인해 볼게요. 200억 개 파라미터에 파라미터당 2비트면 20B × 2비트 ÷ 8 = 5GB예요. 여기에 각 행마다 하나씩 들어가는 스케일 값(α) 같은 부수 정보가 더해져 실제 체크포인트는 5.31GB가 돼요. 참고로 Hugging Face에 올라온 기본 저장소는 bf16(모델 무게를 담는 16비트 소수점 형식) 원본 38GB이고, 5.31GB는 공식 MLX 런타임용으로 2비트 포장한 실행 버전(maple-preview-2bit-mlx)예요.
여기에 어텐션 설계도 한몫해요. 층 4개를 한 조로 묶으면 3개는 최근 512칸만 보는 슬라이딩 윈도 어텐션(SWA-512), 1개는 전체 문맥을 훑는 전역 어텐션으로 배치했어요. 대화 맥락을 싸게 유지하는 KV 캐시(자주 쓰는 단어집)가 불어나는 걸 이 배치가 막아 주기 때문에, 131K 토큰이라는 긴 컨텍스트를 유지하면서도 램 부담을 낮춰요.
실제 속도와 램 사용량
DeepGrove 보고 기준으로 M4 맥 미니에서는 초당 218토큰이 나오고, 더 최신인 M5 Pro에서 플래시 헤드(Flash-head) 최적화를 켜면 초당 395토큰까지 올라가요. 아이폰에서도 초당 120토큰이에요. tok/s(초당 생성 토큰 수)는 모델이 1초에 단어 조각을 몇 개 뱉는지 재는 속도 단위예요. 같은 무게급 효율 모델들보다 5~16배 빠르다는 게 DeepGrove의 비교 주장이고요.
릴스의 세 번째 항목인 최대 램 사용량 6.69GB도 이 맥락에서 읽으면 돼요. 램은 컴퓨터의 작업대예요. 체크포인트 5.31GB를 작업대에 올려놓고, 거기에 KV 캐시와 실행 오버헤드를 더하면 6.69GB 정도가 된다는 계산이에요. 통합 메모리 8GB짜리 맥 미니나 최신 스마트폰급 작업대에서도 20B 모델이 돌아가는 이유죠.
아직 프리뷰인 이유
성능 지표도 짧게 보고 넘어갈게요. DeepGrove는 AIME 2026·HMMT 2026(고난도 수학 경시), GPQA-D(대학원 수준 과학 추론), LCBv6(코딩)에서 같은 무게급 모델들과 경쟁력 있는 점수를 냈고, 메모리 대 성능·속도 대 성능 축에서 파레토 경계를 새로 찍었다고 밝혀요. 파레토 경계는 “이 크기와 속도에서 이만큼 똑똑한 모델은 없다”는 기준선이 움직였다는 뜻이에요.
다만 모델 카드는 한계를 솔직하게 적어 둬요. 에이전트 작업용 후속 학습은 거의 이루어지지 않았고, 일반 강화학습도 소규모에 그쳤다는 것이에요. Hacker News 토론에서는 지식 검색형 질문에 그럴듯하게 들리지만 틀린 답을 내놓는 사례도 지적됐어요. 추론 골격은 갖췄는데 범용 신뢰성이 아직 덜 붙은 상태예요. 그래서 이름이 프리뷰예요.
어떻게 연결되나
DeepGrove는 2026년 초에 0.5B 삼진 모델 Bonsai를 공개한 적 있는데, Maple-Preview는 같은 방법론을 40배 규모로 키우고 거기에 MoE를 얹은 결과물이에요. 삼진 학습이 작은 모델에서만 통하는 트릭이 아니라는 점이 이번 공개의 진짜 의미예요. 2024년 Spectra 논문이 삼진 LLM의 가능성을 보여줬다면, Maple-Preview는 그 가능성이 20B MoE까지 확장됐음을 증명한 셈이죠.
사용자 입장에서 의미는 간단해요. 클라우드 왕복 없이 기기 안에서 20B급 추론이 돌아가면 비용·프라이버시·오프라인 세 가지가 함께 좋아져요. MIT 라이선스라 상업적 이용·파인튜닝·재배포도 자유롭고요. 대신 지금 시점에 에이전트 작업까지 맡기기엔 이르니, 후속 학습을 거친 정식 버전을 기다리는 게 현실적인 선택이에요.
이 글의 출처
- 릴스: rupayanism, https://www.instagram.com/reel/DdG-nL1ASPe/
- DeepGrove, Maple-Preview 모델 카드
- DeepGrove, mlx-lm-deepgrove 공식 MLX 런타임 문서
- AI/TLDR, “Maple-Preview — 20B ternary MoE trained from scratch, 218 tok/s on a Mac mini”
- AI Beat, “Born Ternary” (2026-08-05)
- AI Weekly, “DeepGrove open-sources Maple-Preview, a 20B-A1B ternary MoE” (2026-08-06)
- Hacker News, “Show HN: Maple-Preview – ternary 20B MoE running at 120 tok/s on a iPhone”