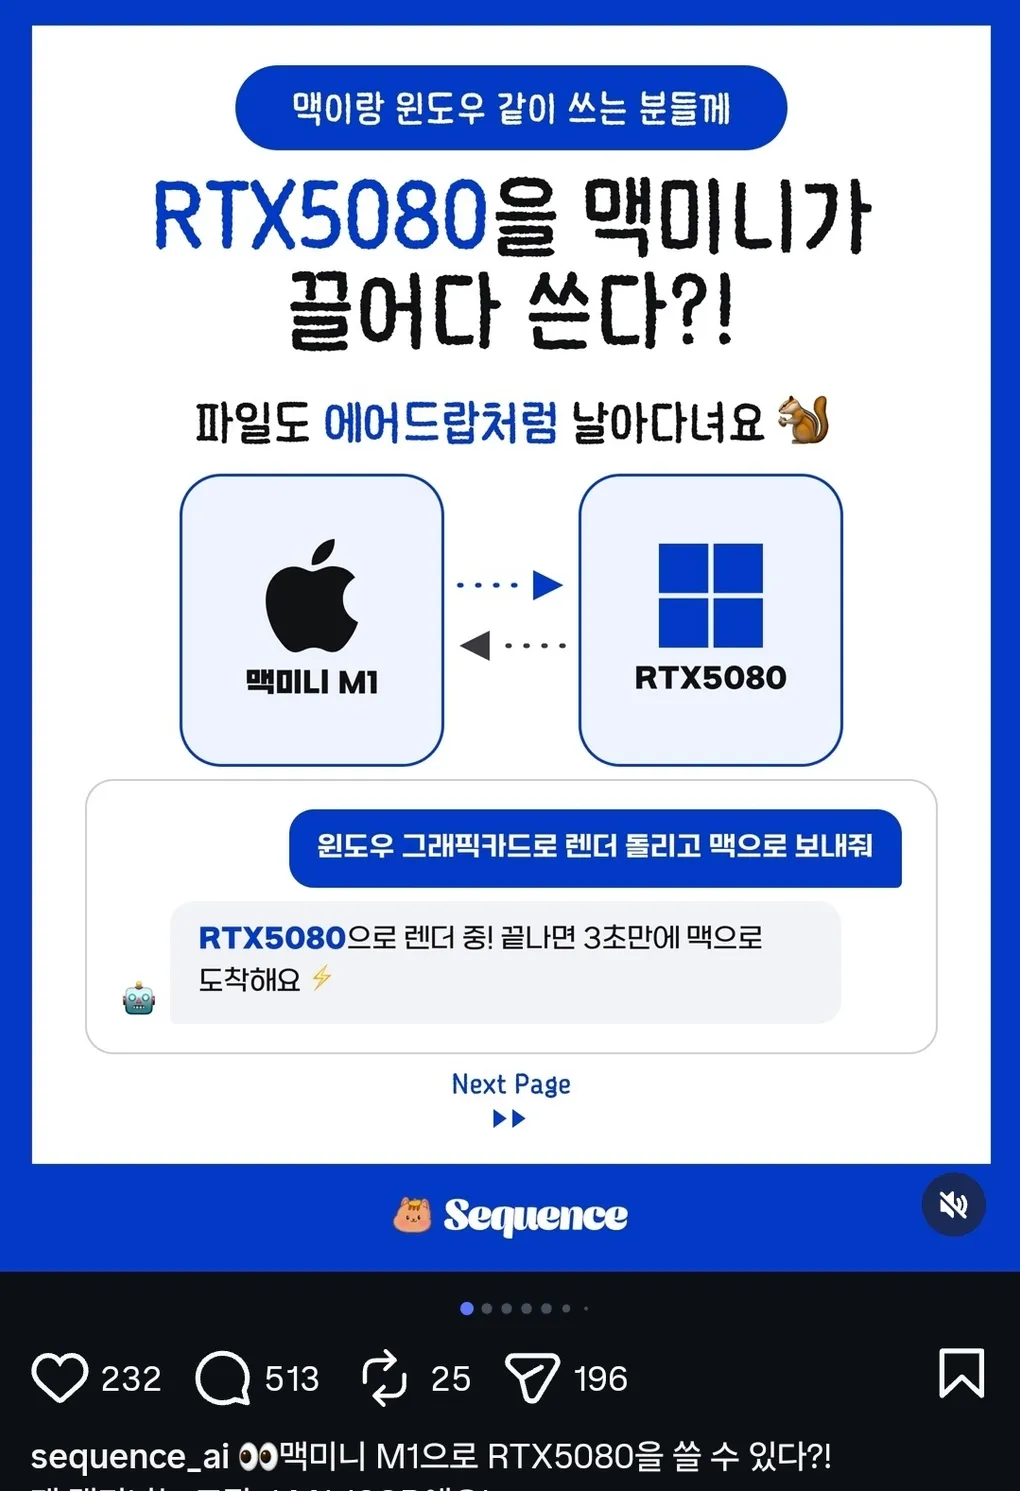
[릴스 해설] 맥미니 M1이 RTX 5080을 끌어다 쓰는 조합
한 줄 요약: 오래된 맥미니 M1을 그대로 두고, 무거운 렌더 작업만 RTX 5080이 달린 윈도우 PC로 던져 처리한 뒤 결과를 받아오는 구성이에요 — 두 기계를 같은 네트워크에 두고, GPU가 필요한 일만 ’위탁’하는 패턴이에요.
AI 도구 채널 sequence_ai의 카드뉴스 릴스예요. “맥이랑 윈도우 같이 쓰는 분들께”라는 부제로, 맥미니 M1과 RTX 5080을 탑재한 윈도우 PC를 나란히 놓고 대화 형식으로 데모를 보여줘요. “윈도우 그래픽카드로 렌더 돌리고 맥으로 보내줘”라는 요청에 “RTX5080으로 렌더 중! 끝나면 3초만에 맥으로 도착해요”라고 답하고, 파일도 “에어드랍처럼 날아다닌다”고 소개해요. 맥은 2020년에 나온 첫 Apple Silicon인 M1인데, 데스크톱 GPU인 RTX 5080과 짝을 이뤄 각자 잘하는 일을 나눠 가지는 구성이에요. 정확한 도구명은 이 스크린샷만으로 확인할 수 없지만, 이런 조합이 말이 되는 이유는 검증 가능한 스펙과 방식으로 설명할 수 있어요.
오래된 맥과 새 그래픽카드의 몸값 차이
M1은 2020년 11월에 나온 첫 세대 Apple Silicon으로, GPU는 8코어 규모에 성능이 수 TFLOPS 수준이에요. 반면 RTX 5080은 2025년 1월에 나온 Blackwell 기반 데스크톱 GPU로, CUDA 코어 10,752개, GDDR7 16GB(대역폭 초당 960기가바이트), 단정밀도 약 56 TFLOPS, 소비 전력 360W를 갖춘 카드예요. 격자 무늬로 비교하면 연산 성능이 대략 20배가량 차이 나는 셈인데, 출시 간격만 4년이 넘으니 놀랍지도 않아요. 중요한 것은 이 격차가 “새 컴퓨터를 사라”가 아니라 **“무거운 연산만 다른 컴퓨터에 맡기라”**는 답으로 이어진다는 점이에요.
네트워크 너머의 GPU를 쓰는 세 가지 방식
두 기계를 이렇게 묶는 데는 검증된 방법이 몇 가지 있어요.
첫째, 원격 API 서버 방식이에요. 윈도우 PC에 GPU 연산 서비스(예: AI 이미지 생성 도구, 3D 렌더 큐)를 상시 띄워 두면, 맥에서 파일과 작업 명령만 넘겨요. 연산은 전부 RTX 5080에서 끝나고 결과 파일만 돌아와요. 릴스의 “끝나면 3초만에 맥으로 도착”은 완성 파일의 전송 시간이지 연산 시간이 아니므로, 같은 네트워크(초당 수백 메가바이트~기가비트급)라면 충분히 성립하는 수치예요.
둘째, 화면 스트리밍 방식이에요. 윈도우 PC의 화면을 맥에서 원격 조작하는 방식으로, GPU를 직접 빌려 쓰는 게 아니라 GPU가 달린 컴퓨터를 멀리서 만지는 것에 가깝아요. 렌더 과정을 눈으로 봐야 할 때 유용해요.
셋째, 파일 파이프라인 방식이에요. 릴스가 “에어드랍처럼 날아다닌다”고 표현한 부분으로, 맥의 작업 폴더가 윈도우 쪽과 자동 동기화되어 맥에서 넣으면 윈도우가 처리하고 결과가 맥에 쌓이는 흐름이에요. 에어드랍은 애플 기기끼리만 되므로, 맥-윈도우 조합에는 LAN 기반 전송 도구나 공유 폴더가 그 자리를 대신해요. 어떤 도구를 썼는지는 릴스만으로 단정할 수 없지만, 이 세 방식 모두 정립된 기술이에요.
잘 맞는 작업과 안 맞는 작업
이 구성이 빛나는 경우는 배치(batch) 작업이에요. AI 이미지 생성, 3D 렌더, 동영상 인코딩처럼 “던져 놓고 기다리는” 작업은 네트워크 왕복 몇 초가 문제 되지 않아요. 반면 입력에 즉시 반응해야 하는 낮은 지연 작업(리얼타임 편집, 셰이더 미리보기)은 네트워크 지연이 그대로 답답함으로 느껴져요. 또 결과 파일의 크기가 클수록 전송 비용이 커지므로, 대용량 프로젝트 파일을 매번 왕복시키는 구조라면 공유 폴더 방식이 나아요. 요약하면 맥은 조용한 일상 머신으로, RTX PC는 무거운 연산의 전용 백엔드로 역할을 나누는 전략이에요.
이건 새 기술이 아니라 오래된 패턴이다
“맥이 GPU를 빌려 쓴다”는 구성은 새로운 아이디어가 아니에요. 3D 업계에서는 수십 년간 네트워크 렌더 팜(작업장의 여러 PC에 렌더를 분산시키는 방식)이 쓰였고, 지금도 CI 파이프라인이 빌드 서버를 호출하는 것도 같은 패턴이에요. 바꿔 말하면, 이 릴스의 신선함은 기술이 아니라 재활용에 있어요. M1 맥미니가 5년째 쓰던 머신이라는 점이 이야기의 절반이에요. 새 GPU 하나로 오래된 맥이 다시 무용지물이 되지 않는 구조를 만든 것, 그리고 그 과정을 카드뉴스 알고리즘으로 절차화해 보여준 것이 이 릴스의 실제 본질이에요.
어떻게 연결되는가
한 줄로 요약하면: 각 기계를 전문 분야로 나누고 네트워크로 잇는 것 — 맥은 일상과 파일, 윈도우는 GPU 연산 — 이 이 릴스의 전부이며, 이는 가장 검증된 컴퓨팅 패턴 중 하나예요.
이 블로그의 이전 글들과 연결하면 흐름이 이어져요. Namespace Labs 서버랍 글에서 데이터센터급 Apple Silicon과 고성능 서버를 섞어 쌓았다면, 이 릴스는 같은 원리의 개인 버전이에요. 128GB 통합 메모리 미니 PC 글의 Apple Silicon 이야기에 윈도우 GPU를 한 대 얹은 것이고요. 워크로드가 하드웨어를 결정한다는 원칙은 한 대의 책상에서도, 데이터센터에서도 똑같이 적용돼요.
출처: