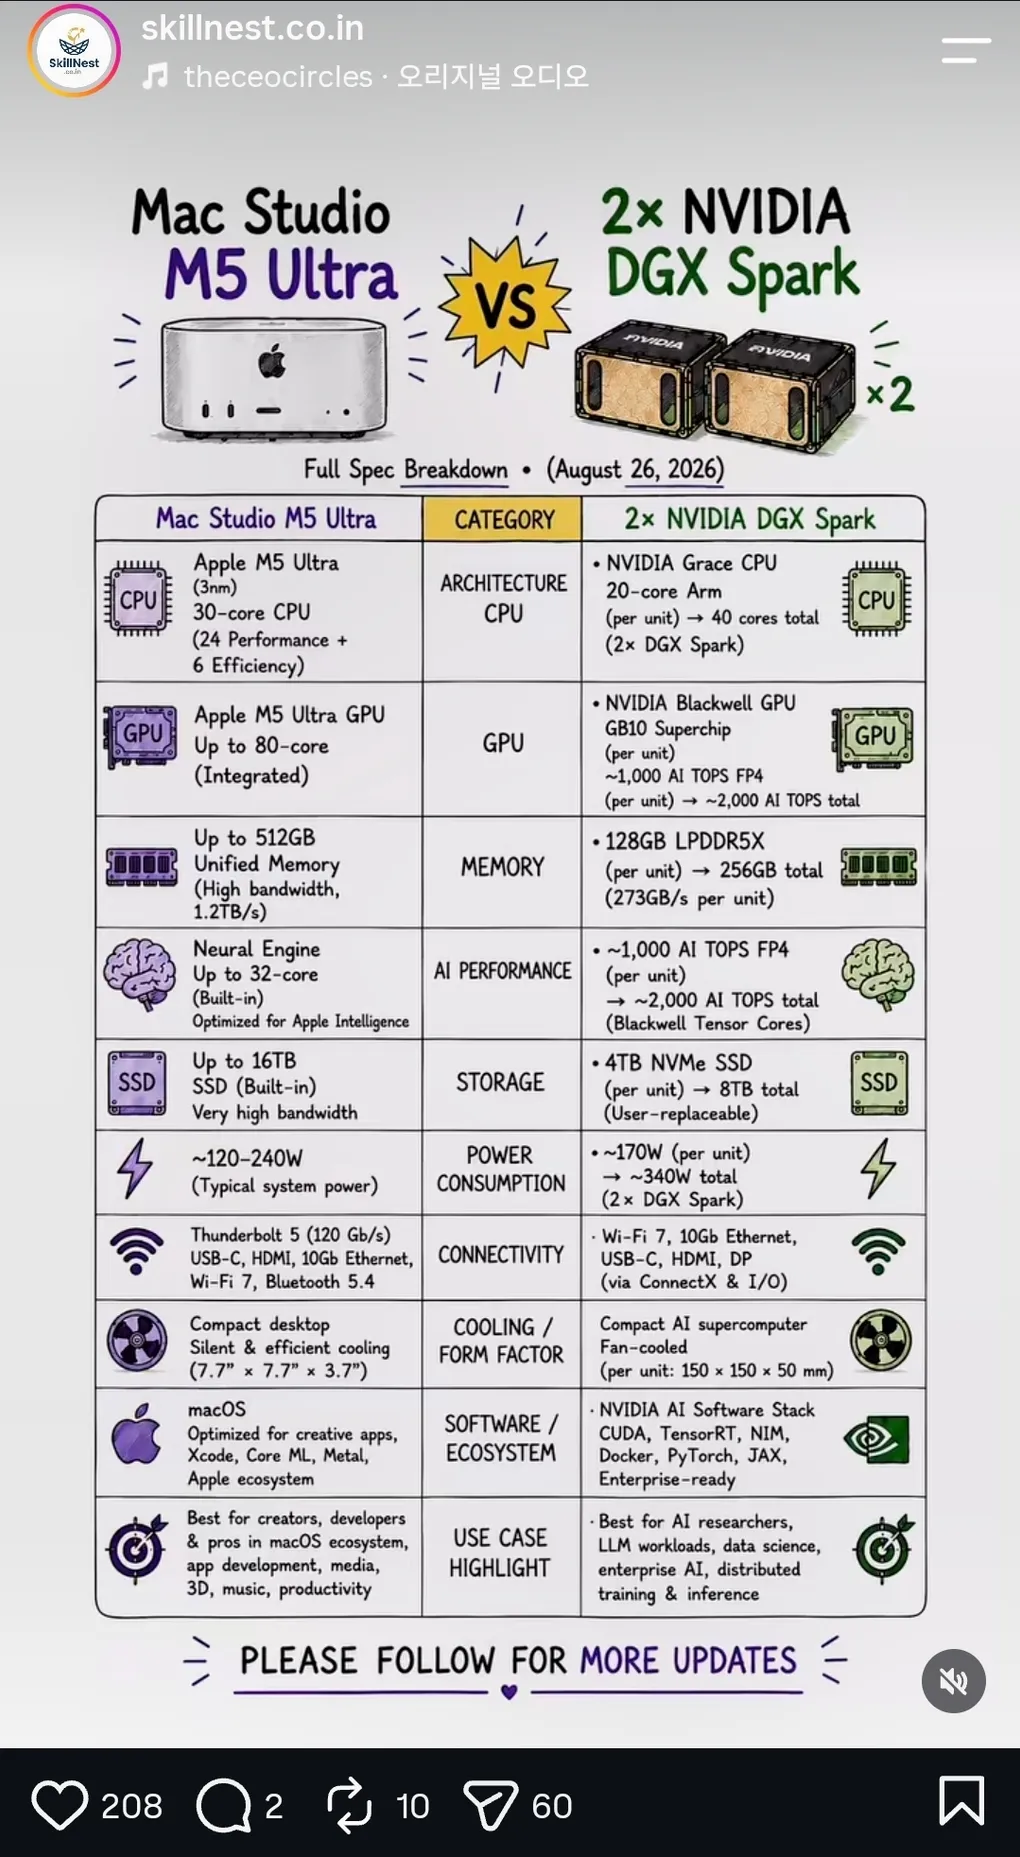
맥 스튜디오 M5 Ultra vs DGX 스파크 2대
한 줄 요약: 메모리와 대역폭이 무기인 Mac Studio M5 Ultra와 CUDA 생태계가 무기인 DGX 스파크 2대는 우열이 아니라 선택의 문제이고, 승자는 스펙표가 아니라 하려는 작업이 정해요.
skillnest.co.in이 올린 릴스예요. 8월 26일자로 표시된 인포그래픽 한 장을 보여주면서 “Mac Studio M5 Ultra vs 2× NVIDIA DGX Spark”의 스펙을 항목별로 비교해요. 타이밍이 재밌는데, 애플이 M5 Ultra를 탑재한 Mac Studio를 발표한 게 2026년 8월 25일이라 이 릴스는 발표 다음 날 나온 셈이에요. 인포그래픽은 10개 항목(CPU, GPU, 메모리, AI 성능, 저장장치, 전력, 연결성, 냉각·형태, 소프트웨어, 용도)을 표로 정리했는데, 자세히 대조해 보면 오류도 있어요. 이 글에서는 릴스에 보이는 스펙을 기준으로 풀되, 애플·NVIDIA 공식 자료와 대조해 확인한 정정 사항은 본문에 같이 적어둬요.
두 기계의 정체부터
릴스가 비교하는 두 기계는 완전히 다른 길을 걸어온 제품이에요. 비유하자면 한쪽은 넓은 작업대를 갖춘 올라운더 크리에이터이고, 다른 쪽은 AI 전문 도구를 쥔 연구원이에요.
Mac Studio M5 Ultra는 macOS를 올리는 데스크톱이에요. 애플 실리콘 칩 M5 Ultra를 탑재했고, 창작 앱·앱 개발·영상·3D·음악 같은 크리에이티브 작업과 대형 모델을 기기 안에서 돌리는 로컬 AI까지 겨냥해요. 크기는 7.7인치(19.7cm) 정사각형에 높이 3.7인치(9.5cm)이고, 릴스 표현대로 “소음이 적고 효율적인” 냉각 시스템을 갖춘 조용한 기계예요.
NVIDIA DGX 스파크는 NVIDIA가 내놓은 데스크톱 사이즈 AI 슈퍼컴퓨터예요. Grace Blackwell 아키텍처의 GB10 슈퍼칩(Blackwell GPU와 Arm CPU 20코어를 한 칩에 넣은 것)이 심장이고, CUDA, TensorRT, NIM, Docker, PyTorch, JAX 같은 NVIDIA AI 소프트웨어 스택이 기본 장착돼요. 용도는 AI 연구자, LLM(대규모 언어 모델) 작업, 데이터 과학, 분산 학습·추론이에요. 크기는 150×150×50.5mm에 무게 1.2kg으로, 맥 스튜디오보다 더 작아요.
512GB 통합 메모리의 의미
릴스에서 가장 규모 차이가 큰 항목은 메모리예요. 인포그래픽 기준 맥 스튜디오는 “최대 512GB 통합 메모리(unified memory), 높은 대역폭, 1.2TB/s”, DGX 스파크는 “128GB LPDDR5X(저전력 고대역폭 메모리), 유닛당 273GB/s, 두 대면 256GB”이에요.
통합 메모리는 CPU와 GPU가 하나의 메모리 풀을 함께 쓰는 구조예요. RAM은 프로그램이 지금 일하는 내용을 올려 두는 작업대인데, 일반 PC는 CPU용 작업대와 GPU용 작업대가 따로 있어서 데이터를 주고받을 때 복사해 옮기는 시간이 어요. 통합 메모리는 두 작업자가 같은 책상에서 일하는 구조라 그 복사 과정이 사라져요. 단, 책상을 두 사람이 나눠 쓰니 한쪽이 쓰는 만큼 다른 쪽 몫이 줄어드는 건 한계예요.
512GB가 실제로 어느 정도 큰지가 중요한데, 오픈웨이트(가중치를 공개해 누구나 내려받아 돌릴 수 있는) 언어 모델 가운데 가장 큰 축에 드는 4,000억 파라미터급 모델도, 정밀도를 낮춰 압축하는 양자화를 적용하면 통째로 올려 둘 수 있는 크기예요. 파라미터는 모델의 뇌에 새겨진 연결 강도인데, 크기가 곧 메모리 요구량이 되거든요. 여기에 대역폭 1.2TB/s가 붙어요. 대역폭은 작업대 위 물건을 꺼내는 속도에 가까워요. 추론은 답장 한 조각을 내는 동안에도 모델 가중치를 메모리에서 통째로 꺼내 읽는 작업을 반복하기 때문에, 이 속도가 답장이 나오는 속도를 크게 좌우해요. 앞 세대 M3 Ultra의 819GB/s에서 약 50% 빨라진 수치예요. 반면 DGX 스파크의 273GB/s는 맥 스튜디오의 약 4분의 1 수준이라, 메모리 대역폭만 따지면 명확하게 밀려요.
네 개의 두뇌를 잇는 울트라퓨전
인포그래픽에 없지만 이 비교를 이해하려면 꼭 짚어야 할 부분이 있어요. M5 Ultra는 애플 최초의 쿼드 다이(quad-die) 아키텍처예요. 다이(die)는 반도체 한 조각을 뜻하는데, M5 Ultra는 다이 네 개, 즉 두 개의 다이로 이루어진 M5 Max 칩 두 개를 차세대 UltraFusion(울트라퓨전)이라는 고속 연결로 묶어 하나처럼 동작시키는 구조예요. 두뇌 네 개를 두 개씩 잇고 다시 하나로 합치는 신경 다리라고 상상하면 쉬워요.
덕분에 CPU 코어 수도 늘어나요. 공식 스펙 기준 M5 Ultra는 기본 30코어(슈퍼 10 + 퍼포먼스 20)이고, 옵션으로 36코어(슈퍼 12 + 퍼포먼스 24)까지 올라가요. GPU는 기본 64코어에서 최대 80코어에, 코어마다 AI 연산 전용 회로인 뉴럴 액셀러레이터가 달렸고 뉴럴 엔진은 32코어예요. 여기서 인포그래픽 오류를 하나 정정할게요. 표에는 CPU를 “30코어(24 퍼포먼스 + 6 효율)“로 적었는데, 애플 공식 스펙은 슈퍼·퍼포먼스 두 종으로 구성되어 있고 이 표기는 틀렸어요. 릴스 캡션도 “최대 36코어”를 공식 스펙으로 안내하는 정정 문구를 달아두었어요.
FP4 TOPS, 숫자 읽는 법
AI 성능 항목에 “약 1,000 AI TOPS FP4(유닛당), 두 대면 약 2,000 TOPS”라고 적혀 있어요. TOPS는 초당 1조 번의 연산을 뜻하는 단위이고, FP4는 숫자를 4비트로 표현하는 낮은 정밀도 형식이에요. 소수점 뒤까지 정확히 계산하지 않고 큰 그림을 잡는 요약 계산으로 바꾸면 같은 하드웨어에서 훨씬 많은 연산을 처리할 수 있는데, FP4는 그 요약을 가장 공격적으로 하는 규격이에요. NVIDIA 공식 문서의 “최대 1,000 TOPS, FP4 정밀도·희소성(sparsity) 적용 시 최대 1 PFLOP”가 바로 이 기준이에요. 희소성은 0이 많은 계산을 건너뛰는 절약 기법으로, 이런 조건이 붙은 숫자는 “가장 유리한 조건에서 찍는 최대치”라는 점을 기억해 두면 좋아요.
그리고 캡션이 강조하는 경고가 여기서 나와요. “숫자를 단순히 더해서 두 배 성능이라고 가정하지 마라.” 두 대를 묶으면 TOPS는 2,000처럼 보여도 실제 성능은 모델 구조, 소프트웨어, 작업 종류에 따라 달라져요. 맥 스튜디오 쪽 스펙(최대 4.3배 GPU AI 연산 등)도 애플이 공개한 자사 대비 수치라는 점까지 감안하면, 이 표의 숫자들은 절대값이 아니라 성격을 보여주는 지표로 읽는 게 맞아요.
두 대를 묶는 ConnectX-7
릴스 제목의 “2ד가 바로 이 비교의 하이라이트예요. DGX 스파크는 한 대당 128GB 통합 메모리로 최대 200B(2,000억) 파라미터 모델까지 지원하는데, ConnectX-7이라는 스마트 네트워크 카드의 QSFP 포트를 전용 케이블로 직결하면 두 대를 하나의 클러스터처럼 묶을 수 있고, NVIDIA 공식 문서 기준 최대 405B(4,050억) 파라미터 모델까지 돌릴 수 있어요. 메모리도 두 대 합쳐 256GB 풀이 돼요.
두 명의 전문가가 전용 회선으로 연결돼 한 문제를 나눠 푸는 그림인데, 여기서 단서 하나. 일을 나누는 순간 두 사람 사이에 주고받는 통신 비용이 끼어들어요. 이 통신 비용이 작업 규모보다 커지면 두 대를 묶어도 두 배 속도가 아니에요. 이게 캡션의 “멀티노드 스케일링, 인터커넥트, 소프트웨어가 실제 성능을 결정한다”는 말의 의미예요. 재미있는 건 맥 스튜디오도 방법이 있다는 점이에요. Thunderbolt 5와 RDMA(원격 메모리 직접 접근 기술)로 시스템 네 대를 묶으면 분산 AI 추론이 한 대보다 최대 3배 빨라진다고 애플이 밝혔어요.
CUDA냐 macOS냐, 생태계 선택
인포그래픽 소프트웨어 항목이 사실 이 비교의 결승전이에요. DGX 스파크의 소프트웨어 스택은 CUDA(엔비디아 GPU용 표준 프로그래밍 환경)를 중심으로 TensorRT, NIM, Docker, PyTorch, JAX까지 갖춘 “엔터프라이즈 레디” 구성이에요. 오늘날 AI 연구와 개발은 CUDA가 사실상 표준 언어라서, AI를 만들고 다듬는 일 자체를 하려면 이 도구 상자가 그대로 무기가 돼요. 반면 맥 스튜디오는 macOS 위에서 Xcode, Core ML, Metal로 대표되는 애플 생태계에 최적화되어 있고, 크리에이터 앱과의 연결이 강점이에요.
다시 비유하면, DGX 스파크는 AI 연구원의 표준 작업실 세팅이고 맥 스튜디오는 크리에이터의 작업실이에요. 도구가 다르니 어느 한쪽이 “더 좋은 컴퓨터”가 아니라, 무슨 일을 하느냐가 기계를 골라요. 릴스 캡션도 같은 결론이에요. CUDA/LLM 개발과 AI 연구·NVIDIA 도구가 목적이면 DGX 스파크, 방대한 통합 메모리와 macOS 크리에이티브 작업이 목적이면 맥 스튜디오.
스펙표에 안 적힌 것들
전력과 가격도 짚어둘게요. 인포그래픽은 DGX 스파크 전력을 유닛당 약 170W로 적었지만, 공식 스펙은 GB10 칩 TDP(열 설계 전력) 140W에 외장 전원 공급장치 240W예요. 이것도 캡션이 정정해 준 부분이에요. 맥 스튜디오 쪽은 표기가 “시스템 전력 120~240W”인데, 공식 최대 연속 전력은 480W이에요. 인포그래픽이 강조한 “조용하고 효율적인” 크리에이터 기계라는 성격은 이런 전력 대비 냉각 성능에서 나온 거예요.
가격은 릴스 표에 없지만 참고로, M5 Ultra Mac Studio는 5,499달러부터고 DGX 스파크는 3,999달러로 발표됐지만 2026년 2월 메모리 수급난으로 4,699달러로 인상돼 두 대면 9,400달러 가까워져요. 저장장치도 참고할 만해요. 맥 스튜디오는 최대 16TB SSD에 새로운 PCIe Gen 6 아키텍처로 저장 속도가 최대 2배 빨라졌다고 애플이 밝혔고, DGX 스파크는 4TB NVMe SSD에 자체 암호화가 들어가요. 512GB 통합 메모리 구성은 본체 출하보다 늦은 10월 말부터 공급된다고 애플이 안내했어요. 연결성 표기에서도 오류가 하나 있어요. 인포그래픽은 맥 스튜디오 무선을 Bluetooth 5.4로 적었지만 공식 스펙은 애플 N1 칩의 Bluetooth 6이고, 5.4는 DGX 스파크 쪽 사양이에요.
작업이 승자를 정한다
정리하면 이 릴스는 “로컬 AI 머신 두 길”의 선택지를 보여줘요. 맥 스튜디오 M5 Ultra는 512GB 통합 메모리와 1.2TB/s 대역폭으로 거대 모델을 한 기계 안에 통째로 올려 두는 길이고, DGX 스파크 2대는 전용 회선으로 묶어 256GB 풀과 CUDA 생태계로 분산 AI를 하는 길이에요. 두 기계가 결국 같은 목표를 겨냥하고 있으면서도 정답은 스펙표가 아니라 하려는 작업에 있다는 것, 이 릴스가 보여주는 핵심은 그 두 가지예요. 숫자를 그대로 외우기보다, “내 작업대에는 무엇이 올라가는가”를 먼저 떠올려 보시길 추천해요.
출처
- 릴스: skillnest.co.in, “Mac Studio M5 Ultra vs 2× NVIDIA DGX Spark — Full Spec Breakdown” (https://www.instagram.com/reel/Dcg1S3JISGd/)
- Apple Newsroom, “Apple introduces new Mac Studio with M5 Max and M5 Ultra” (2026-08-25)
- Apple, Mac Studio 기술 사양
- iClarified, “M5 Max and M5 Ultra Mac Studio: What’s New vs. the Previous Generation?” (2026-08-25)
- NVIDIA, DGX Spark User Guide — Hardware Overview