27B 모델을 3.9GB로: Bonsai 27B 1비트
한 줄 요약: Prism ML이 Qwen3.6-27B를 삼진·1비트 가중치로 끝까지 압축한 Bonsai 27B를 공개해, 1비트 빌드 3.9GB로 아이폰에 27B급 모델이 처음 들어가고 벤치마크 90~95%를 유지했어요.
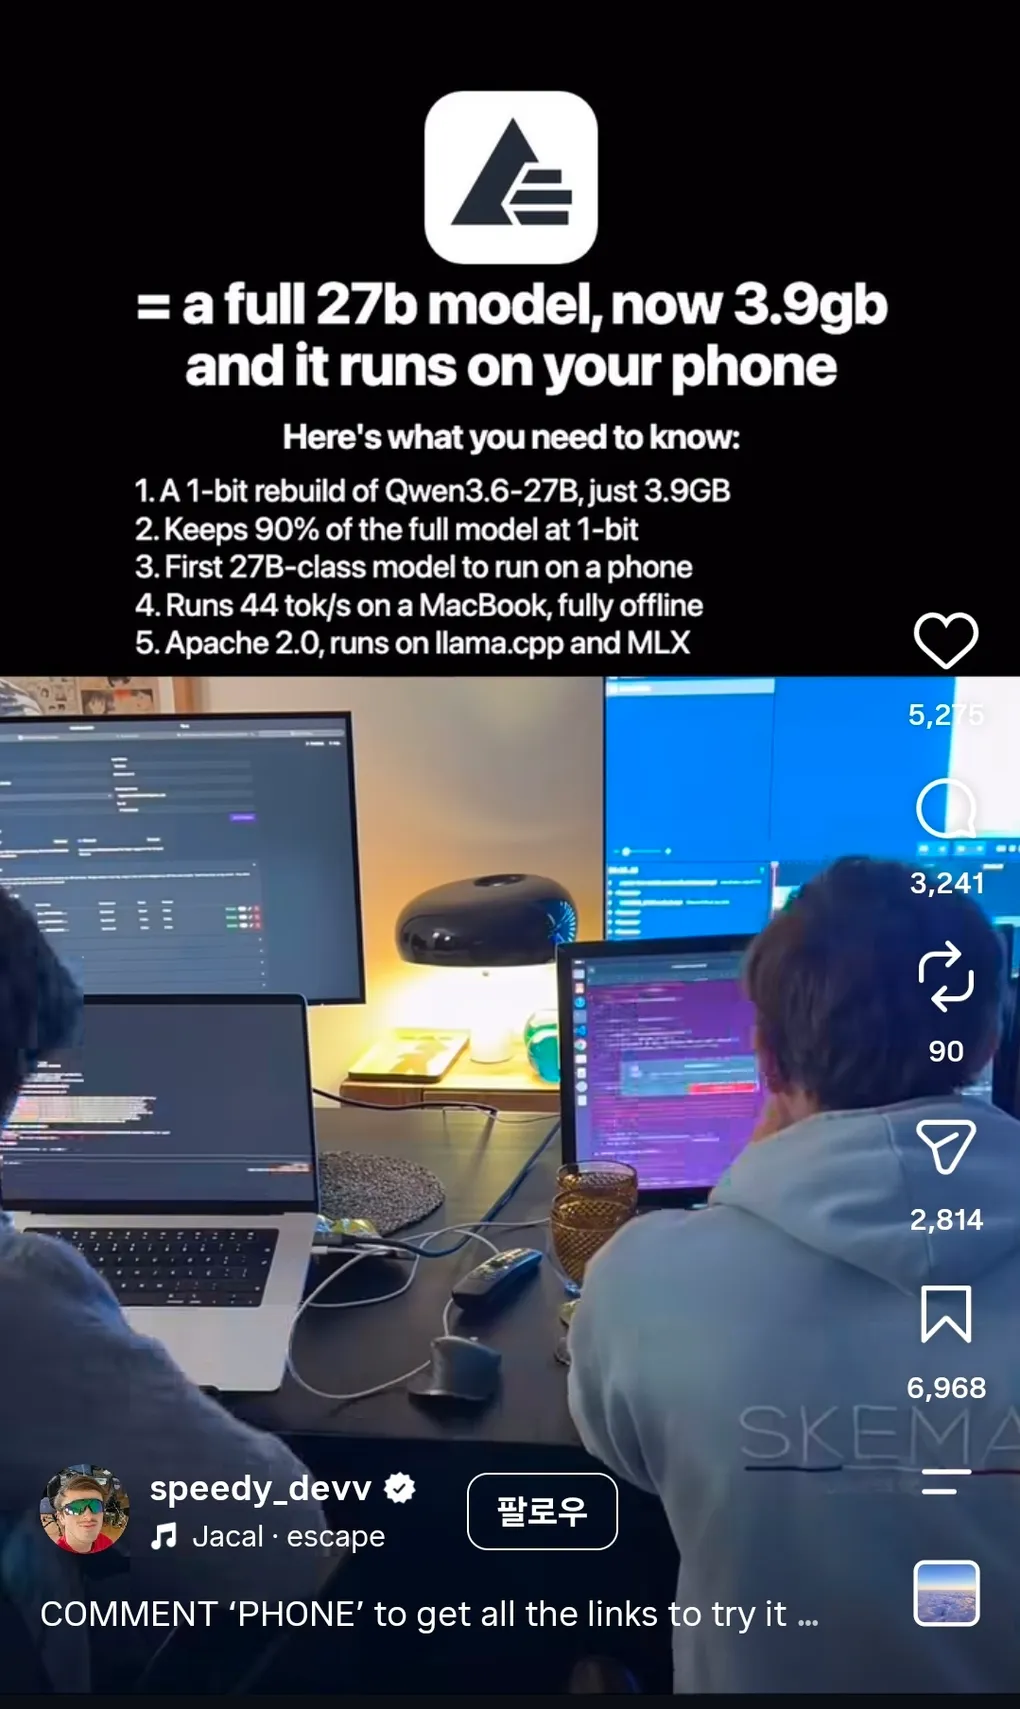
speedy_devv님이 올린 릴스예요. “a full 27b model, now 3.9gb and it runs on your phone”이라는 제목으로 다섯 항목을 소개해요. ① Qwen3.6-27B의 1비트 재구축이 3.9GB라는 것, ② 1비트에서도 원본 성능의 90%를 유지한다는 것, ③ 폰에서 도는 최초의 27B급 모델이라는 것, ④ 맥북에서 초당 44토큰으로 완전 오프라인 실행된다는 것, ⑤ Apache 2.0으로 llama.cpp와 MLX에서 돌아간다는 것까지요. 다섯 항목을 Prism ML의 공식 발표문과 Hugging Face 모델 카드로 대조했는데, 모두 공식 수치와 일치했어요. 다만 ’44 tok/s 맥북’은 1비트 빌드 기준 Apple M5 Pro 수치이고, 벤치마크가 개발사 자체 보고라는 점은 본문에서 따로 짚어요.
27B를 담으려면 얼마나 필요할까
Qwen3.6-27B는 알리바바 Qwen 팀의 오픈 가중치 모델로, 270억 개 파라미터의 밀집(dense) 모델이에요. 비전 입력을 받는 멀티모달이고, 64개 층 가운데 4개 중 3개를 선형 어텐션으로 쓰는 하이브리드 구조로 26만 토큰 컨텍스트를 지원해요. 문제는 크기예요. 16비트 부동소수점(BF16)으로 저장하면 약 54GB가 필요하고, 흔히 쓰는 4비트 양자화를 해도 18GB라서 폰은커녕 대부분의 노트북 메모리에도 넉넉하지 않아요. Prism ML의 발표문이 지적하는 것도 이 지점이에요. 그동안 27B급 모델을 기기 안에 담는 것이 비실용적이었던 이유는 단순히 용량 때문이에요.
삼진과 1비트, 두 가지 버전
Bonsai 27B는 두 가지 운영점으로 나와요. 삼진(ternary) 빌드는 각 가중치를 −1, 0, +1 세 값만으로 저장해 128개 가중치마다 FP16 스케일 하나만 곁들이고, 유효 비트가 파라미터당 1.71비트, 배포 크기 약 7.2GB예요. Apple M5 Pro 노트북에서 초당 26토큰이에요. 1비트 빌드는 −1, +1 두 값만 써서 유효 비트 1.125비트, 배포 크기 3.9GB로 FP16 대비 약 14배 작아지고, 같은 M5 Pro에서 초당 44토큰, 아이폰 17 Pro Max에서도 초당 11토큰이 나와요. 릴스의 ’3.9GB’와 ’44 tok/s 맥북’은 이 1비트 빌드 이야기예요.
이 압축이 특별한 이유는 적용 범위예요. 보통 저비트 양자화는 일부 층만 낮추고 중요한 부분을 16비트로 남겨두는 ’탈출구’를 두는데, Bonsai 27B는 임베딩·어텐션·MLP·출력 헤드까지 언어 모델 전체를 끝까지 저비트로 눌러 담았어요. 비전 타워만 4비트로 유지해 이미지 입력을 살렸고, KV 캐시도 4비트로 눌러 긴 대화의 메모리 부담을 줄였어요. 실행은 llama.cpp(CUDA·Metal·CPU)와 MLX(애플 실리콘) 양쪽을 지원하며, llama.cpp 커스텀 커널이 팩된 저비트 가중치를 16비트로 풀지 않고 직접 소비해요. 전부 Apache 2.0으로 공개됐고요.
벤치마크는 얼마나 남나
Prism ML은 15개 벤치마크를 사고 모드(thinking mode)로 평가한 결과를 공개했어요.
| 영역 | Qwen3.6-27B 원본 | 삼진 (95%) | 1비트 (90%) |
|---|---|---|---|
| 수학 (GSM8K·MATH-500·AIME 등) | 95.3 | 93.4 | 91.7 |
| 코딩 (HumanEval+·MBPP+ 등) | 88.7 | 86.0 | 81.9 |
| 에이전틱·도구 호출 (BFCL v3·TauBench) | 80.0 | 74.0 | 66.0 |
| 지식·STEM (MMLU-Redux·MuSR) | 83.1 | 77.0 | 73.4 |
| 비전 (MMMU Pro·OCRBench) | 72.6 | 65.2 | 59.6 |
| 전체 평균 | 85.0 | 80.5 | 76.1 |
읽을 거리는 평균보다 항목별 패턴이에요. 수학은 삼진 빌드 기준 2포인트 이내로 거의 무손실이고, 코딩도 선방하지만 에이전틱·도구 호출과 비전은 손실이 커져요. 그래도 중요한 건, 기존 저비트 양자화에서 추론·도구 호출 능력이 보통 4비트 아래에서 무너진다는 점을 감안하면 이 영역들이 2비트 미만에서 살아남았다는 것. 같은 모델의 기존 최저비트 빌드(IQ2_XXS, 72.73점)보다 점수가 높으면서 메모리도 적게 쓴다는 게 Prism ML의 비교 주장이에요. 다만 이 수치는 개발사 자체 보고라는 점은 남아 있어요. 기사들도 독립 검증이 남은 과제라고 짚고 있어요.
폰에 들어가는 게 어려운 이유
’폰에서 처음’이라는 문구의 배경도 기술적이에요. 폰은 앱에 메모리 전체를 주지 않아요. 12GB 램 아이폰이라도 앱이 쓸 수 있는 건 6GB 정도고, 그 안에서 KV 캐시와 활성치도 나눠 써야 해요. 기존 방식의 27B 모델은 어느 빌드도 이 문턱을 넘지 못했는데, 3.9GB짜리 1비트 빌드가 최초로 통과했다는 것이 이번 발표의 골자예요. 그래서 두 빌드가 의도적으로 나뉜 거예요. 삼진은 노트북급 품질을, 1비트는 폰급 발자국을 담당해요. 여기에 Apple이 Prism ML과 대형 모델의 온디바이스 실행을 논의 중이라는 CNBC 보도도 나와 있어요.
어떻게 연결되나
앞서 다룬 Maple-Preview 글과 이어지는 흐름인데, 비교하면 방법론의 양극단이 보여요. Maple-Preview는 처음부터 삼진 가중치로 학습한 모델이고, Bonsai 27B는 완성된 Qwen3.6-27B를 학습 후에 압축한 결과예요. 목표는 같은 ’저비트·온디바이스’인데 경로가 다르고, 이번엔 압축 진영이 27B급 멀티모달까지 도달한 셈이죠. 이름도 참고할 점이 있는데, Maple-Preview 글에 나온 DeepGrove의 Bonsai(0.5B, 처음부터 삼진 학습)와 이름이 같아 헷갈리기 쉽지만, 이번 Bonsai 27B는 Prism ML이 Qwen을 압축해 만든 별개 프로젝트예요.
속도가 빨라지는 원리도 저비트의 본질을 보여줘요. 기기에서의 추론은 계산보다 메모리에서 가중치를 읽어 오는 대역폭이 병목인데, 토큰 하나를 뱉을 때마다 가중치 전체를 읽어야 하니 비트가 줄면 읽는 양이 그만큼 줄고 속도가 올라가요. 27B급 추론·도구 호출 능력이 폰 안에 들어오면, 프라이버시가 필요한 에이전트 작업과 오프라인 활용의 판이 바뀌어요. 물론 벤더 자체 벤치마크라는 조건은 붙지만, 54GB짜리 모델이 3.9GB로 폰에 들어갔다는 사실 자체가 이 흐름의 의미예요.
이 글의 출처
- 릴스: speedy_devv, https://www.instagram.com/reel/Da0UiHfsvUk/
- Prism ML, “Announcing Bonsai 27B: The First 27B-Class Model to Run on a Phone” (2026-07-14)
- prism-ml, Bonsai-27B-gguf 모델 카드 (llama.cpp, 1비트)
- prism-ml, Bonsai-27B-mlx-1bit 모델 카드 (Apple Silicon)
- prism-ml, Ternary-Bonsai-27B-gguf 모델 카드 (삼진)
- Intelligent Living, “1-Bit LLMs Bring 27B-Class AI to Laptops and Phones” (2026-08-19, 2026-09-09 개정)
- Qwen, Qwen3.6-27B 모델 카드 (Hugging Face)