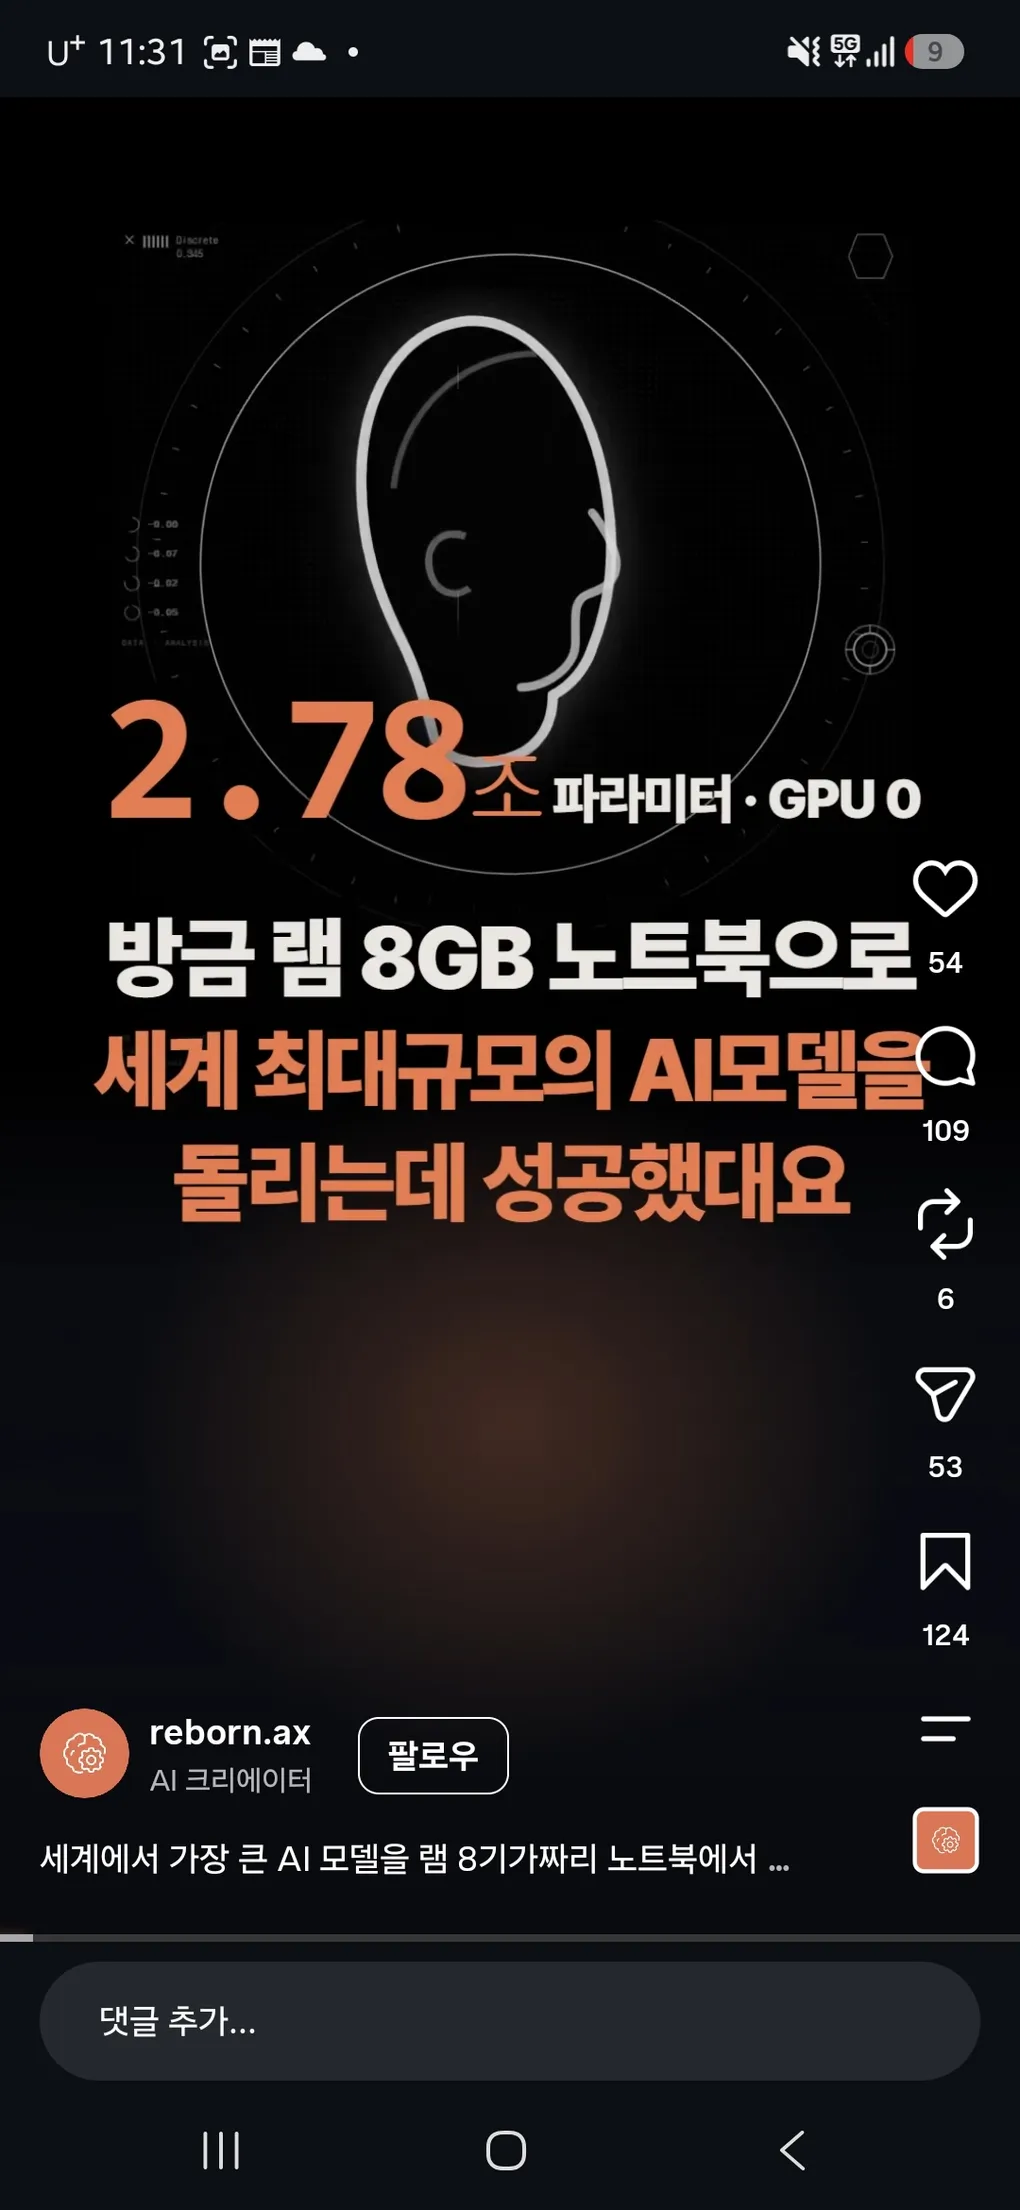
[릴스 해설] 램 8GB에서 초대형 모델이 돌아가는 이유
한 줄 요약: 램 8GB에서 초대형 모델이 도는 것은 맞아요 — MoE의 희소 구조, llama.cpp의 mmap 스트리밍, 스왑, 저비트 양자화가 겹치면 “돌아가긴” 하거든요. 대신 속도라는 대가를 그 자리에서 치러요.
AI 크리에이터 reborn.ax의 릴스예요. 화면에는 검은 배경에 형광 아웃라인으로 그려진 추상적인 얼굴과 함께, 큰 숫자로 **“2.78초 | 파라미터 · GPU 0”**라는 지표가 어요. 캡션은 “세계에서 가장 큰 AI 모델을 램 8기가짜리 노트북에서…“로 시작해요. 첫인상은 불가능해 보이지만, 이 화면의 요소들을 하나씩 맞춰 보면 기술적으로 성립하는 이야기임을 알 수 있어요. 다만 몇 가지는 릴스만으로는 단정할 수 없어요. 출처로 검증하며 풀어 보겠어요.
먼저 확인해야 할 것: 어느 ’최대’인가
“세계 최대 AI 모델”이라는 표현은 보통 수천억~수조 파라미터급 MoE 모델(Kimi K2, 딥시크-V3 계열)을 가리킬 때 쓰는 말이에요. 정확히 어떤 모델인지, 어떤 도구로 돌렸는지는 이 스크린샷만으로는 확인되지 않아요. 다만 화면의 **“GPU 0”**라는 표시는 해석이 분명해요. 그래픽카드를 하나도 쓰지 않았고, 전적으로 CPU(그리고 시스템 메모리와 저장장치)로 돌렸다는 뜻이에요. “2.78초”가 무엇의 시간인지(첫 토큰 도달 시간인지, 응답당 시간인지, 토큰당 시간인지)도 릴스만으로는 확정할 수 없어요. 이를 전제로 가능성을 풀어 봐요.
가능성 1: MoE는 뇌의 대부분을 쓰지 않는다
현대의 최대형 모델은 대부분 MoE(Mixture of Experts) 구조예요. 사람도 두뇌 전체를 동시에 다 쓰지 않죠. MoE에서 모델은 ’총 파라미터’와 ’활성 파라미터’로 나뉘요. 대표 예로 딥시크-V3는 총 671B 수준이지만 한 토큰마다 실제로 깨어 쓰는 것은 약 37B이에요. 전문가 신경망 대부분은 토큰마다 사용되지 않아요. 즉 파일 크기는 천GB급이어도, 각 순간에 실제로 계산에 걸리는 것은 그 일부라는 뜻이에요. 메모리 절약 전략은 이 희소성을 이용해요 — 항상 쓰는 부분(어텐션·공용 레이어)만 메모리에 두고, 전문가 가중치는 exps=CPU 같은 텐서 오버라이드로 CPU와 디스크 쪽에 두는 것이 llama.cpp에서 검증된 기법이에요.
가능성 2: mmap과 스왑 — 디스크가 메모리의 연장이 된다
llama.cpp의 기본 로딩 방식은 mmap예요. 모델 파일을 가상주소에 매핑해 두고, 실제로 접근하는 페이지만 메모리로 끌어오는 요구 페이징(demand paging) 방식이에요. 로드가 즉시이고 파일 전체를 다 읽지도 않아요. RAM이 부족하면 운영체제의 스왑이 개입해 안 쓰는 페이지를 SSD로 내보내요. 책상 위 공간이 좁아지면 자주 꺼내지 않을 물건을 서랍으로 옮겨 두는 요령이에요. 검증 출처에 따르면 모델이 노트북 RAM보다 크면 Ollama·LM Studio는 스왑을 쓰면서 추론 속도가 초당 1~5토큰 수준으로 떨어져요. 즉 “돌아간다”와 “느긋하게 돌아간다”는 다른 문장이지만, 같은 문장 안에 존재할 수는 있어요. 참고로 --no-mmap으로 전체를 램에 강제 상주시키는 방식은 모델이 총 RAM보다 크면 로드 자체가 실패하고, MoE 모델과 조합했을 때 메모리 임계 에러가 보고된 사례가 있으니 저램 환경에는 mmap 유지가 안전해요.
가능성 3: 저비트 양자화
마지막 열은 양자화예요. GGUF의 동적 저비트 양자화(2비트 이하)는 모델 크기를 극단적으로 줄여, 같은 RAM에 더 많은 전문가를 머물게 해요. 물론 속도보다 품질이 먼저 희생되기 시작하는 지점이기도 해요. 세 가지가 합쳐지면 — 희소한 MoE 구조, mmap에 의한 부분 로딩, 극단적인 양자화, 그리고 넉넉한 NVMe SSD — “램 8GB + 전용 GPU 0개”라는 구성에서도 토큰 하나하나를 뽑아 내는 것은 설명이 돼요.
대가는 어디서 치러지나
여기서 중요한 질문은 “가능한가”가 아니라 “성공했다”의 정의예요. 릴스 화면의 “2.78초”가 무엇의 시간인지는 단정할 수 없지만, 만약 (거의) 토큰당 시간이라면 한 문장을 완성하는 데 수 분이 걸린다는 뜻이에요. 검증 출처들에 따르면 RAM보다 큰 모델을 스왑으로 굴리면 토큰 속도가 초당 1~5개 수준으로 떨어지고, 병목은 CPU 계산이 아니라 메모리와 디스크 대역폭이에요. 페이지 폴트가 반복되며 SSD가 계속 읽히고, 장기 사용이라면 NVMe 수명과 열까지 부담이 돼요. 또 프롬프트 처리(입력문 전체를 압축하는 단계)는 토큰 생성보다 더 많은 가중치를 훑어야 해서 더 느려지기 쉬워요. 정리하면: 데모와 일회성 실험으로는 성공이고, 일상 대화 도구로는 아직 아닌 영역이에요.
어떻게 연결되는가
한 줄로 요약하면: MoE의 희소성과 mmap 스트리밍, 극단 양자화가 겹치면 하드웨어의 상한선은 소프트웨어가 계속 밀어 옮긴다 — 다만 속도라는 세금이 함께 움직인다는 이야기예요.
이 시리즈의 다른 글들과 합치면 로컬 LLM의 가능성 지도가 채워져요. GGUF 양자화 글에서 같은 모델을 여러 크기로 쪼개는 원리를, 4-bit VRAM 예산 글에서 필요량 계산법을, 128GB 미니 PC 글에서 하드웨어 문턱을 다뤘다면, 이번 릴스는 그 문턱 아래에서도 무언가를 해 내려는 실험이에요. 재미있는 것은 이전 글들이 “더 빠르게”였다면 이번엔 “더 크게”라는 반대 방향이라는 점이에요. 두 방향이 같은 llama.cpp를 공유하면서 다른 노브를 돌린다는 것도, 결국 워크로드가 설계를 결정한다는 같은 원칙의 연장선이에요.
출처: