같은 맥에서 4배 빠른 로컬 추론, Uzu
한 줄 요약: Apple Silicon용 오픈소스 추론 엔진 Uzu는 “토큰 하나를 뽑을 때마다 모델 전체를 읽는” 디코딩의 메모리 병목을 트리 스페큘러티브 디코딩으로 깨서, 같은 맥·같은 모델에서 llama.cpp 대비 최대 4배 속도를 냅니다.
최근 SNS에서 “같은 맥북, 같은 모델인데 생성 속도가 4배”라는 비교 영상이 화제여서 직접 확인해 봤어요. 비교 대상은 미라이 랩스(Mirai Labs)가 공개한 Uzu입니다. GitHub 리포와 공식 벤치마크 페이지·기술 블로그의 수치로 하나씩 대조했어요.
비교 자체는 간단합니다. Qwen3.5 9B 모델을 동일한 16GB M5 맥북 프로에서 돌렸을 때 llama.cpp는 초당 22토큰, MLX는 25토큰, Uzu는 92토큰이었어요. llama.cpp 기준으로 약 4.2배입니다. 같은 칩, 같은 모델 파일인데 이만큼 갈리는 이유를 답 한 줄로 요약하면 “Uzu는 한 번의 계산으로 여러 토큰을 확정할 수 있습니다”가 돼요. 이 원리를 아래에서 차례로 풀어 봅니다.
한 패스에 토큰 하나, 디코딩은 느릴 수밖에 없는 구조
로컬 추론의 ‘생성’ 단계는 배치 1(batch size 1)입니다. 대화 앱이 사용자 한 사람의 답을 순서대로 만들어 내는 중이라, 수십 건을 한 번에 묶어 계산하는 서버와 달리 GPU에게 같이 처리할 일을 주기 어려워요.
이때 속도의 상한이 연산량이 아니라 메모리 읽기 속도로 결정된다는 점이 핵심입니다. 토큰 하나를 뽑으려면 모델의 가중치 전체를 한 바퀴 읽어야 해서, 초당 토큰 수는 대략 ’초당 읽을 수 있는 바이트 ÷ 모델 크기’로 정해져요. 이 물리 한계는 엔진을 몇 번 다시 짜도 자동재귀(autoregressive) 방식, 즉 토큰을 앞에서부터 하나씩 뽑는 방식으로는 벗어나기 어렵습니다.
숫자로 대입해 보면 명확해요. 이 시험의 맥북 프로에 탑재된 베이스 M5 칩의 메모리 대역폭은 애플 공개 스펙 기준 초당 153GB이고, 4비트로 양자화한 Qwen3.5 9B(Mirai-M) 모델 파일은 약 6GB입니다. 153 ÷ 6 ≈ 25.5이므로 이론 상한이 초당 25토큰 안팎이에요. 앞서의 실측, llama.cpp 22토큰과 MLX 25토큰은 정확히 이 상한에 착지한 값입니다. 다시 말해 두 엔진은 이미 하드웨어 한계쪽에 붙어 있었고, 방식 자체를 바꾸지 않는 한 더 빨라질 여지가 없었어요.
미리 여러 토큰을 쓰고, 한 패스로 검증하는 방법
착안점은 “읽어야 할 가중치는 그대로인데, 한 패스가 확인할 수 있는 토큰은 하나가 아니다”라는 사실이에요. 스페큘러티브 디코딩(Speculative decoding, 먼저 써 보고 검증으로 채택하는 생성 방식)은 이를 이용합니다. 작은 ’드래프트 모델’이 답변의 뒷부분을 여럿 미리 작성하면, 본 모델이 이를 한 패스로 병렬 검사하고 틀린 지점부터 이어서 다시 쓰는 방식이에요.
비유를 하나 붙이면 핵심 작가 옆의 속기사를 둔 셈입니다. 속기사(작은 드래프터)가 여러 문장을 미리 적어 올리면, 핵심 작가(본 모델)는 한 번 훑어 맞는 구간까지 승인 도장을 찍는다고 생각하면 돼요. 승인 1회당 확정되는 문장이 여러 개라, 작가가 직접 문장 하나씩 쓰는 것보다 훨씬 진도가 나갑니다. 틀린 부분은 버리고 그 지점부터 다시 쓰면 되므로, 최종 문장의 품질은 작가가 통제합니다.
여기까지가 범용 원리인데, 이 방법의 성적을 좌우하는 것은 ’한 패스에 확정되는 토큰 수’예요. Uzu가 다른 구현보다 빠른 이유는 결국 이 수를 크게 잡는 설계에 있습니다.
M5에 맞춘 드래프트 트리 설계
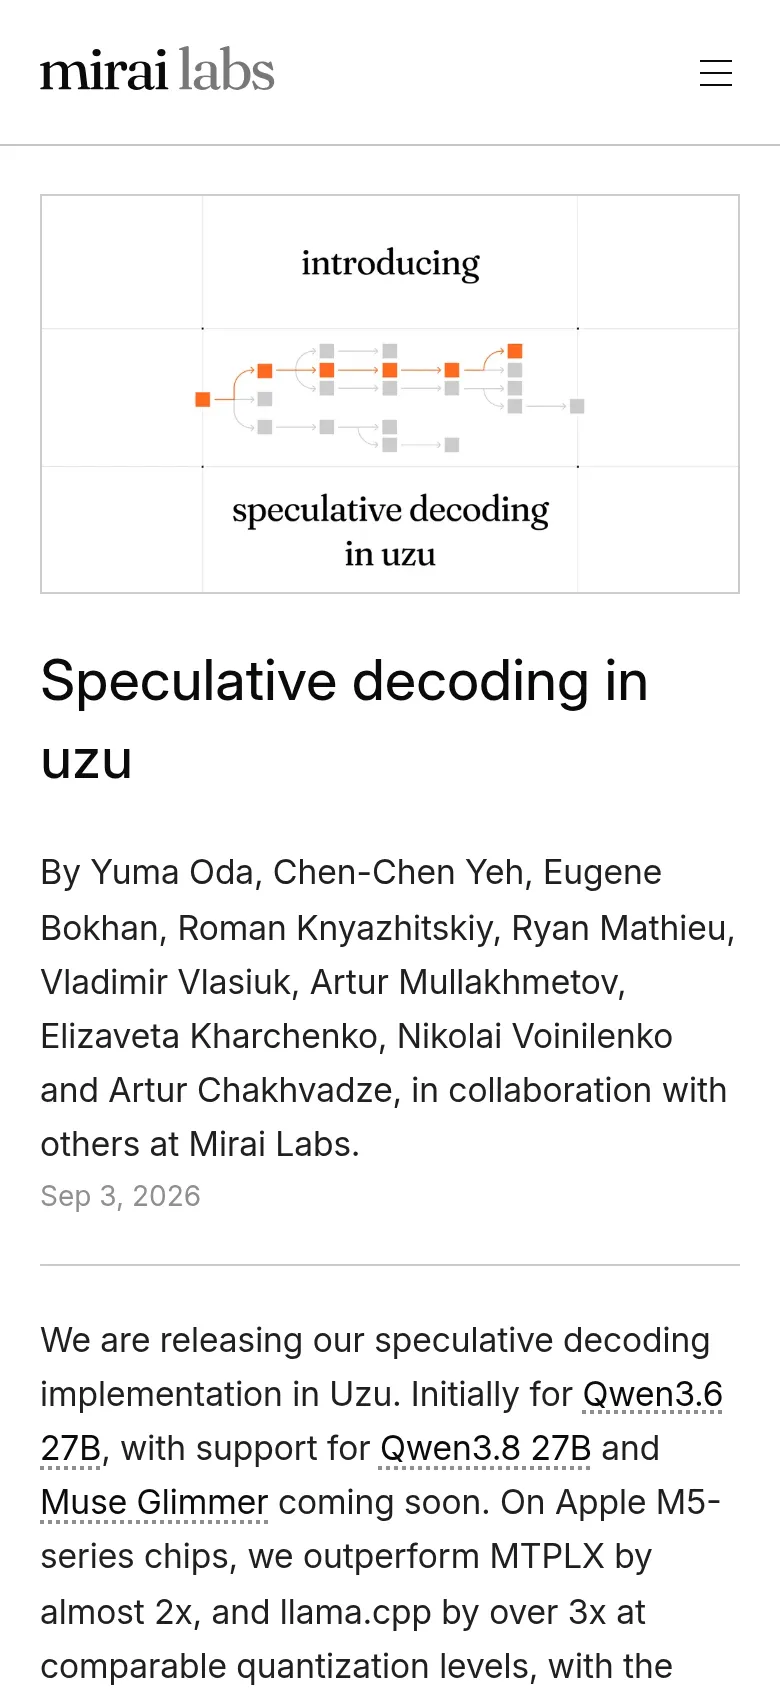
미라이 랩스의 기술 블로그(9월 3일)에는 설계 세부가 공개돼 있어요. 뽑아 보면 네 가지입니다.
먼저 제안 예산이 큽니다. 흔한 모델 내장 MTP(multi-token prediction, 모델이 자기 다음 토큰을 미리 몇 개 내다보는 보조 헤드) 구조가 한 차례에 3~4개를 제안하는 동안, Uzu는 16~32개를 제안해요. 근거는 하드웨어에 있습니다. M5 계열 GPU는 정수 8비트(int8) 연산에서 산술 처리량이 최고조에 도달하는데, 제안 수를 충분히 늘려야 이 계산 유닛을 빈틈 없이 채울 수 있어요. 작은 제안 몇 개로는 유닛을 가동할 만한 매트릭스가 나오지 않기 때문입니다.
다음으로 제안을 ’사슬’이 아니라 ’나무’로 만듭니다. 한 갈래 사슬은 길어질수록 정답률이 지수적으로 떨어지기 때문에, Uzu는 트리 기반 제안으로 갈라 놓아요. 작은 트랜스포머(DFlash-Weaver)가 병렬로 돌아가는 드래프터(DFlash)의 상위 예측을 엮어 일관된 후속 가지를 만들어 주는데, 확신이 높은 과제(에이전트 코딩)에서는 긴 사슬을, 어려운 과제(창작 글쓰기)에서는 넓은 가지를 쓰는 적응형 구성입니다.
세 번째는 되돌리기 없는 검증이에요. 스페큘러티브 디코딩에서 관리가 번거로운 지점은 검증이 틀렸을 때 계산 상태를 안전하게 되돌리는(rollback) 일입니다. Uzu는 트리의 각 지점에서 QKV(어텐션의 쿼리·키·값 벡터)만 캐시해 두고, 승인 경로가 확정된 다음 패스에서 상태 갱신을 미뤄 두는 방식으로 이 비용을 제거했어요. Qwen3.6처럼 게이트드 델타넷(Gated DeltaNet, 게이트를 붙인 순환형 레이어)을 섞은 하이브리드 구조도 순회 계산 없이 한 패스에 처리하는 전용 Metal 커널을 곁들였습니다.
마지막으로 Uzu는 Gumbel 커플링이라는 수학적 장치로 검증을 진행하고요, 이론상 최적 수준의 채택률은 일부러 내려놓는 대신 많이 뽑은 후 휴리스틱으로 가지를 잘라서 트리 품질을 유지해요.
숫자로 확인
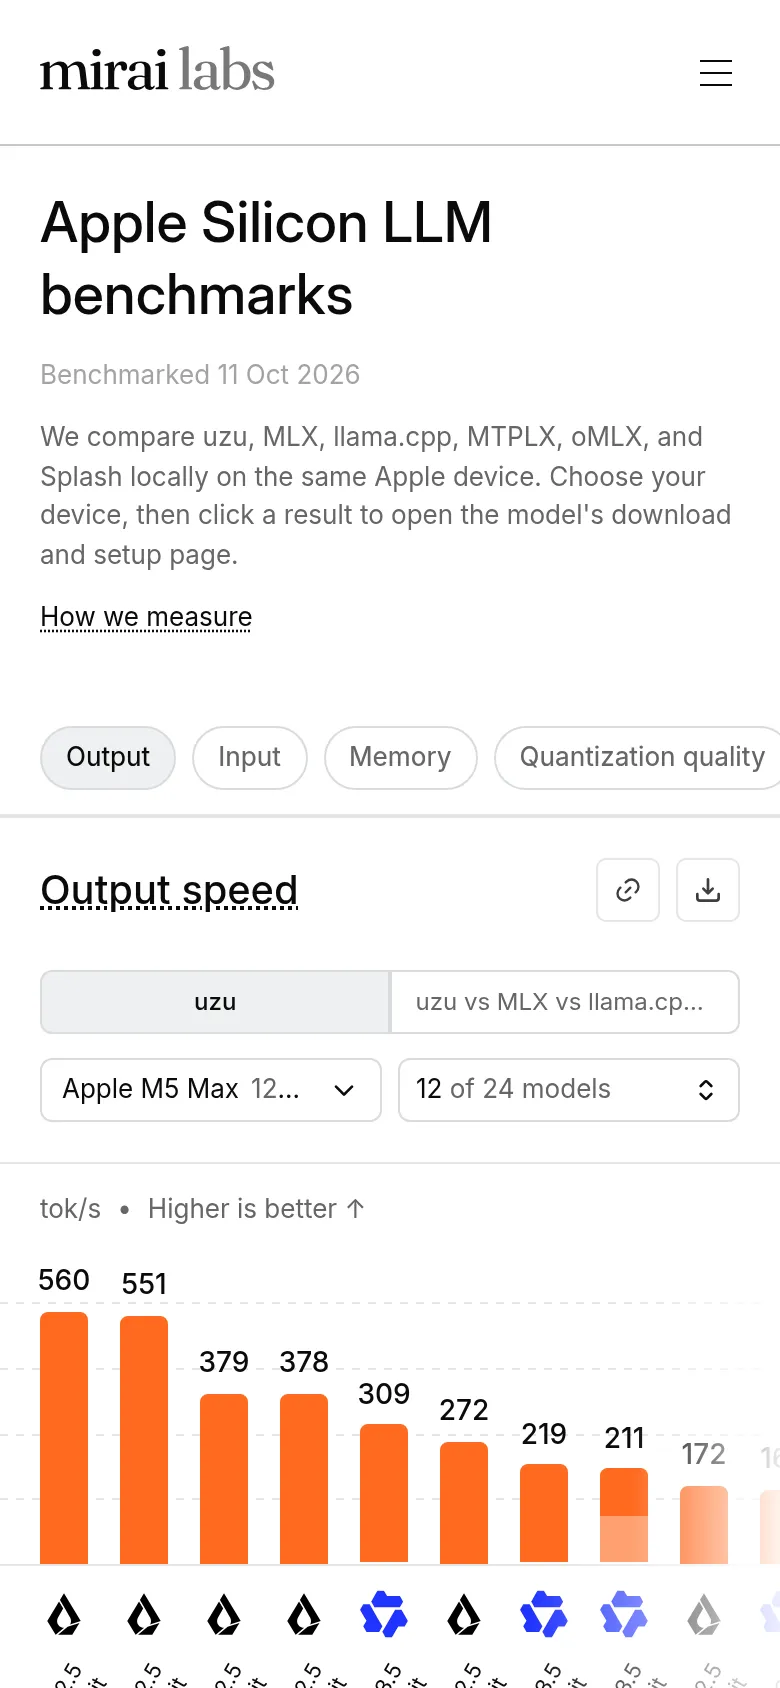
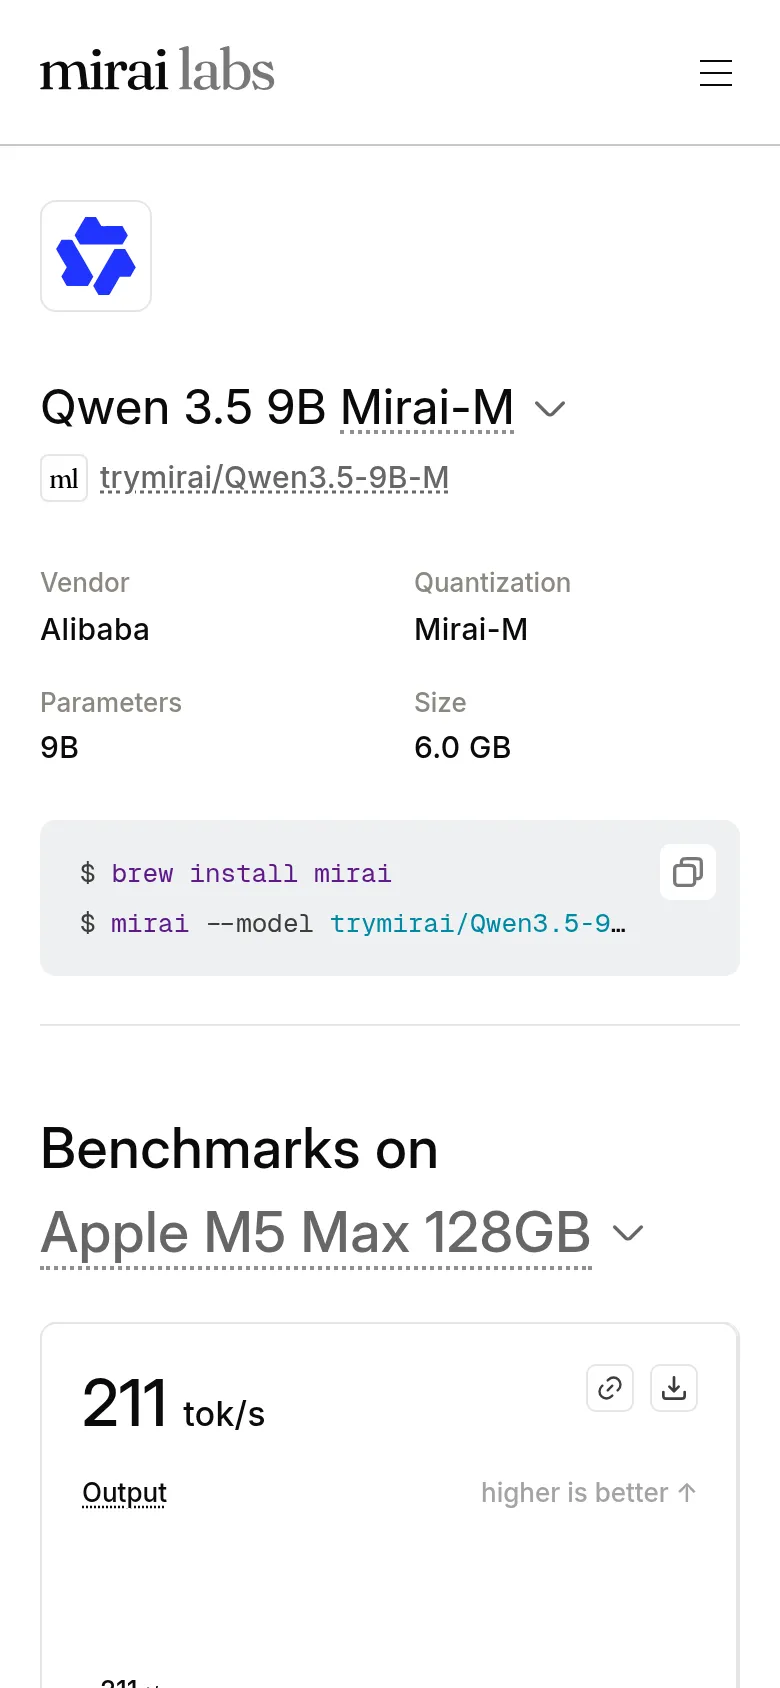
공식 벤치마크 페이지(10월 11일 측정)에서 Qwen3.5 9B 모델 페이지의 Mirai-M 체크포인트(4비트, 6.0GB)를 기준으로 정리하면 아래와 같아요. 같은 기기(Apple M5 Max 128GB)에서 여섯 엔진을 겨룬 결과입니다.
| 엔진 (모드) | 출력 (토큰/초) |
|---|---|
| Uzu + 스페큘러티브 디코딩 | 211 |
| MTPLX | 125 |
| llama.cpp (스페큘러티브 디코딩) | 100 |
| oMLX | 86 |
중요한 건 자동재귀 모드의 Uzu가 아니라 Uzu + 스페큘러티브 디코딩 조합이라는 점이에요. 같은 페이지에서 llama.cpp도 스페큘러티브 디코딩으로 돌렸을 때 100토큰이었으니, 방식을 같게 했을 때의 격차는 2.1배입니다. 스페큘러티브 디코딩 자체는 llama.cpp에도 있고, 그 값과의 차이가 ’설계 격차’라고 볼 수 있어요.
다른 지표도 함께 확인해요. 입력 처리(프롬프트 소화)는 Uzu가 초당 3,244토큰으로 1위, 차순위 MTPLX(2,721)를 앞섭니다. 상주 메모리는 Uzu 6.18GB, llama.cpp 8.26GB로 모델 파일(6GB)보다 약간 큰 Uzu 쪽이 더 적게 먹어요. 같은 조건의 8비트 체크포인트(Mirai-L, 10.0GB)는 초당 160토큰입니다.
측정 조건도 엄격한 편이에요. 약 1,357토큰의 동일 프롬프트를 세 번 반복해 평균을 내고, 측정 사이마다 칩 온도가 60도 미만으로 내려올 때까지 기다립니다. 스페큘러티브 디코딩 점수는 MT-Bench(대화)·MATH-500(수학)·HumanEval(코딩) 샘플의 매크로 평균으로, 과제별 편차를 줄이려는 의도가 보여요.
참고로 이 페이지에서는 12개 모델(LFM2.5 계열, Qwen3.5 계열)의 출력·입력 속도 항목을 모두 Uzu가 1위로 가져갔어요. 가장 빠른 항목은 LFM2.5 1.2B Thinking의 초당 560토큰이에요.
직접 써 보는 방법
설치는 brew 한 줄이면 끝납니다. brew 패키지 이름은 엔진 이름(Uzu)과 다른 mirai예요.
brew install mirai
mirai --model trymirai/Qwen3.5-9B-M
앱에 넣는다면 언어별 SDK가 준비돼 있어요. 네이티브 코어는 Rust이고, Swift(SPM 패키지 Uzu 0.6.3), Python, TypeScript 바인딩이 같은 API를 제공합니다. 모델 받기부터 설정까지 SDK가 자동으로 처리하고, 세션(ChatSession)을 재사용하면 모델 재적재 없이 여러 대화를 이어갈 수 있어요. iOS 앱에서는 ‘Increased Memory Capability’ 권한 부여를 공식 문서가 권합니다.
라이선스는 MIT이고, 서버로도 쓸 수 있어요. uzu CLI의 server 명령은 OpenAI 호환 엔드포인트(/v1/chat/completions)를 로컬에서 열어주므로, llama.cpp 서버를 쓰던 파이프라인을 그대로 갈아끼울 수 있습니다. 자기 모델을 변환하려면 같은 팀의 변환기 lalamo로 자체 양자화 포맷(Mirai-M/Mirai-L) 파일을 만들 수 있어요. 재미있는 부분은, 같은 엔진 API에서 클라우드 모델(공식 예시는 gpt-5)까지 접근할 수 있어서 기기 내 모델과 클라우드를 하나의 코드 스타일로 섞을 수 있다는 점이에요.
지금은 맥·아이폰만 정식 지원
리포의 개발 섹션에서 지원 대상을 명시하고 있어요. 정식 지원은 aarch64-apple-darwin과 aarch64-apple-ios 등 Apple 쪽 타깃(맥, 아이폰, 시뮬레이터)이고, 백엔드는 Metal과 CPU 두 가지입니다. Windows·Linux·WebAssembly 타깃은 전부 ‘개발 중(in progress)’ 표기라, 화제 영상에서 “지금은 맥·아이폰만 정식 지원”이라고 말한 것과 정확히 일치해요. 리눅스 서버에서 직접 돌려 보려 했지만 이 제약 때문에 불가능했고, 이 글은 문서와 공개 수치로 검증한 내용입니다.
한계와 눈금
벤치마크 주체가 엔진 개발사 자신이라는 점은 짚고 갈 필요가 있어요. 측정 조건(동일 프롬프트, 3회 평균, 온도 쿨다운, 공개된 평가 데이터셋)은 깔끔하게 문서화돼 있으나, 완전히 독립적인 제3자 재현 수치는 아직 없다는 뜻이기도 합니다.
스페큘러티브 디코딩의 이득은 과제에 따라 달라져요. 공식 설명 자체가 ’코드는 예측이 쉽고, 일반 대화는 어렵다’고 인정합니다. 드래프터가 틀릴수록 검증 패스가 허투루 돌아가며, 드래프터를 위한 작은 모델이 상주 메모리를 더 먹습니다(단, Uzu 측정에서는 llama.cpp 대비 상주 메모리가 더 작게 나왔어요). 그래서 ’무조건 4배’가 아니라 ’배치 1인 로컬 워크로드에서 과제에 따라 큰 이득’으로 읽는 게 안전하고, 기기에 얹는 앱처럼 배치 1 상황에서 이득이 커지는 구조입니다.
지원 모델 목록도 현재는 한정돼 있어요. 10월 기준 LFM2.5·Qwen3.5 등 12개 모델이고, 스페큘러티브 디코딩은 공식 발표 기준 Qwen3.6 27B부터 시작해 범위를 넓히는 중입니다. 모델 지원 확장이 앞으로의 성패를 가른다고 봐야 해요.
그래서 어떻게 활용하나
로컬 LLM 앱을 만드는 개발자에게 Uzu는 지금 시점의 선택지가 명확해요. Swift SPM 의존성으로 앱 안에 추론 코어를 넣거나, OpenAI 호환 로컬 서버로 기존 llama.cpp 파이프라인을 그대로 교체해 보는 두 길이 가장 현실적입니다. 에이전트처럼 토큰 수요가 많은 워크로드일수록 스페큘러티브 디코딩의 이득이 커진다는 점에서, 코드 생성·도구 호출을 기기에서 돌리는 설계에 특히 어울려요.
파워유저 관점의 활용은 간단합니다. M5 계열 맥을 쓴다면 brew install mirai로 설치하고 같은 모델을 llama.cpp와 나란히 돌려 보세요. 초당 토큰 차이가 체감상 ’응답이 밀리는 앱’과 ’따라오는 앱’의 차이로 직결됩니다. 속도의 천장이 CPU 성능이 아니라 메모리였다는 사실이 이 글의 가장 실질적인 교훈이고, 방식을 바꾸면 같은 칩에서 4배의 여력이 나온다는 것도 함께요.
출처
- trymirai/uzu 리포(README·빌드·서버·라이선스): https://github.com/trymirai/uzu
- Speculative decoding in uzu (Mirai Labs 블로그, 2026-09-03): https://trymirai.com/blog/speculative-decoding-in-uzu
- Apple Silicon LLM benchmarks (10월 11일 측정): https://trymirai.com/metrics
- Qwen 3.5 9B Checkpoint: Mirai-M 모델 페이지: https://trymirai.com/local-models/alibaba-qwen3-5-9b-mirai-mirai-m-4
- Apple MacBook Pro (14-inch, M5) 기술 사양(153GB/s 메모리 대역폭): https://support.apple.com/en-us/125405
- 원본 릴스(계기 영상): https://www.instagram.com/p/DebwmVBigRY/