[기술 딥다이브] UTF-8이 웹의 99%인 이유
한 줄 요약: UTF-8은 ASCII 호환·가변 길이(1~4바이트)·자기 동기화라는 세 가지 설계 덕분에 기존 시스템을 깨지 않고 전 세계 문자를 담아 웹의 99% 표준이 됐다.
2026년 기준 전 세계 웹페이지의 99%가 UTF-8을 사용해요. 왜 하필 UTF-8일까요? 인코딩 선택은 취향이 아니라 호환성, 공간, 안전성의 종합 점수예요. 한글 ’가’가 실제로 몇 바이트가 되는지 직접 인코딩해 가며 풀어 설명하겠어요.
ASCII 호환: 가장 큰 장점
UTF-8의 가장 중요한 설계 목표는 ASCII와의 완벽한 호환이었어요. ASCII 문자(영문 알파벳, 숫자, 기호)는 UTF-8에서도 1바이트로 동일하게 인코딩돼요. 즉, 기존 ASCII 소프트웨어는 UTF-8 텍스트도 그대로 처리할 수 있어요. 이 ‘기존 시스템에 거슬리지 않는’ 설계가 도입의 가장 큰 장벽을 낮췄어요. 웹페이지의 골격인 HTML 태그, 속성, JavaScript 문법이 전부 ASCII라는 점에서, 이 호환성은 곧 웹 전체의 전환 비용을 낮춘 의미예요.
가변 길이: 1~4바이트, 문자에 따라 다르다
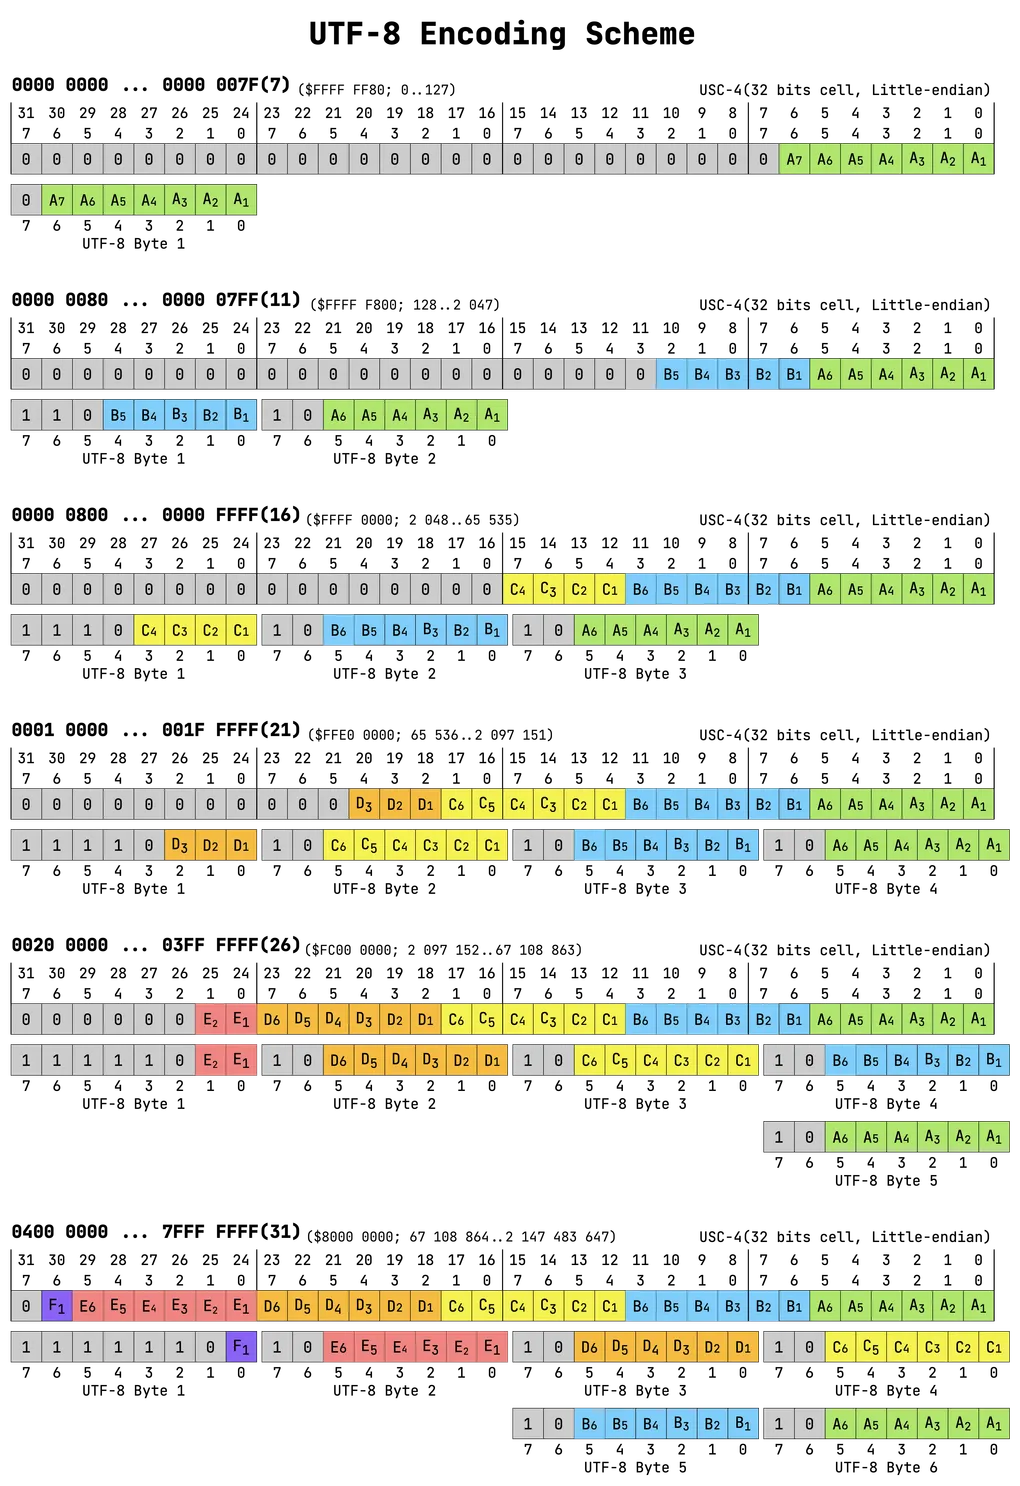
UTF-8은 가변 길이 인코딩이에요. 문자의 코드 포인트(번호)에 따라 바이트 수가 달라져요.
| 범위 | 바이트 수 | 예시 |
|---|---|---|
| U+0000~U+007F | 1바이트 | 영문 알파벳(A = 0x41) |
| U+0080~U+07FF | 2바이트 | 라틴 확장, 그리스, 키릴 |
| U+0800~U+FFFF | 3바이트 | 한글, 한자, 일본어 |
| U+10000~U+10FFFF | 4바이트 | 이모지, 고대 문자 |
한글 ’가’는 실제로 몇 바이트인가
파이썬으로 ‘A’, ‘가’, ’😀’를 UTF-8로 인코딩한 실제 출력이에요:
'A'    U+0041  1바이트  41
'가'    U+AC00  3바이트  ea b0 80
'😀'   U+1F600 4바이트  f0 9f 98 80
한글은 3바이트, 이모지는 4바이트예요. 그런데 ea b0 80이라는 세 바이트가 어떻게 ’가’가 되는 걸까요? 여기서 바이트 패턴의 설계가 드러나요.
바이트 패턴: 앞부분이 길이를 알려준다
UTF-8 바이트의 첫 비트를 보면 이 바이트가 문자의 시작인지 연속인지 판별돼요.
0xxxxxxx: 1바이트 문자 (ASCII)110xxxxx: 2바이트 문자의 시작1110xxxx: 3바이트 문자의 시작11110xxx: 4바이트 문자의 시작10xxxxxx: 연속 바이트(continuation byte)
‘가’(U+AC00)가 3바이트로 인코딩되는 과정을 도식으로 보겠어요. 코드포인트 16비트를 4+6+6으로 쪼개어 템플릿의 빈칸에 끼워 넣는 방식이에요.
이 구조 덕분에 자기 동기화(self-synchronizing)가 가능해요. 데이터 스트림의 중간부터 읽기 시작해도 10으로 시작하는 바이트는 건너뛰고 다음 문자의 시작(0 또는 11로 시작하는 바이트)을 찾을 수 있어요. 손상된 바이트를 건너뛰고 복구할 수 있다는 의미예요. 파일 일부가 손상되어도 화면에 물음표 모양의 대체 문자(replacement character)가 한두 개만 나타나고 문서 전체가 깨지지 않는 이유가 이 설계 덕분이에요.
공간 효율: 영어는 1바이트, 한글은 3바이트
영어 텍스트는 ASCII와 동일하게 문자당 1바이트로 UTF-8이 가장 효율적이에요. 한글은 3바이트로 UTF-16(2바이트)보다 어요. 하지만 웹페이지의 대부분은 HTML 태그, 코드, 영어 단어가 혼합되어 있어 전체 용량에서 ASCII 비율이 크게 작용해요. 이 블로그 글 하나를 예로 들면, HTML 마크업과 영문 기술 용어가 1바이트로 처리되기 때문에 한글이 3바이트인 부담을 상쇄해요.
왜 UTF-16이 아닌가: 엔디안 문제와 비호환
UTF-16은 CJK 문자에 2바이트로 공간 효율이 좋아요. 그러나 두 가지 문제가 있어요:
- 엔디안(endianness): 같은 UTF-16이라도 바이트를 앞부터 쓰느냐 뒤부터 쓰느냐가 시스템마다 달라요. 그래서 파일 앞에 BOM(바이트 순서 표시)을 붙여 순서를 알려야 해요. UTF-8은 바이트 단위 설계라 순서 문제 자체가 없어요.
- ASCII 비호환: 영문도 2바이트가 되어 기존 ASCII 기반 소프트웨어와 호환되지 않아요. C 언어의
char문자열 처리, 오래된 프로토콜의 구분자 등이 전부 깨져요.
‘CJK에 더 작은’ UTF-16보다 ‘기존 세계에 거슬리지 않는’ UTF-8이 이긴 것이에요.
어떻게 연결되는가
한 줄로 요약하면: ASCII 호환, 가변 길이, 자기 동기화의 세 가지 설계가 결합하여 기존 시스템을 깨지 않으면서 전 세계 문자를 담은 것이 UTF-8예요. ‘가장 우수한’ 것이 아니라 ‘가장 거슬리지 않는’ 것이 승리한 사례예요. 이 인코딩은 웹의 모든 텍스트에 적용되며, 예컨대 로그인 토큰인 JWT의 JSON 페이로드도 UTF-8 바이트를 base64로 감싼 것이에요. 그 구조는 JWT 글에서 이어져요.
출처: RFC 3629: UTF-8 · 위키백과: UTF-8
이미지: Callidus, Wikimedia Commons (CC-BY-SA 3.0) — 원본
