4GB 노트북에서 8B 학습, 산수로 보기
한 줄 요약: Soup은 층 스트리밍으로 고정된 베이스를 VRAM 밖에 두고 한 층씩 올려 LoRA 학습을 돌려요. 8B 모델을 4GB 노트북 GPU에서 학습하는 건 사실이고, 대신 베이스를 단계마다 두 번 읽어야 하는 물리적 비용이 붙어요. 그 비용을 계산해 봤어요.
책상 위를 정리하는 방법을 떠올려 보세요. 책 전부를 책상에 올릴 수 없다면, 필요한 책 한 권만 올려서 읽고 내려놓는 식으로 일할 수 있어요. Soup의 층 스트리밍이 정확히 그 방식이에요.
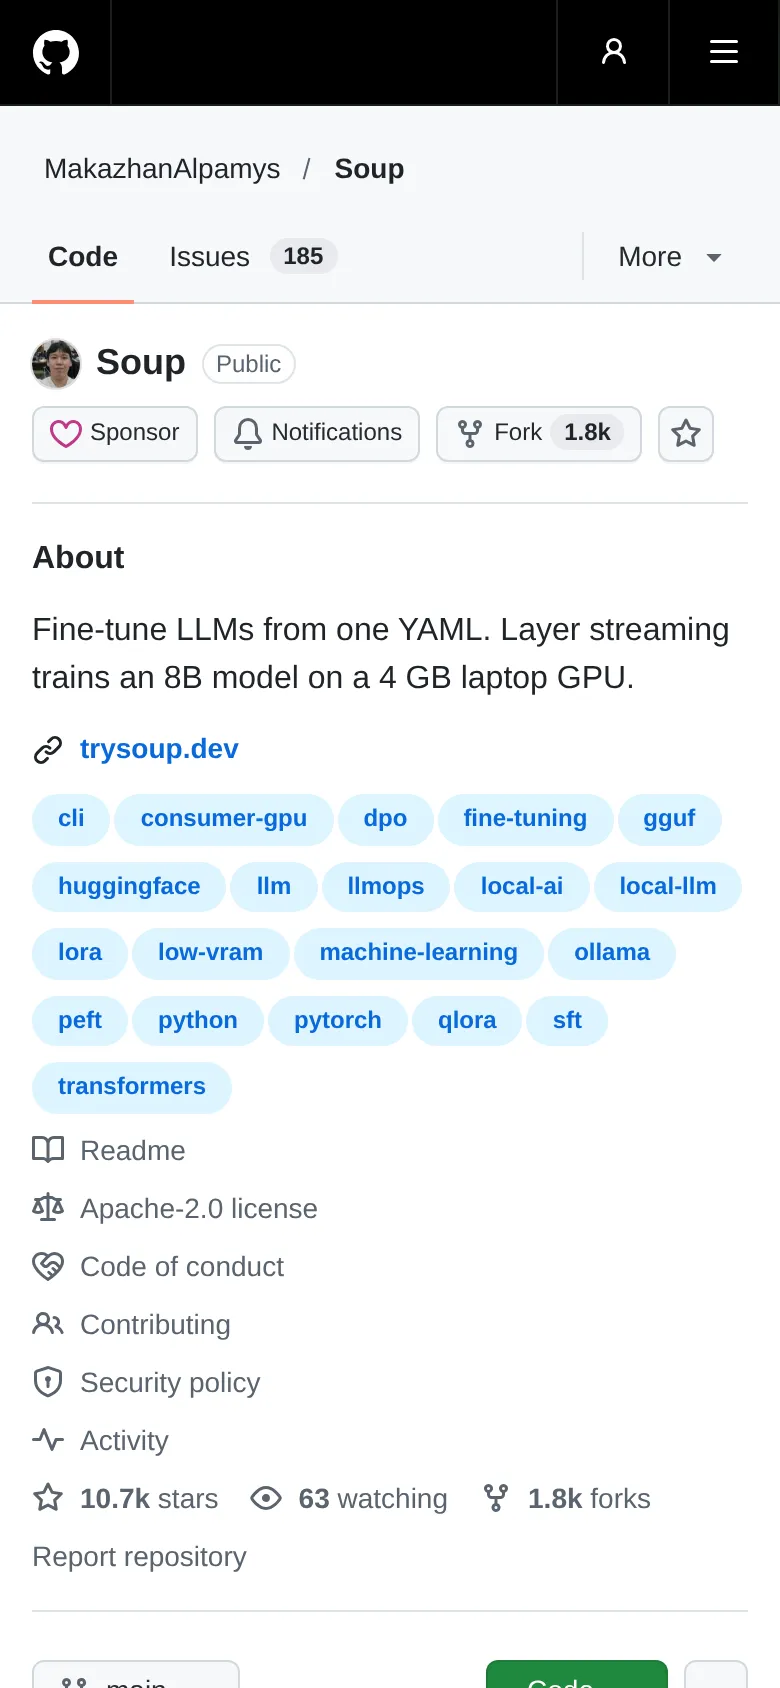
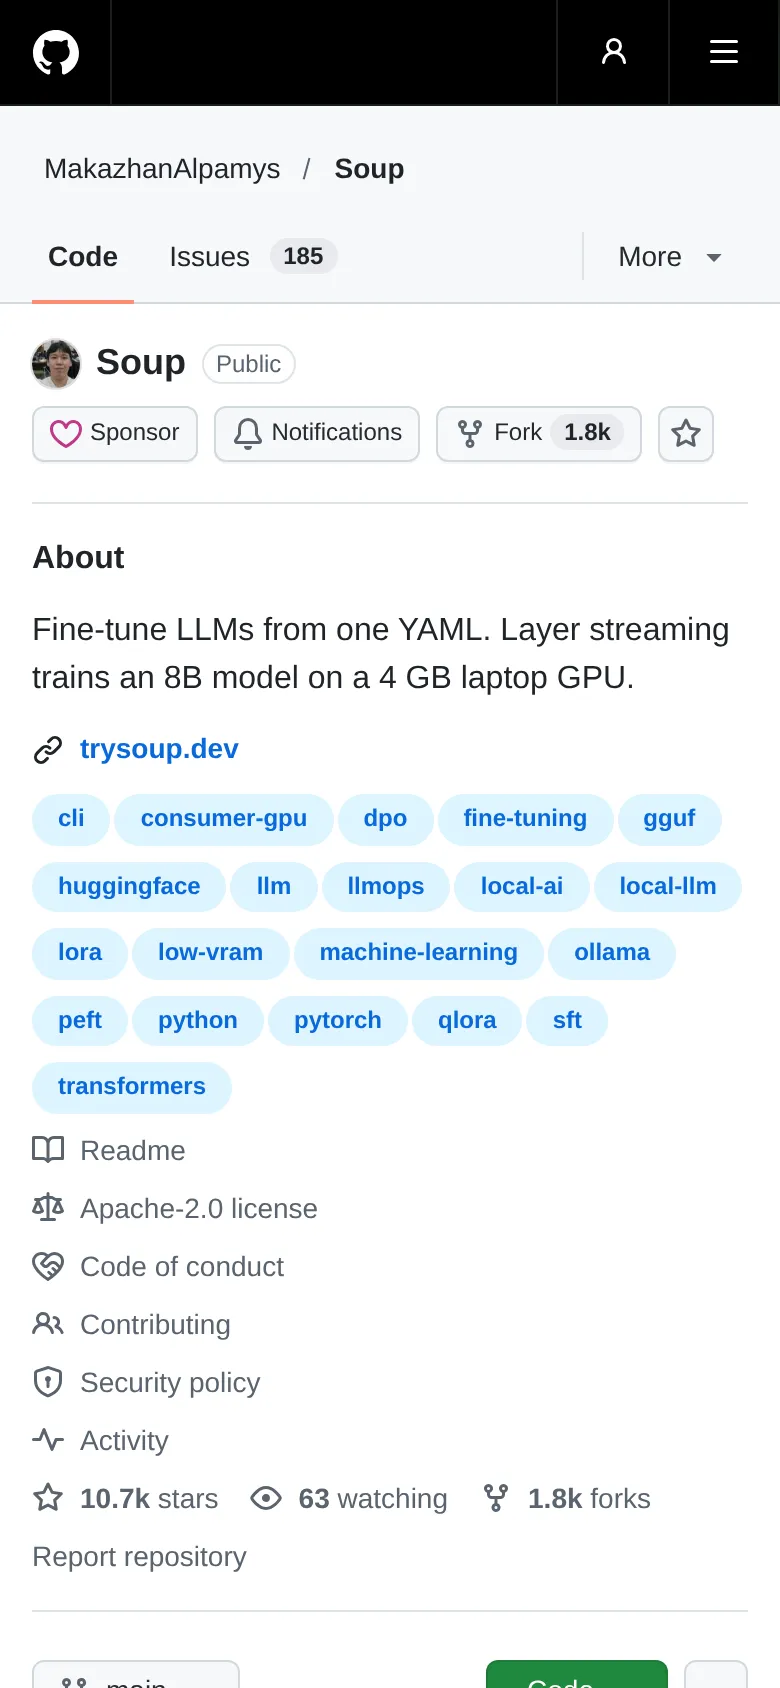
파인튜닝을 해 보고 싶어도 GPU가 없어서 멈추는 경우가 많아요. 8B 모델을 16비트로 올리면 가중치만 16GB니까요. Soup은 이 벽을 층 스트리밍(layer streaming) 으로 넘어가요. README에 적힌 수치를 직접 검산하고, 숨은 비용까지 계산해 봤어요.
먼저 용어 세 개만 풀게요.
- LoRA: 원본 가중치는 건드리지 않고 작은 보조 행렬만 학습하는 방식이에요. 학습 대상이 1% 안쪽이라 메모리가 적게 들어요.
- NF4: 가중치를 4비트로 담는 양자화 형식이에요. 16비트보다 4분의 1로 줄어요.
- 층(layer): 모델을 이루는 계산 블록이에요. 8B 모델이면 보통 32개 층이에요.
어떻게 4GB에 들어가나
구조는 이래요. LoRA 어댑터와 그 기울기, 옵티마이저 상태는 VRAM에 상주해요. 작거든요. 고정된 베이스는 CPU RAM(페이지 고정) 에 두고, 디코더 층을 하나씩 VRAM 버퍼로 복사해서 계산해요. 버퍼는 두 개를 번갈아 쓰면서 이전 층 계산과 다음 층 복사를 겹쳐요.
README의 실측은 이래요. RTX 3050 Laptop 4GB에서 Llama-3.1-8B + NF4를 LoRA로 학습했을 때 3.32GB 피크, 초당 119.6토큰이에요(v0.72.2 기준). H100에서도 같은 3.32GB로 초당 113.0토큰이 나왔다고 해요. 같은 메모리 상한이 다른 GPU에서도 유지된다는 뜻이죠.
메모리 산수를 확인해 볼게요. README는 베이스 저장소가 3.60GB, VRAM 버퍼가 113MB 두 개라고 적어요. 8.03B 파라미터를 3.60GB에 담았다면 3.60GB × 8 ÷ 8.03B = **3.59비트/파라미터**예요. NF4가 이중 양자화까지 쓰면 이 범위에 들어와요. 16비트 원본(16GB) 대비 4.4배 축소된 셈이에요.
숨은 비용 — 왜 층을 두 번 읽나
여기가 이 구조의 급소예요. README도 이 대목을 숨기지 않아요.
각 디코더 층은 단계마다 두 번 읽혀요 — 순전파에서 한 번, 역전파가 그 층을 다시 계산할 때 한 번.
dL/dx = Wᵀ · dL/dy때문에 아래 층으로 기울기를 넘기려면 가중치가 필요하기 때문이에요. 이건 구현 세부가 아니라 물리예요.
즉 층 스트리밍 학습은 VRAM을 아끼는 대신 메모리 대역폭을 씁니다. 책을 두 번 올렸다 내리는 셈이에요. 이 비용을 계산해 봤어요.
| 항목 | 값 |
|---|---|
| 단계당 베이스 읽기 | 3.60GB × 2 = 7.2GB |
| 노트북 PCIe 실효 대역폭(가정) | 약 12GB/s |
| 전송 시간 | 약 0.6초 |
| 단계 시간(512토큰 ÷ 119.6 tok/s) | 약 4.28초 |
| 오버헤드 비율 | 약 14% |
이 14%는 README가 다른 대목에서 밝힌 수치와 정확히 맞아요. v0.73.0 정확성 수정 이후 “클럭당 약 14% 느려졌다“고 적어요. 즉 층 스트리밍의 비용은 PCIe 대역폭으로 설명되고, 그 크기는 10%대예요. 무섭게 느려지는 게 아니라, 감당 가능한 세금이에요.
정직한 숫자 비교 — 클럭을 봐야 한다
README에서 가장 신뢰가 가는 부분은 자기 숫자를 깎아 내는 대목이에요.
- v0.72.2에서 4GB 노트북: 119.6 tok/s, 3.32GB (952MHz)
- v0.73.0 정확성 수정 후 다른 사용자 측정: 208.6 tok/s, 2.40GB (1935~1957MHz)
숫자만 보면 1.74배 빨라졌어요. 그런데 README는 이렇게 정정해요. “이는 같은 세션 GEMM 상한의 59%로, 수정 전 68%에 못 미친다. 클럭당 약 14% 느려진 것이고, 원시 1.74배는 클럭에서 나온 것이지 속도 향상이 아니다.”
같은 GPU인데 클럭이 두 배 차이 나면 토큰 속도도 두 배 차이 나요. 벤치마크를 비교할 때 클럭과 메모리 조건을 안 보면 없는 개선을 보게 된다는 걸 스스로 증명한 셈이에요.
학습에 실제로 걸리는 시간
속도가 나왔으니 실제 시간을 계산해 봤어요. 119.6 tok/s 기준이에요.
| 학습 토큰 수 | 예상 시간 |
|---|---|
| 100만 | 약 2.3시간 |
| 1,000만 | 약 23시간 |
| 1억 | 약 232시간 (약 10일) |
208.6 tok/s 기준이면 100만 토큰 1.3시간, 1,000만 토큰 13시간이에요. 여기서 실무 감각이 나와요. 노트북 4GB로는 “작은 데이터셋 한 번 돌려 보기”까지가 현실적이에요. 1,000만 토큰 규모는 밤새 걸어 두는 계획이 필요하고, 1억 토큰은 임대 GPU를 보는 게 맞아요.
참고로 이 속도는 학습 처리량(tok/s) 이에요. 추론 속도와 같은 단위지만 의미가 달라요. 같은 숫자를 보고 “이 모델이 초당 120토큰으로 답한다”고 오해하면 안 돼요.
MoE는 한 단계 더 나아간다
Soup에는 전문가 단위 스트리밍도 있어요(stream_expert_layout: per_expert, DeepSeek-V3 계열). MoE 층의 전문가를 각각 파일로 쪼개 두고, 라우터가 고른 전문가만 읽어요. 그러면 VRAM 상한이 전문가 수에 따라 늘지 않아요.
README가 밝힌 실측은 이래요. Moonlight-16B에서 단계당 피크가 3,993MiB → 1,882MiB로 줄었고, 대신 단계 시간이 8.9~9.8초 → 17.5~18.0초가 됐어요. 메모리를 절반으로 줄인 대가로 시간이 두 배가 된 거래예요. 앞서 AirLLM 글에서 정리한 “읽는 바이트와 속도의 교환”이 학습에서도 그대로 나와요.
쓸 때 확인할 것
- 층 스트리밍은 기본값이 아니에요 —
training.stream_layers: true를 직접 켜야 하고, 아직 BETA예요. - 수치는 제작자 측정이에요 — README도 “직접 확인하라”는 뜻으로 무료 Colab T4 노트북을 제공해요. 4GB로 제한하고 스트리밍 결과가 일반 실행과 비트 단위로 동일한지 검증해요.
- LlamaFactory 설정을 옮길 수 있어요 —
soup migrate --from llamafactory,--dry-run으로 미리 볼 수 있어요. - RAM이 필요해요 — 베이스 3.60GB가 CPU RAM에 상주해야 해요. VRAM만 보고 노트북을 고르면 안 돼요.
- 라이선스는 Apache-2.0 — 도구는 자유롭게 쓸 수 있지만, 학습하는 모델의 라이선스는 따로 확인해야 해요.
정리
“4GB에서 8B 학습”은 가능해요. 원리는 고정된 베이스를 VRAM 밖으로 밀어내고, LoRA만 상주시키는 것이고, 대가는 단계마다 베이스를 두 번 읽는 대역폭 세금이에요.
이 프로젝트가 신뢰를 얻은 이유는 숫자가 커서가 아니라, 자기 숫자가 왜 그렇게 나왔는지 클럭까지 밝혔기 때문이라고 생각해요. 집에 있는 GPU로 파인튜닝을 시작하려는 사람에게 지금 가장 현실적인 입구예요.
- 프로젝트: github.com/MakazhanAlpamys/Soup (Apache-2.0, 별 1.07만)
- 패키지: pypi.org/project/soup-cli (v0.78.0)
- 층 스트리밍 문서: docs/performance-and-quantization.md
- 검증 노트북: proof-4gb.ipynb