폰에서 도는 1B AI 에이전트 모델, MiniCPM5
한 줄 요약: OpenBMB의 MiniCPM5-1B는 1B 크기 AI 모델이면서 128K 컨텍스트와 툴 콜링(기능 호출)을 기본으로 갖춰, 클라우드 없이 폰·노트북에서 에이전트를 돌릴 수 있게 해주는 오픈소스 모델이에요.
최근 SNS에서 ’반 기가바이트짜리 AI 모델이 폰에서 에이전트를 돌린다’는 소식이 화제였어요. 대상은 OpenBMB의 MiniCPM5였고, 짧은 영상만으로는 확인할 수 없는 부분이 많아 공식 리포와 모델 카드 기준으로 새로 정리했어요.
확인: 릴스 화면의 벤치마크 표와 폰 화면은 연출 목업이었어요. 다만 강조된 수치(평균 42.57 대 35.61)는 OpenBMB 공식 평가표와 일치했고, ’반 기가바이트’는 4비트 파일 기준 0.6GB대로 대략 맞아요. 직접 확인해 본 결과 뼈대는 정확했어요.
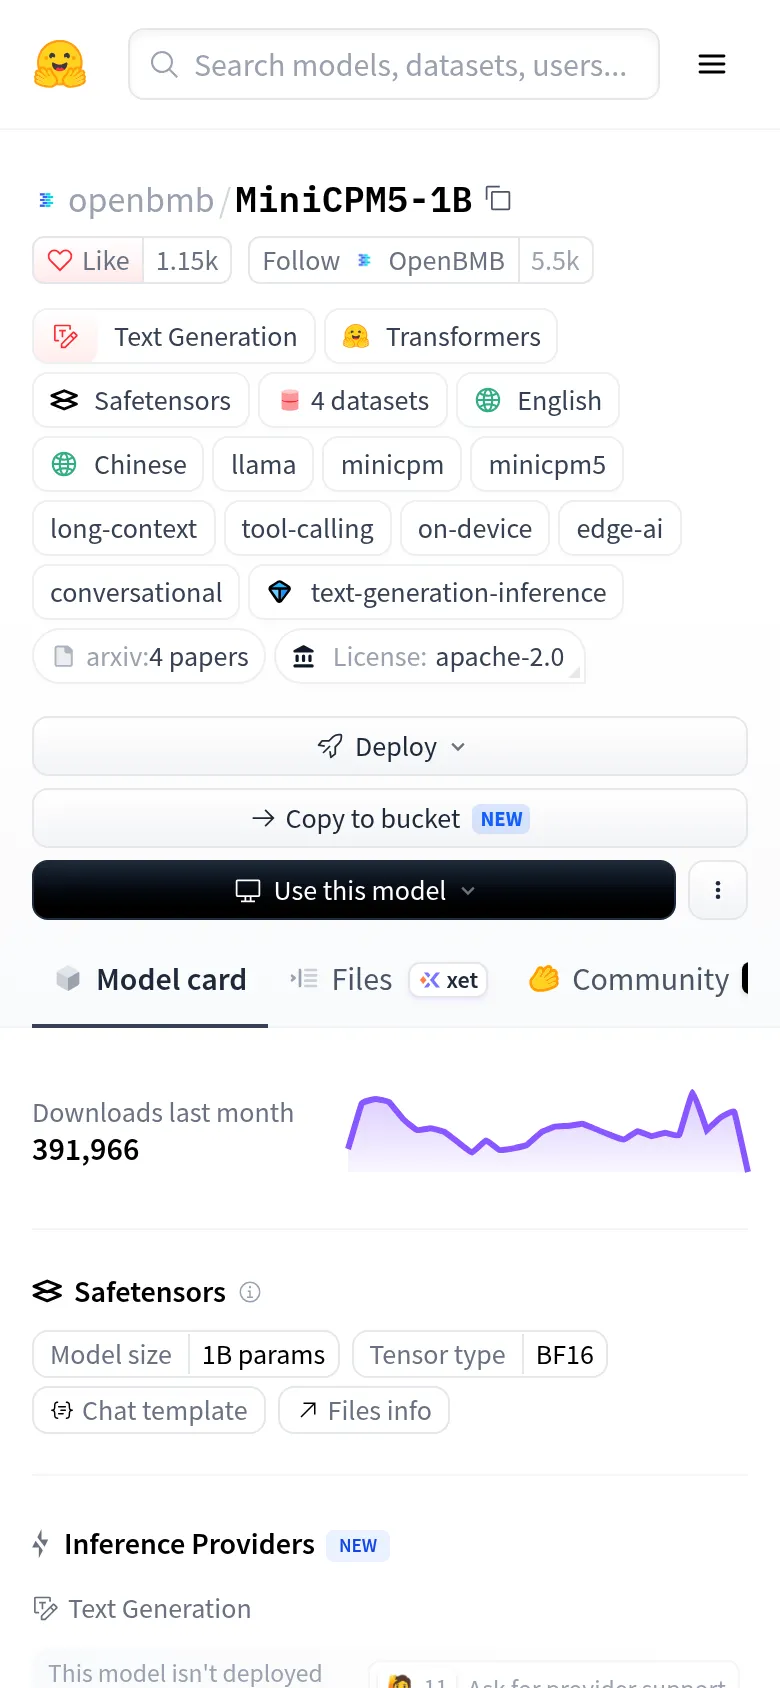
Hugging Face 모델 카드 기준 한 달 다운로드는 약 39만 회(2026-10-08 캡처)이고, 라이선스는 상업 이용이 허용된 Apache-2.0이에요.
MiniCPM5는 어떤 모델이에요
MiniCPM5는 베이징의 AI 스타트업 Modelbest(면벽지능)와 칭화대학교 NLP 연구실(THUNLP)이 함께 만드는 소형 온디바이스 모델 시리즈의 5세대예요. 2026년 5월에 1B 모델이 먼저 나왔고, 같은 해 9월에 2B 모델이 이어서 나왔어요. 온디바이스(on-device)는 서버가 아니라 폰이나 노트북 같은 내 기기 안에서 모델이 직접 도는 방식을 말해요.
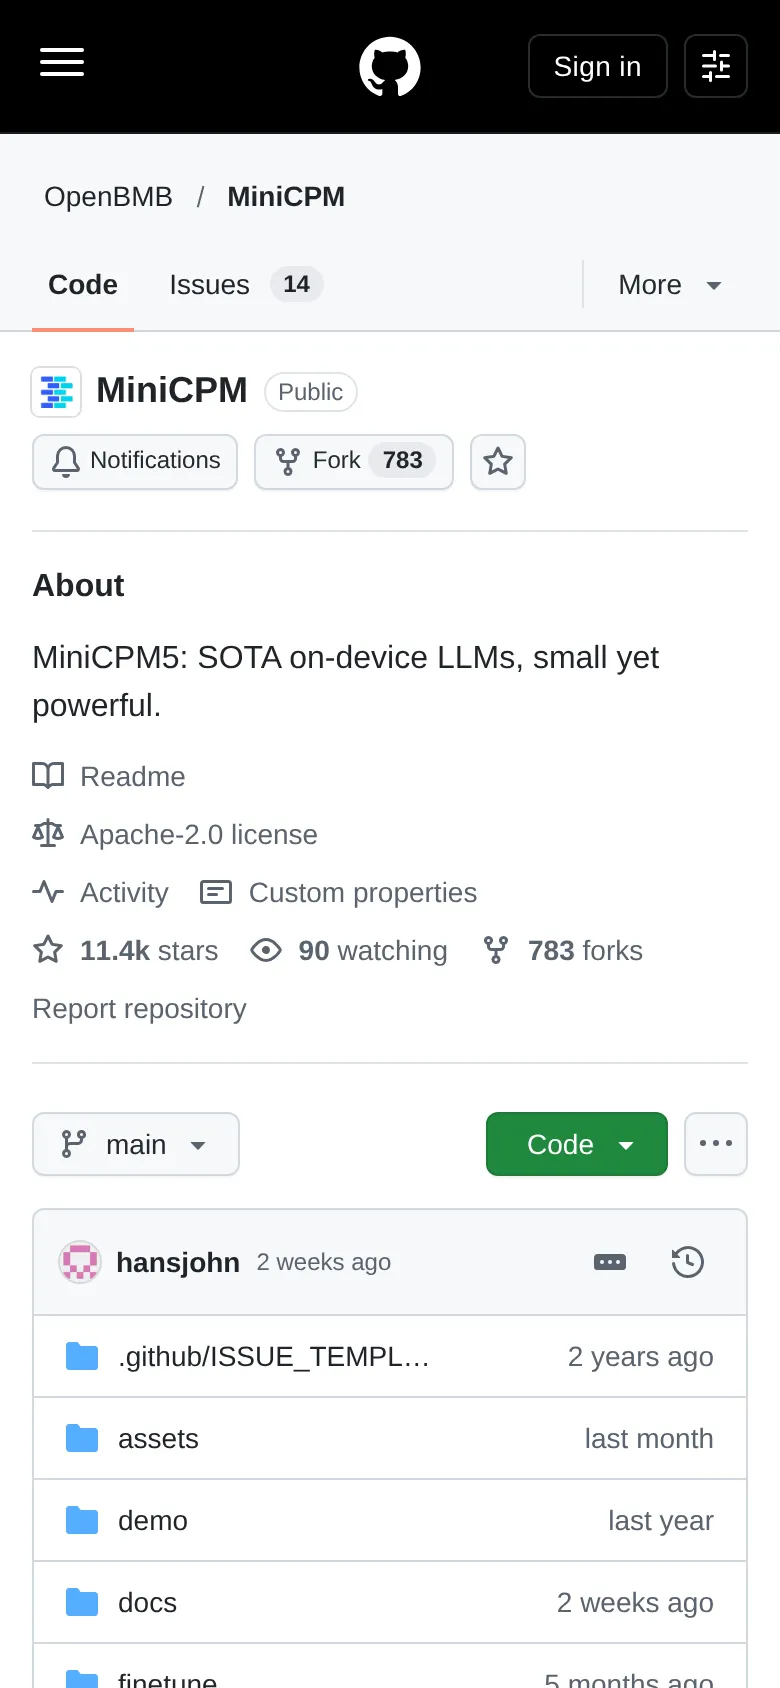
GitHub 리포의 소개 문구는 “MiniCPM5: SOTA on-device LLMs, small yet powerful”이에요. 스펙은 표로 정리하는 게 빠르니 같이 볼게요.
| 항목 | 값 |
|---|---|
| 파라미터 수 | 1,080,632,832개(약 1.08B) |
| 아키텍처 | 표준 LlamaForCausalLM |
| 레이어 수 | 24개 |
| 어텐션 | GQA(Q 16개 / KV 2개) |
| 컨텍스트 길이 | 131,072(128K) 토큰 |
| 라이선스 | Apache-2.0 |
이 표에서 가장 실용적인 항목은 아키텍처이고, 병행해서 알면 좋은 구조는 GQA예요. GQA는 KV 캐시(자주 쓰는 단어집)의 보관량을 아껴 쓰는 어텐션 배치라 작은 기기의 메모리 부담을 줄여 줘요. 모델 구조가 Llama 계열 표준이라 주요 추론 엔진이 커스텀 코드 없이 바로 로드할 수 있고, 이 덕분에 뒤에서 소개할 아홉 갈래 실행 경로가 모두 열려 있어요.
추론 모드도 한 가지가 아니에요. 챗 템플릿에 enable_thinking 스위치가 내장돼 있어서, 같은 체크포인트가 짧게 답하는 모드와 곰곰 고민한 뒤 답하는 모드를 전환하며 써요. 이런 방식을 하이브리드 추론이라고 부르고, 모드에 따라 권장 온도 같은 생성 옵션도 달라져요.
평균 42.57, 1B급 비교에서 앞서는 점수
OpenBMB가 공개한 평가 결과에서 MiniCPM5-1B는 같은 1B급 모델들 사이 평균 42.57점을 기록했어요. 이 평균은 모델이 곰곰 고민하는 모드(Thinking)를 켠 기준이에요. 비교 세트에서 가장 강한 경쟁 모델인 LFM2.5-1.2B-Thinking은 35.61점이라 평균 기준 약 7점 차예요.
세부 항목을 보면 강한 영역이 뚜렷해요. 에이전트가 도구(계산기·검색·파일 읽기 같은 기능)를 다루는 능력을 재는 τ²-Bench Telecom-AA에서는 79.53점을 기록해, 경쟁 모델들(21.10점에서 47.70점 사이)을 크게 앞섰어요. 수학 경시 대회 풀이를 재는 AIME-2025·2026에서는 두 번 모두 40.42점을 기록했고, 코딩 벤치마크의 쉬운 난이도 구간(LCB-Pro Easy)에서는 경쟁 모델들이 0점에서 6점 사이에 머무는 동안 22.68점을 냈어요.
좋은 점만 보면 안 되니 약한 영역도 짚을게요. 어려운 지식 문제(GPQA-Diamond: 26.26점 vs LFM2.5의 34.85점)와 다국어 지시 이행(Multi-IF: 43.54점 vs 55.61점), 대표 지시 이행 벤치마크 IFEval(80.41점 vs 84.84점)은 경쟁 모델이 앞서요. 또 이 수치는 ’공식 비교 세트 안에서의 SOTA(최고 성적)’이지, 세트 밖 모델까지 포함한 세계 1위라는 뜻은 아니에요.
2B 모델은 4B급 상대까지 앞서요
2B 모델(MiniCPM5-2B)은 비교 세트 평균 53.9점으로, 같은 2B급 경쟁 모델들(33.2, 28.0, 24.6점)을 넘고 비교표에 같이 놓인 4B급 모델의 최고점 51.1점보다도 앞서요. 실제 GitHub 이슈를 고치는 능력을 재는 SWE-bench Verified에서는 46.4점을 기록했어요.
후행 학습(post-training) 방식도 눈에 띄어요. 과목별 ’선생 모델’에게 지도받은 실력을 한 모델에 압축해 넣는 증류 기법(OPD, On-Policy Distillation)으로 마쳤어요.
128K 컨텍스트와 툴 콜링, 에이전트의 재료
첫 번째 재료는 128K 컨텍스트(131,072토큰)예요. 영어 기준 약 9만 6천 단어 규모라 소설 한 권을 작업대에 통째로 올려 둘 만해요(컨텍스트는 모델이 한 번에 참조할 수 있는 공간의 크기예요). 긴 문서를 폰에서 통째로 넣고 요약하는 작업도 스펙상 가능해요.
두 번째 재료는 툴 콜링이에요. 툴 콜링은 모델이 대답만 하는 게 아니라 필요한 순간에 외부 기능을 함수 형태로 호출하는 기능이에요. 모델 카드에 따르면 MiniCPM5-1B는 툴 콜 규격이 챗 템플릿에 내장돼 있어 XML 방식으로 곧바로 출력하고, SGLang의 내장 파서가 그 출력을 OpenAI 호환 tool_calls 형식으로 바꿔 줘요.
MCP(모델 컨텍스트 프로토콜)를 붙일 수 있냐도 흔한 질문이에요. MCP는 프로그램끼리 툴 콜을 표준 형식으로 주고받게 하는 어댑터 규약이에요. 툴 콜을 잘 출력하는 모델이면 이 규약에 붙일 수 있어요.
직접 돌려 보기: 서버, 노트북, 폰
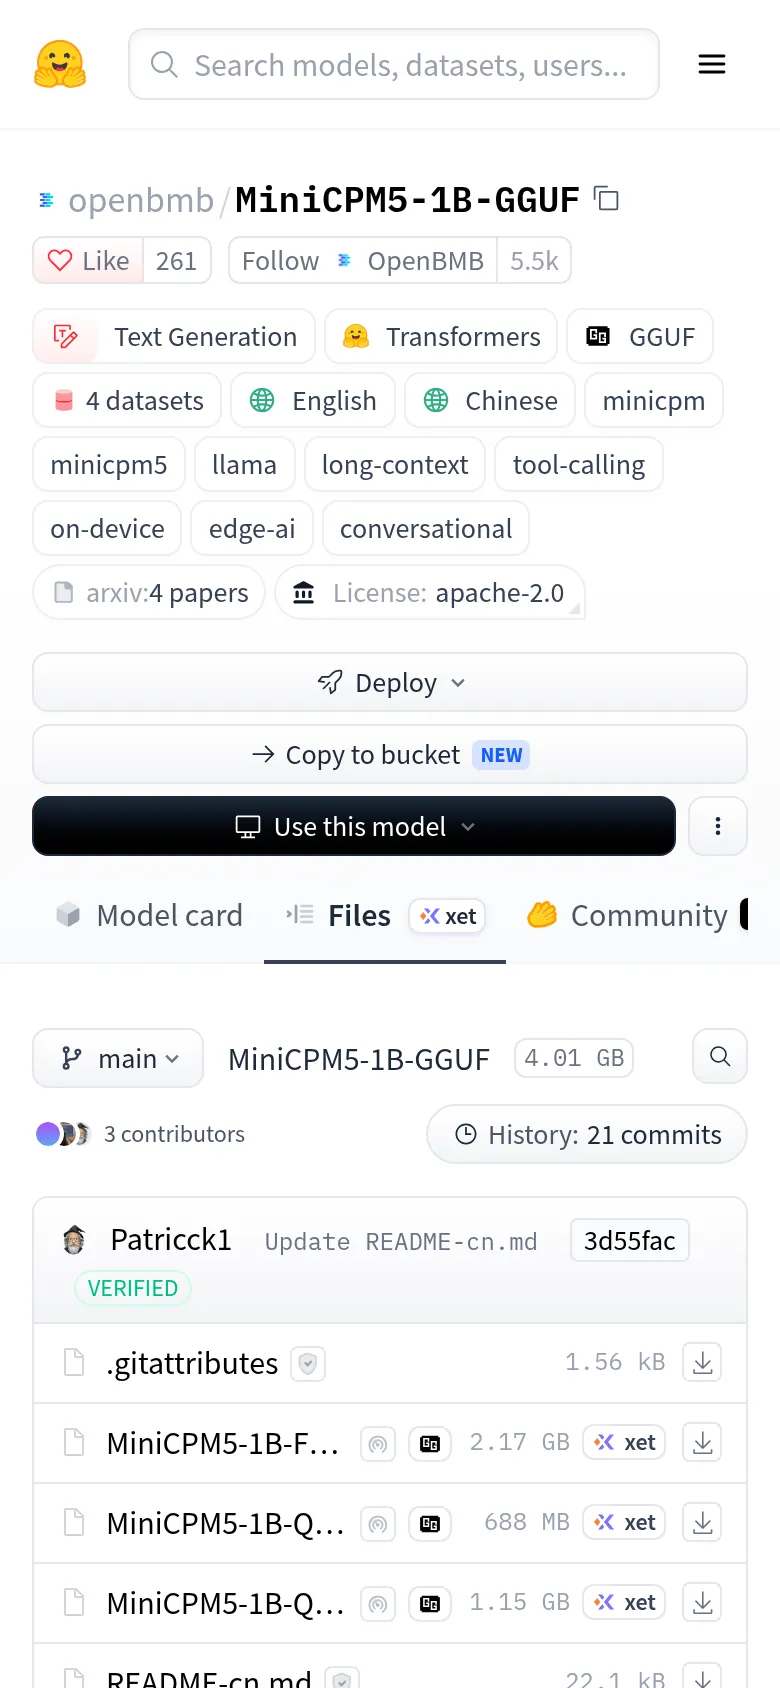
가중치는 용량별로 골라 내려받을 수 있어요. 원본은 약 2.2GB이고, 널리 쓰는 4비트 양자화(GGUF Q4_K_M)는 688MB이에요(공식 GGUF 리포의 파일 목록, 2026-10-08 확인). 공식 리포는 Transformers·vLLM·SGLang·llama.cpp·Ollama·LM Studio·MLX·LiteRT-LM·ArcLight까지 아홉 갈래 백엔드마다 튜토리얼 문서를 붙여 두었어요.
GPU 서버: vLLM · SGLang
NVIDIA GPU 환경에서는 패키지 설치 한 줄로 OpenAI 호환 서버를 띄울 수 있어요.
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-1B --port 8000
툴 콜링은 SGLang을 백엔드로 쓰는 게 공식 권장이에요. 서버를 띄울 때 --tool-call-parser minicpm5 옵션을 붙이면 툴 콜이 표준 API 응답으로 나와요.
노트북·데스크톱: Ollama · LM Studio · MLX
Ollama의 공식 모델 라이브러리에는 아직 등록돼 있지 않아서(2026-10-08 확인), GGUF 파일을 내려받아 Modelfile로 등록하는 절차를 거쳐야 해요. LM Studio는 같은 GGUF를 데스크톱 앱 안에서 바로 열 수 있어요. 애플 실리콘 맥이라면 MLX 4비트 버전(약 0.61GB)이 가장 가벼운 선택이에요.
폰: LiteRT-LM
LiteRT-LM은 구글이 만든 온디바이스 실행 환경(TensorFlow Lite의 후속 계열)이에요. 공식 커뮤니티 리포에는 변환된 1B int4 번들(0.79GB)이 올라와 있고, 같은 번들이 안드로이드와 iOS, 데스크톱, 라즈베리파이에서 CPU와 GPU로 모두 동작해요. 문서 작성 과정에서 갤럭시 S26에서의 안드로이드 동작 확인 기록도 남아 있어요.
모델과 함께 공개된 것들
데스크톱 펫
MiniCPM-Desk-Pet은 MiniCPM5-1B가 로컬에서 구동되는 데스크톱 펫이에요. 내부적으로는 llama.cpp가 GGUF를 로컬 서버로 띄우고, 펫용 UI가 그 API를 쓰는 구조예요. Cursor·Claude Code 같은 코딩 에이전트와 연동되며, LoRA(가벼운 부가 튜닝 체크포인트) 교체로 펫의 성격도 바꿀 수 있어요.
학습 데이터 세트
모델뿐 아니라 학습 데이터도 공개됐어요. 1B 모델과 함께 웹 데이터(Ultra-FineWeb 계열)·수학 데이터·후행 학습용 SFT 데이터가 나왔고, 이후 발표에서는 등급별 코드 데이터와 에이전트 지시 50만 건, 검증 가능한 RL 데이터 8만 건 이상까지 시리즈 전체 묶음으로 공개했어요. 소형 모델을 이 정도까지 끌어올린 비결은 결국 데이터 관리였다는 뜻이에요.
한계와 활용 방법
기억해 둘 한계도 있어요. 어려운 지식 문제와 다국어 지시 이행 항목에서는 같은 크기 경쟁 모델이 앞서고, 공식 우위는 비교 세트 기준 기록이라는 점도 기억해야 해요. 그뿐만 아니라 1B라는 작은 몸집인 만큼 착각·오류도 잦아서, 모델 카드는 고위험 상황의 출력을 사람이 직접 검증하라고 권고해요.
그럼에도 쓸모가 분명한 자리가 있어요. 클라우드에 올리기 곤란한 개인 문서를 폰 안에서 요약하는 일, 비행기처럼 인터넷 접속이 불안한 상황의 보조 질의응답, 토큰 비용이 전혀 나오지 않는 내부 프로토타이핑이 그런 자리예요.
시작 순서는 맥·노트북에서 688MB짜리 GGUF를 Ollama나 LM Studio로 돌려 보고, 속도와 배터리가 수용 가능하면 LiteRT-LM 번들로 폰에 옮기는 게 가장 무난해요. 폰에서 완전히 도는 AI 에이전트는 아직 초기 단계지만, 0.6GB대 모델이 벤치마크 정상권에 올라온 건 그 가능성을 실측으로 바꿔 놓은 변화예요.
이 글의 내용은 아래 자료를 기준으로 2026-10-08에 직접 접속해 확인했어요. 화면 캡처는 정리 시점에 직접 찍은 것이에요.
- OpenBMB/MiniCPM GitHub 리포 (README: 시리즈 소개·스펙·평가표·배포·툴 콜링)
- openbmb/MiniCPM5-1B 모델 카드 (Hugging Face) (스펙·하이브리드 추론·툴 콜링·데스크톱 펫·라이선스)
- openbmb/MiniCPM5-1B-GGUF 리포 (Hugging Face) (양자화별 파일 크기)
- openbmb/MiniCPM5-1B-MLX 리포 (Hugging Face) (맥용 4비트 파일)
- MiniCPM5-1B 배포 문서·Ollama 요리책 (GitHub) (Ollama 등록 절차·양자화 표)
- MiniCPM5 LiteRT-LM 배포 문서 (GitHub) (폰 번들 크기·기기 테스트 기록)
- litert-community/MiniCPM5-1B 리포 (Hugging Face) (1B int4 번들 0.79GB)
- google-ai-edge/LiteRT-LM 리포 (GitHub) (온디바이스 런타임 성격)
- Thinking Machines 블로그: On-Policy Distillation (후행 학습에 쓰인 증류 기법 원 출처)
- Modelbest(면벽지능) 공식 사이트 · THUNLP (개발 기관)
- Instagram 게시물 (릴스, 조사 계기) (원문 링크 보유)