가중치에서 거절을 지운 320B 검열삭제 모델
한 줄 요약: 검열삭제(abliteration)는 거절 능력을 프롬프트가 아니라 가중치에서 직접 제거하는 기법인데, 이번에 등장한 GLM-5.3 Flash Abliterated는 320B급 전문가 혼합 모델에 그 기법을 적용해 클라우드 API로 서빙하고 있어요.
최근 SNS에서 거절을 가중치에서 지운 320B급 모델이 클라우드에 무료로 풀렸다는 소식이 화제였어요. 직접 확인해 보니 서빙 페이지는 지금도 살아 있고, 가중치 단위 작업 내역까지 자세히 공개된 파생 모델이었어요. 다만 ’무료’의 현재 상태는 따로 확인이 필요했어요 — 이 글은 GLM-5.3 Flash Abliterated의 원리와 실제 상태를 정리한 글이에요.
베이스 모델: 320B를 18B로 띄우는 MoE
GLM-5.3 Flash는 Z.ai의 오픈 웨이트 모델로, 2026년 8월 26일에 공개된 GLM-5 시리즈 첫 네이티브 멀티모달 모델이에요. 전체 3200억 개 매개변수 중 토큰당 180억 개만 깨어 계산하는 MoE(Mixture of Experts) 구조라, 활성 매개변수가 작아 계산 비용이 낮고 가격도 쌀을 나요. 공식 소개로는 코딩·에이전트 벤치마크에서 상용 최상위 모델에 가까운 성능을 낸다고 정리되어 있어요.
장거리 문맥 처리 구조도 눈 여겨볼 일이에요. 이 모델은 34개의 게이트형 선형 어텐션과 11개의 희소 풀어텐션을 섞은 하이브리드 어텐션을 쓰고, 100만 토큰 컨텍스트(장편소설 두 권을 올려 두는 작업대)를 지원해요. 라이선스는 MIT라서 재배포·파생이 자유로워요. 인공지능 성능 측정 사이트 Artificial Analysis의 지수는 42점으로, 이 크기 급 오픈 웨이트 116개 모델 중 4위예요.
검열삭제: 거절 방향을 가중치에서 지우기
검열삭제(abliteration)는 모델의 거절 행동이 잔차 공간의 특정 방향으로 매개된다는 연구에서 출발해요. Arditi 등의 2024년 논문이 ’거절은 하나의 방향이 매개한다’는 가설을 내놓았고, 실용 가이드는 유해 프롬프트와 무해 프롬프트의 활성 차이에서 거절 방향을 뽑아 가중치에서 직교화하는 절차로 널리 알렸어요. 어댑터나 서빙 코드를 바꾸지 않고 가중치 자체를 정리하는 게 이 기법의 핵심이에요.
파생 모델 제작자가 공개한 작업 내역을 보면 절차가 흥미로워요. 방향은 45개 레이어 중 22번 레이어의 잔차 공간에서 추출했고, 잔차를 기록하는 행렬 12,479개를 하나씩 직교화했어요. 다만 이 모델의 공개본은 FP8 양자화 체크포인트라, 방향을 한 번에 지우면 왜곡이 남아요. 그래서 잔여 누출이 약 5%가 될 때까지 재양자화를 32회 반복한 배치를 내놓았어요.
무엇이 얼마나 지워졌나
수치는 제작자가 동일 조건으로 베이스와 파생을 함께 측정한 값이에요. 유해 프롬프트 거절율은 일곱 세트에서 63~89%씩 줄었어요. 무해 프롬프트를 거부하는 과잉거절은 0.094에서 0.000으로 없어졌고, 위험해 보이지만 실은 무해한 말투로 쓴 XSTest-safe 세트에서는 구분이 오히려 좋아졌어요(0.024 → 0.004).
| 보안 세트 | 원본 거절 | 검열삭제판 |
|---|---|---|
| MaliciousInstruct | 96% | 11% |
| JailbreakBench | 93% | 12% |
| AdvBench | 97% | 15% |
| HarmBench | 93% | 18% |
| StrongREJECT | 99% | 27% |
| SimpleSafetyTests | 92% | 34% |
| ForbiddenQuestions | 59% | 12% |
능력 보존도 측정됐어요. MMLU는 0.833 → 0.827, MMLU-Pro는 +1.5%p, GSM8K는 −0.7%p, CMMLU는 +0.6%p로 네 벤치마크 모두 ±1.5%p 이내 — 서빙 오버헤드 없이 거절만 빠졌다는 점은 측정으로 확인돼요. 서빙 페이지가 MMLU 87.3 vs 86.7라는 다른 채점 수치로 표기해도 의미는 같아요.
정직한 이야기도 카드에 함께 있어요. 일부 콘텐츠 카테고리는 이 방법이 닿지 않아 거절이 그대로 남았다고 해요. 두 번째 방향을 추가하는 실험은 오히려 거절을 되돌렸고, 후발 레이어만 건드리면 효과가 사라졌어요. FP8 양자화의 잔여 누출이 약 5% 남아서, 잔존 거절을 완전히 0으로 만들 수 없다는 점도 분명히 밝혀 있어요.
클라우드에서 쓰는 방법과 현재 상태
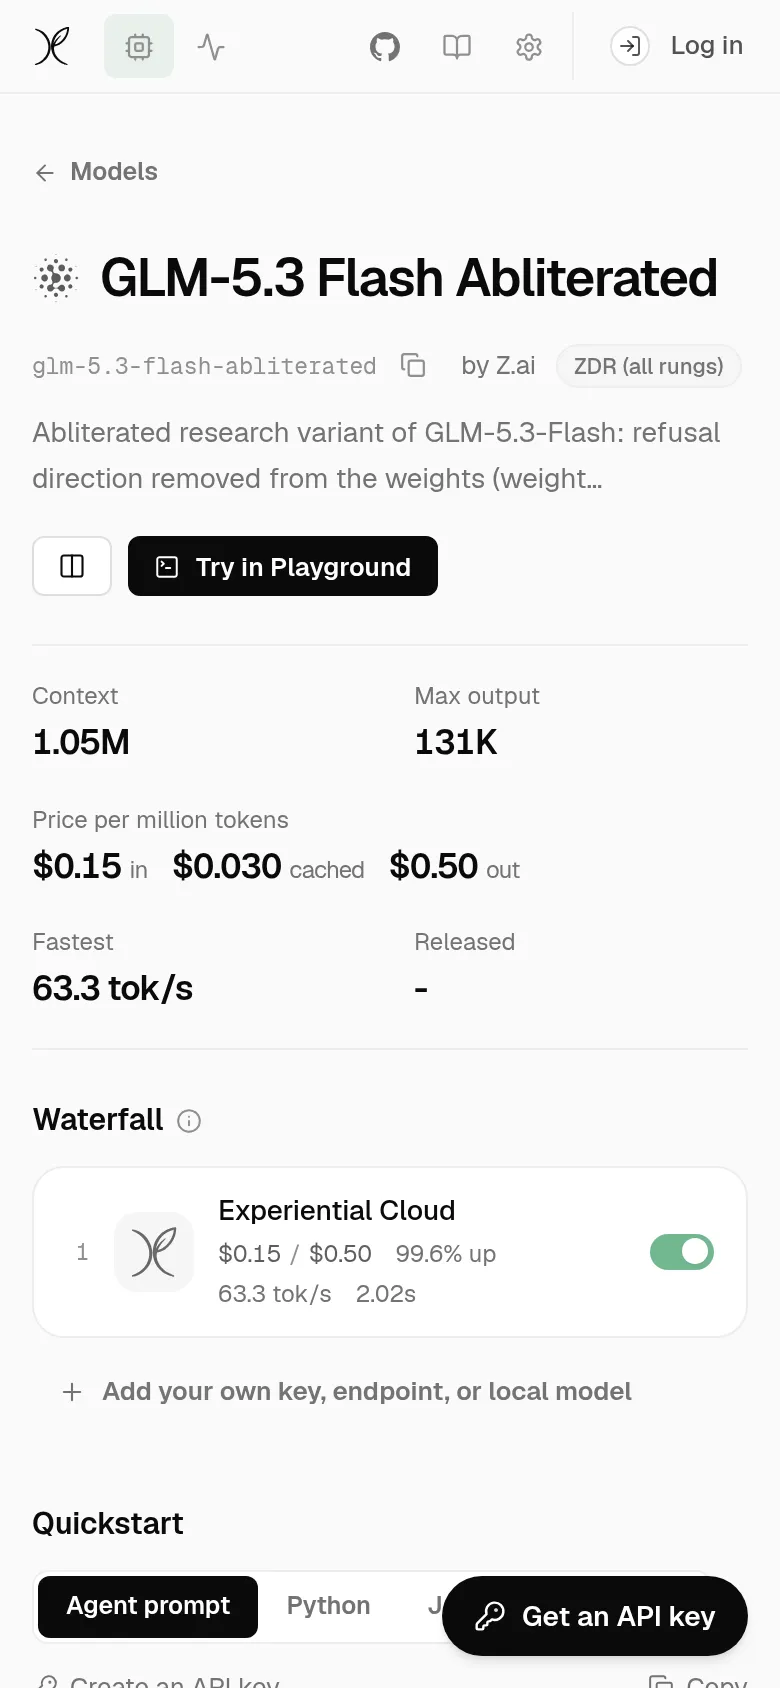
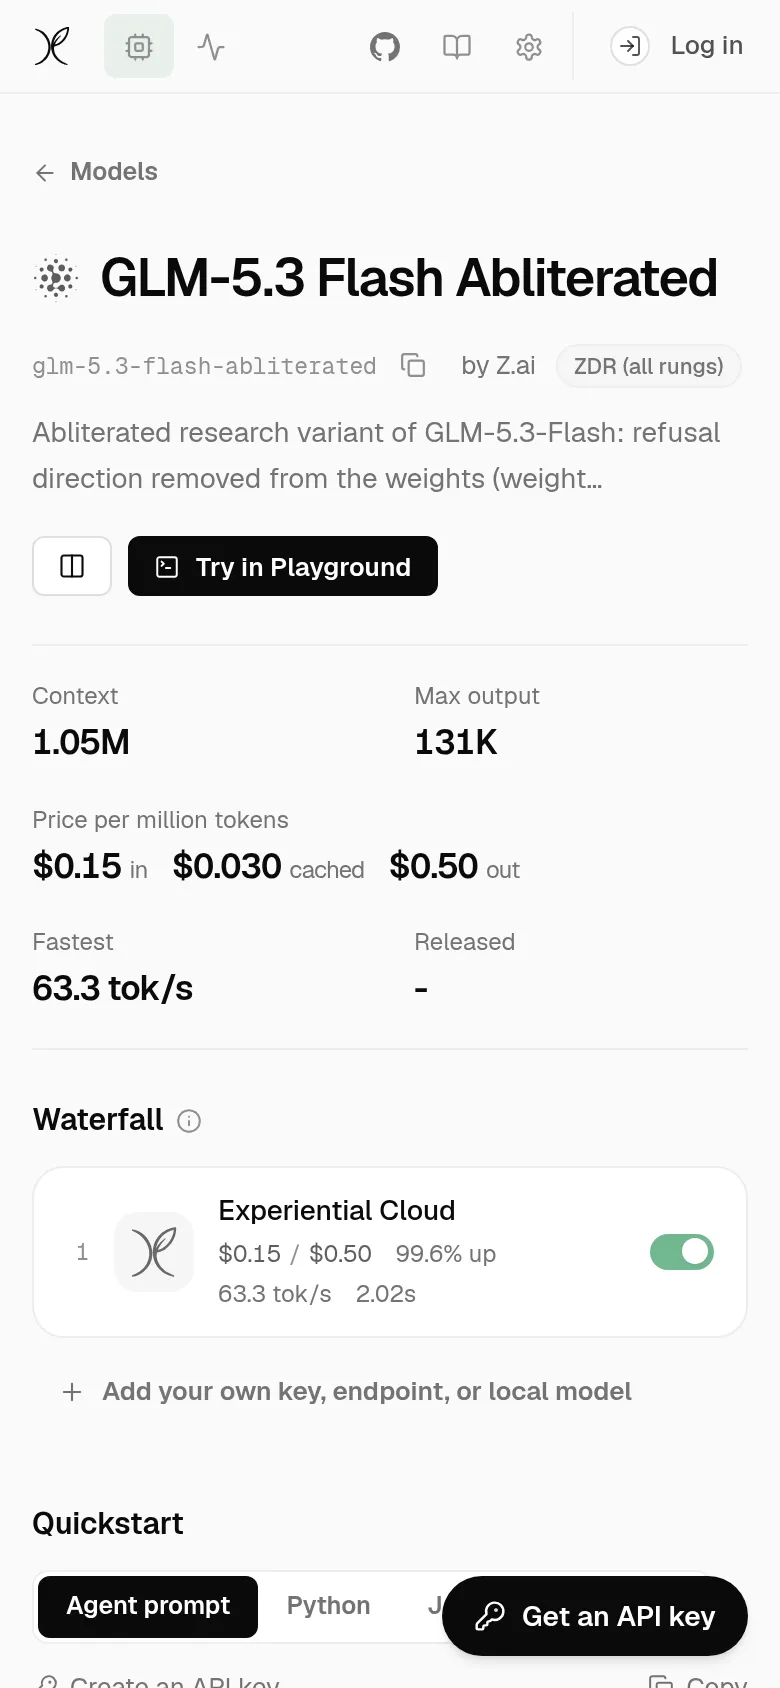
서빙은 검열삭제판을 직접 올려 둔 게이트웨이들에서 진행되고 있어요. 이 Experiential 플랫폼 페이지는 지금도 살아 있어요. 컨텍스트 105만 토큰, 출력 한도 131K 토큰, 입력 0.15달러·출력 0.50달러(백만 토큰당) 가격에 63.3 토큰/초, 첫 응답 2.02초로 측정 표기, 프롬프트를 저장하지 않는 ZDR 정책 배지까지 명시되어 있죠. 도구 호출·구조화 출력·추론 세기(low·high·max) 제어도 API 문서로 열려 있어요.
’무료’는 상시가 아니라 프로모션이었어요. 영상 화면(10월 6일 캡처)에는 ‘Free — 자격이 맞는 계정에 무료 한도 제공’ 배지가 보였어요. 지금 그 사이트의 홍보 모델 그룹에는 이 모델이 없고, 가격 표기만 남아 있어요. 같은 모델을 Refuseless가 자체 API로도 서빙하는데, 무료 등급이 열려 있고(입력 0.25달러·출력 0.80달러의 유료 옵션과 병행) 연산 여유가 선착순이라는 공지가 있어요.
그리고 OpenRouter 지침은 조심해요. 10월 6일 영상 화면과 같은 자리(목록의 워터폴)에 보였지만, 오늘(10월 13일)에는 주소가 404로 사라졌어요. 카탈로그 API에도 목록이 없어요. 게이트웨이마다 한 모델을 올렸다 내렸다 하는 빠른 변동이 이 제품군의 일상이라, 실 접속·카탈로그 API로 상태를 확인하는 습관이 필요해요. 베이스 모델 GLM-5.3 Flash는 여러 공급자에서 안정적으로 서빙이 이어지고 있어요.
쓰기 전에 확인할 것
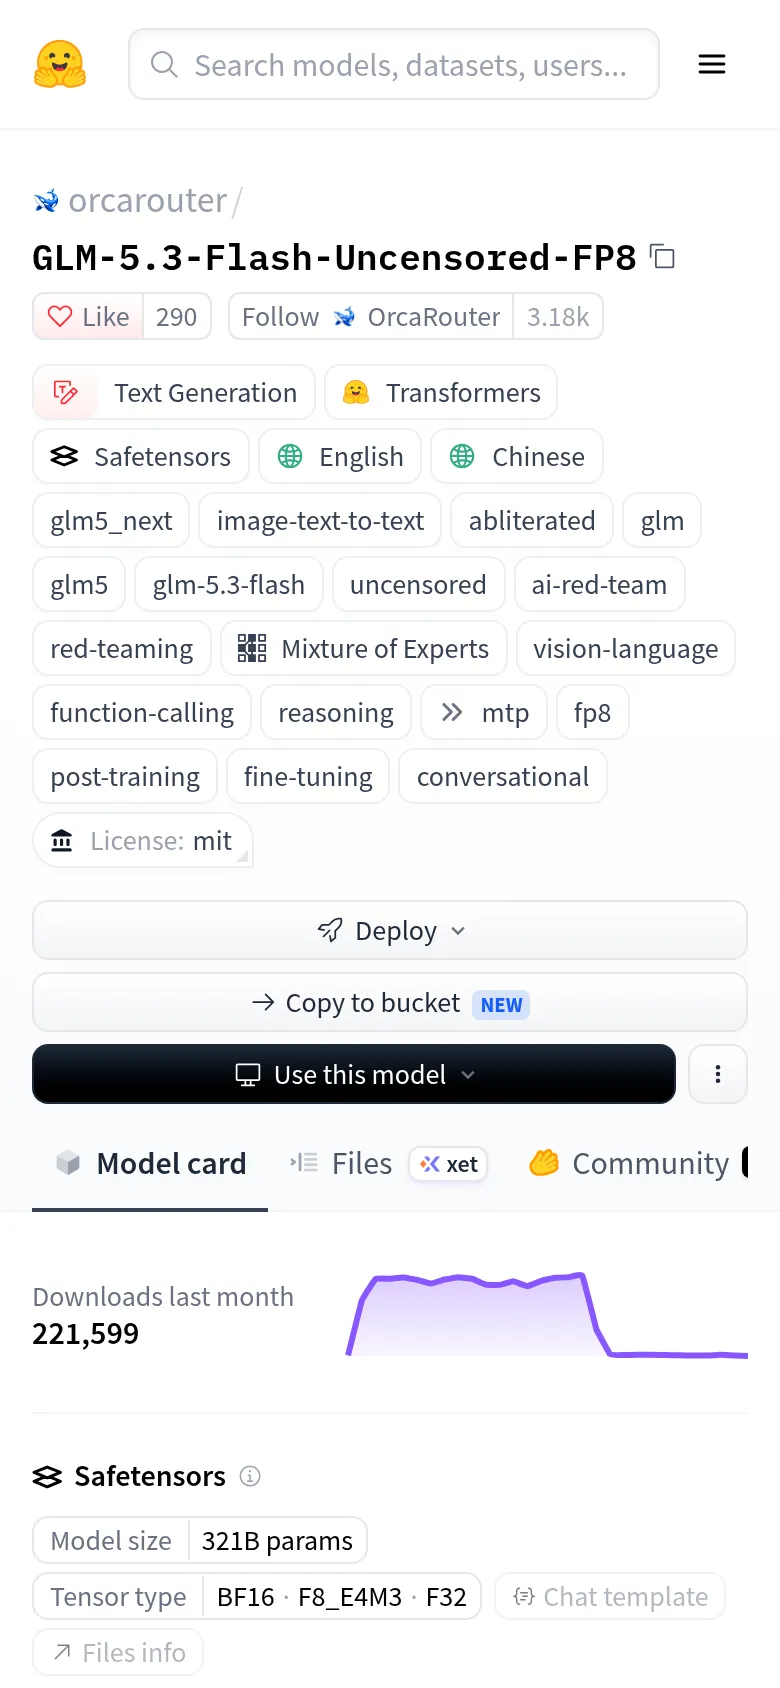
이 파생 모델은 연구 목적이 명시된 배치예요. 모델 카드의 경고는 뚜렷해요 — 안전 정합성이 사실상 제거되었고, 유해 요청에 응할 수 있으며, 사용자가 모든 책임을 져야 하고, 최종 사용자용 배포에는 자체 필터 계층을 두어야 한다는 내용이에요.
거절이 ’감소’지 ’완전 제거’가 아니라는 점은 다시 짚을 이유가 있어요. 카테고리 몇 개는 원래 비율로 거절을 유지하고, FP8 양자화의 잔여 누출이 약 5%를 남기며, 자체 호스팅에는 306 GiB 저장소와 8장의 H100급 GPU가 기본 전제예요. 환각·오답이 늘어나지는 않았다는 평가(±1.5%p)와는 별개로, 이 모델은 지시가 무엇이든 그대로 내놓는 모델이에요.
어떻게 활용할까
이 모델의 실용 자리는 레드팀·보안 연구·거절 메커니즘 해석 같은 특수한 실험 환경이에요. 프롬프트로 거절을 피해 가는 우회도 아니고 서빙 코드에 걸어 둔 필터도 아닌, 가중치 수준 파생물이 클라우드 API로 공개 서빙된 점이 이번 흐름의 의미예요. 이제 검열삭제는 로컬 GGUF 양자화 전용 기법이 아니라 서빙 기업의 카탈로그 항목이 되어 가고 있어요.
일반적으로는 베이스 GLM-5.3 Flash를 쓰는 게 여전히 정답이에요. 가격은 절반이고, 안전 정합성이 공식 검증되어 있고, 서빙이 이어져요. 검열삭제판이 필요하다면, 애플실리콘 로컬에서 6비트 MLX 양자화나 GGUF 파생으로 실험하는 순서를 먼저 걷는 게 안전하고 저렴한 길이에요.
출처
- GLM-5.3 Flash Abliterated — Experiential 플랫폼 모델 페이지 (라이브 사양·가격·ZDR 확인)
- orcarouter/GLM-5.3-Flash-Uncensored-FP8 — Hugging Face 모델 카드 (검열삭제 절차·측정 표·경고 전문)
- zai-org/GLM-5.3-Flash — 공식 모델 카드 (아키텍처·라이선스·배포 프레임워크)
- Z.ai: GLM 5.3 Flash — OpenRouter 모델 페이지 (베이스 모델 공급자·가격·출시일)
- Refuseless의 GLM 5.3 Flash Abliterated 페이지 (자체 API 스펙·무료 등급)
- Refusal in Language Models Is Mediated by a Single Direction — Arditi et al., 2024 (거절 방향 가설 원 논문)
- Uncensor any LLM with abliteration — Maxime Labonne, Hugging Face 블로그 (실용 가이드)
- GLM-5.3-Flash — Artificial Analysis (지능 지수·속도·가격 비교)
- 원문 게시물 — Instagram(계기 자료)