[기술 딥다이브] 8B 모델이 오퍼스 4.5를 따라잡은 방법
한 줄 요약: Meta와 UIUC의 에보하네스-RL(EvoHarness-RL)은 에이전트가 도구·메모리·상태 관리 — 이른바 하네스 — 를 쓰는 법까지 스스로 학습하게 만들어, 규모가 작은 8B 공개 모델이 클로드 오퍼스 4.5 수준의 장기 작업 성능에 도달하게 했어요.
AI타임스가 보도한 이 연구는 Meta와 일리노이대학교 어배너-샴페인(UIUC) 연구진의 논문 “EvoHarness-RL: Learning Self-Evolving Runtime Harness for Long-Horizon LLM Agents”(arXiv 2608.05446, 2026년 8월 5일 공개)예요. 저자 가운데 UIUC의 Jingrui He·Hanghang Tong 교수와 Meta AI 소속 연구진이 다수 포함되어 있어요. 핵심 주장은 한 문장으로 압축돼요. 에이전트를 둘러싼 외부 지원 체계, 이른바 **하네스(harness)**의 사용법을 사람이 규칙으로 짜주는 대신, 에이전트가 스스로 학습하는 정책으로 만들자.
하네스란: 에이전트의 외부 실행 계층
에이전트가 수시간에 걸친 장기 작업을 수행하려면, 대화형 AI처럼 하나의 컨텍스트 창에 모든 정보를 담는 방식만으로는 부족해요. 예컨대 수시간에 걸쳐 고객 데이터를 CRM에서 클라우드 데이터베이스로 옮기는 작업이라면, 서버 로그, API 연결 상태, 완료·미완료 작업, 오류 내역을 계속 관리해야 해요. 논문은 이런 외부 실행 계층 전부를 하네스라고 부어요. 프롬프트 스캐폴드, 도구, 메모리, 상태 추적기, 검증기, 실행 피드백, 제어 흐름까지가 하네스의 구성원이에요.
장기 작업에서는 이 외부 지원이 세 가지 실패를 막아 줘요. 환경에 대한 현재 이해를 잃지 않기, 하위 목표의 진행 상황을 추적하기, 이전 경험을 재사용하기. Anthropic의 엔지니어링 블로그도 장기 실행 에이전트에 효과적인 하네스를 다룬 바 있을 만큼, 요즘 에이전트 엔지니어링의 중심 논의예요.
사람이 짠 규칙의 한계
문제는 지금까지 하네스 사용법 대부분을 사람이 설계했다는 점이에요. 개발자가 “이런 상황에서는 메모리를 조회하고, 이 작업이 끝나면 상태를 기록하고, 오류가 나면 이 도구를 써라”라는 규칙을 일일이 만들어요. 논문은 이 방식을 프롬프트·휴리스틱·도메인 규칙 의존이라고 요약하며 두 가지 한계를 어요.
첫째, 규칙이 도구 사용을 가능하게는 하지만 도구 사용 자체를 의사결정 문제로 학습시키지는 못해요. 둘째, 모델이 바뀔 때마다 프롬프트·메모리 구조·권한·샌드박스 설정을 다시 맞춰야 해요. 게다가 과거 정보를 계속 덧붙이는 누적형 메모리는 오히려 독이 될 수 있어요. 이미 틀린 결론, 실패한 시도, 무관해진 정보가 쌓이면 에이전트의 판단을 방해해요.
BPE: 세 상태, 네 행동
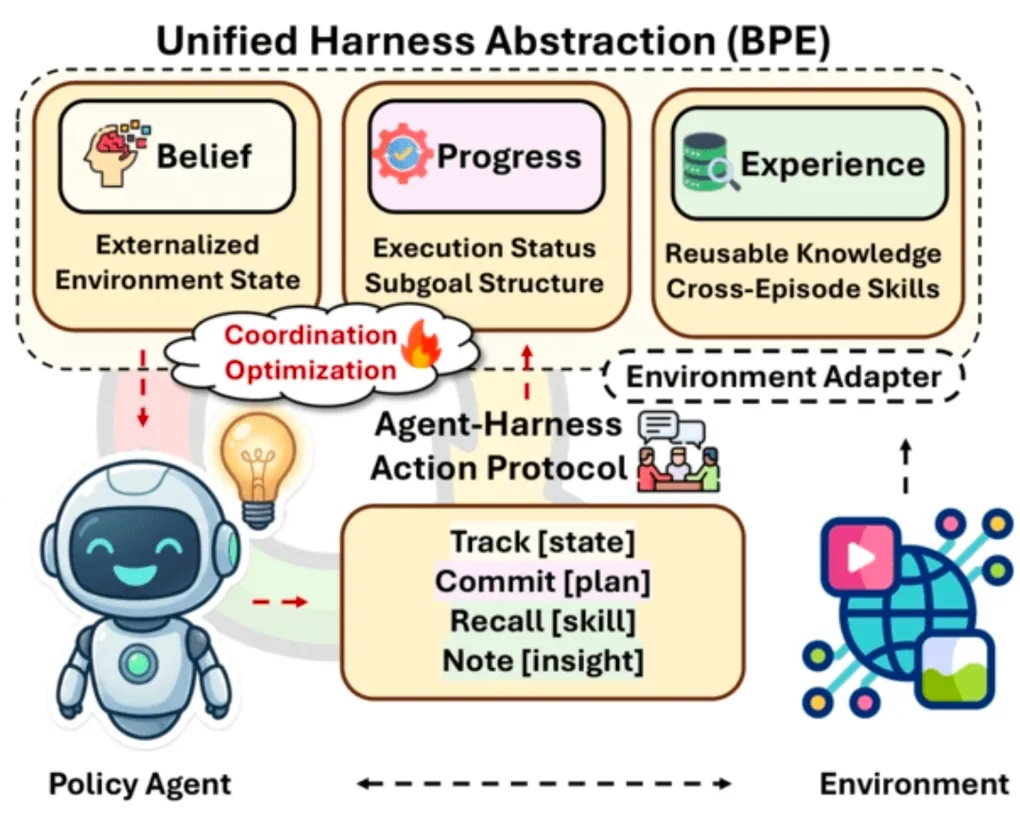
에보하네스-RL의 접근은 복잡하고 서로 다른 하네스 구성요소를 BPE(Belief·Progress·Experience) 세 가지 상태로 추상화하는 것이에요. **신념(Belief)**은 환경에 대해 현재 아는 것, **진행(Progress)**은 완료했고 남아 있는 하위 목표, **경험(Experience)**은 이전 작업에서 얻은 기술과 실패 사례 같은 재사용 가능한 지식이에요. 에이전트가 이 공간과 상호작용하는 방법은 네 가지 메타 행동으로 단순화돼요. **트랙(track)**은 환경 상태를 확인하고, **커밋(commit)**은 진행 상황을 기록하며, **리콜(recall)**은 과거 경험을 검색하고, **노트(note)**는 새로 발견한 정보를 기록해요. 볼트나 데이터베이스처럼 도메인별로 제각각인 하네스 내부와 무관하게, 같은 정책 인터페이스로 다룰 수 있게 돼요.
학습: 모방 다음에 보상
여기서 끝내면 “BPE를 제공하는 프레임워크” 수준이지만, 이 연구의 핵심은 하네스 사용법까지 학습시킨 점이에요. 1단계는 지도학습 하네스 미세조정(SFT)이에요. 클로드 오퍼스를 교사로 삼아 성공 경로를 수집하고(500개 게임 중 성공 87개, 다음 행동 대화쌍 1,153개), 큐원3-8B(Qwen3-8B)가 BPE의 의미와 네 행동을 익히게 해요. 2단계는 비용 인지 GRPO 강화학습이에요. 하네스 조작도 환경 행동과 같은 상호작용 예산을 소비하기 때문에, 무조건 메모리를 조회하지 말고 확인이 실제로 가치 있는지 판단하도록 학습시키는 것이에요. 보상에는 작업 성공 외에 효율성, 행동 다양성(학습 초반에만 강하게, 이후 서서히 줄어드는 커리큘럼), 반복 회피, 올바른 형식이 반영돼요.
결과: 96.9%, 오퍼스와 나란히
텍스트 기반 가정 내 작업 벤치마크 ALFWorld의 결과가 이 흐름을 그대로 보여줘요. 기본 ReAct 방식의 큐원3-8B는 평균 성공률 47.9%에 그쳤지만, BPE 하네스만 제공한 추론 단계에서 56.4%, SFT까지 적용해 68.6%, SFT와 GRPO를 결합한 에보하네스-RL은 **96.9%**를 기록했어요. 클로드 오퍼스 4.5의 ReAct 성능 96.4%와 사실상 같은 수준이며, SkillOS(80.2%)·SkillRL(89.9%) 같은 경쟁 학습형 방법도 앞서요.
BPE의 효과는 프론티어 모델에서도 확인돼요. 별도 학습 없이 추론 단계에서 BPE 하네스만 제공해도 GPT-4.1은 47.9%에서 70.0%로(+22.1%p), GPT-5는 60.7%에서 85.0%로(+25.7%p) 올라갔고, 오퍼스 4.5도 96.4%에서 98.5%로 개선됐어요. 또 세 상태 중 하나만 빼도 성능이 무너져요. Belief를 빼면 상태 추적이 어려워지고, Progress를 빼면 하위 목표가 이어진 작업에서 길을 잃고, Experience를 빼면 평균 48.6%로 떨어져요. 세 요소가 독립적인 메모리 기능이 아니라 서로 보완하는 통합 상태 인터페이스라는 뜻이에요.
두 가지 동태: 어닐링과 진화
학습 과정에서 두 가지 흥미로운 현상이 관찰됐어요. 첫째는 **하네스 어닐링(harness annealing)**예요. 초기에는 에이전트가 거의 모든 단계에서 하네스를 확인했지만, 학습이 진행되며 반복적 작업 방식이 모델 내부에 자리 잡자 호출이 급감해 에피소드당 약 한 번으로 안정화됐어요. 행동별로는 recall이 가장 오래 남았고(외부 경험이 계속 가치 있음), commit·note는 빠르게 0으로 줄었어요. 둘째는 **하네스 진화(harness evolution)**예요. Experience 저장소는 처음에 일반 기술·작업별 절차·실수 사례·검색 우선순위를 빠르게 쌓다가, 학습이 진행되며 중복을 통합하고 활용도 낮은 항목을 제거해 작고 적응적인 저장소로 다듬어졌어요.
논문의 주전자 사례가 이 자기교정 루프를 잘 보여줘요. 과거 경험에는 조리대에 주전자가 있었다고 저장돼 있었지만, 조리대를 여러 번 확인해도 없자 에이전트는 맹목적으로 따르지 않고 다른 위치를 탐색했고, 스토브에서 주전자를 찾아 “과거 정보가 틀렸다”는 메모를 새로 기록했어요. 기억을 참고하되 현재 환경과 충돌하면 수정하는 구조예요. 학습에 쓰이지 않은 ALFWorld 작업에서도 ReAct 50.0% → BPE 추론 77.6% → 에보하네스-RL 86.6%로 일반화됐고, SFT만으로는 새 환경의 하네스 사용을 충분히 조정하지 못한 반면, 비용 인지 GRPO가 이를 보완했다고 분석했어요.
어디에 쓸 수 있나
적용은 도구 교체가 아니라 계층 추가예요. 환경 어댑터를 통해 조직마다 다른 내부 도구와 상태 관리 방식을 유지하면서 BPE라는 학습 가능한 조정 계층을 얹을 수 있어요. 소프트웨어 개발이라면 Belief에 현재 코드베이스와 구성요소 상태, Progress에 완료된 작업과 테스트·의존성·미완료 항목, Experience에 과거 해결책과 오류 사례를 두는 식이에요. 금융·컴플라이언스라면 현재 적용 규정과 증거가 Belief, 완료된 점검과 미해결 예외가 Progress, 반복 문제와 과거 대응이 Experience가 돼요. 내부 구현은 도메인마다 달라져도 정책 계층은 공유하는 구조예요.
어떻게 연결되는가
한 줄로 요약하면: 에이전트 설계에서 사람이 짜던 하네스 규칙을 학습 대상으로 승격시킨 것이 에보하네스-RL이고, 그 덕에 작은 모델이 좋은 하네스를 갖춘 큰 모델과 나란히 갈 수 있게 됐어요. 프롬프트·메모리·도구 구성이 모델별로 다르게 필요하다는 문제를, “하네스 사용 정책 자체를 학습”으로 풀었다는 점에서 소프트웨어 엔지니어링이 학습 문제로 옮겨온 사례예요. 같은 시기에 HarnessX·SkillOS·SkillRL처럼 하네스와 기술 관리를 다루는 연구가 잇달아 나오는 것을 보면, 에이전트의 다음 경쟁 지점은 모델 크기만이 아니라 하네스 좌표계를 어떻게 학습하느냐로 옮겨 가고 있는 것으로 보여요.
출처:
- 메타, 8B 모델로 ‘오퍼스 4.5’ 성능 구현한 ‘에보하네스-RL’ 공개 — AI타임스
- EvoHarness-RL: Learning Self-Evolving Runtime Harness for Long-Horizon LLM Agents — arXiv 2608.05446 (UIUC · Meta AI)
- Effective Harnesses for Long-Running Agents — Anthropic Engineering Blog (2025-11)
그림: arXiv 2608.05446 Figure 1 (EvoHarness-RL 개요)